2026年10月30日星期五
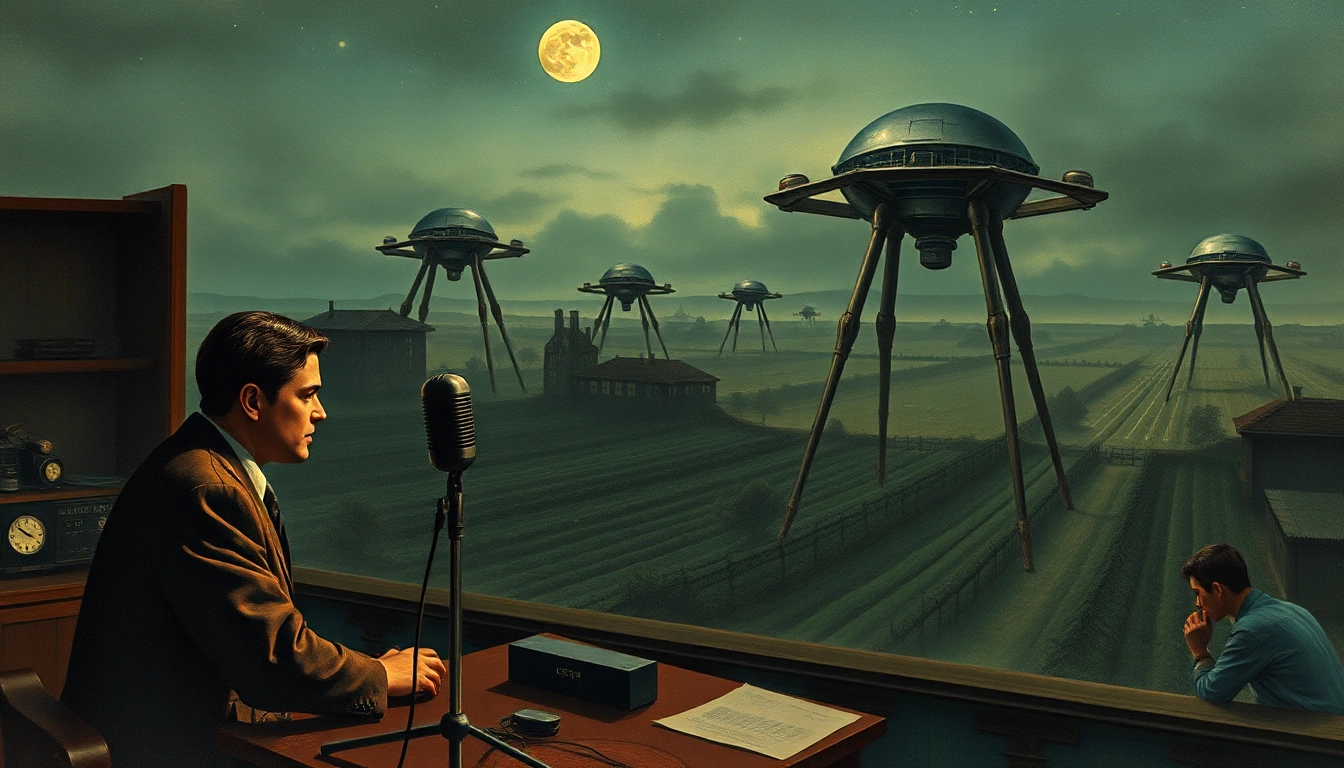
奥逊·威尔斯广播剧《世界大战》播出(1938)
历史上的今天
1938年:奥逊·威尔斯(Orson Welles)的广播剧《世界大战》播出 — 10 月 30 日万圣节前夜,23 岁的奥逊·威尔斯带着水星剧团在哥伦比亚广播公司(CBS)把 H. G. 威尔斯(H. G. Wells)的小说改成一连串”新闻快报”,播报火星人降落在新泽西州的农田。第二天的报纸满是”全国大恐慌”的标题,这个故事此后被当成”媒体能让人信以为真”的教科书案例;但后来的多数研究认为,当晚收听这个节目的人本来就很少,真正惊慌的是少数,恐慌被放大,很大程度上是因为报纸正和抢走广告的广播打擂台。
中共五中全会闭幕:创纪录开除 33 名成员,其中 16 人来自军队;到会只有 279 人,是习近平执政 14 年来首次低于 300 人
Source · BBC · 2026-10-30 · link
Why this — 这是看明年党代会前的一张”点名册”:缺席的座位一次比一次多,被清掉的人里有前军委副主席和前新疆一把手,说明反腐已经从惩治腐败变成习近平巩固权威的日常手段。
为期四天的中共中央委员会第五次全体会议周四闭幕。公报说,会上 33 名成员被开除党籍,创下纪录,其中 16 人来自军队,具体罪名只有”严重违纪违法”这种套话。到会的中央委员是 279 人:去年 10 月四中全会是 315 人,2024 年 7 月三中全会是 364 人;本届中央委员会 2022 年上任时有 370 多人。习近平掌权 14 年来,全会出席人数第一次跌破 300。
被点名的有前新疆党委书记马兴瑞、前中央军委副主席张又侠、前高级将领刘振立,还有 2025 年 7 月起不再公开露面的前外交官刘建超。七人的中央军委现在只剩两人:主席习近平和副主席张升民;张升民在这次全会上升进政治局,政治局从曾经的 24 人缩到 21 人后,回到 22 人。习近平第三个任期里被清除的中央委员已有 51 名,第一、第二任期分别是 35 人和 5 人。纪委另说,今年前九个月全国有 68 万人受到党纪处分。
卡内基中国中心(Carnegie China)学者郑家恩(Chong Ja Ian)认为,这场运动已经成了”巩固并维持权威的手段”,“继续还是扩大,取决于习近平自己觉得多稳,而不是腐败有多严重”。亚洲协会政策研究所的分析师说,军队高层被清洗的规模”自成一类”,会引出关于指挥体系和战备的疑问。多位分析人士把这次强调纪律(也就是忠诚)和 2027 年的二十一大联系起来:习近平大概率继续留任,他有理由对下一批接班人看得更紧。
谷歌母公司 Alphabet 一天蒸发约 5,000 亿美元市值:自家的“AI 模式”,正在吃掉搜索广告的收入
Source · BBC · 2026-10-30 · link
Why this — 这是市场第一次给”AI 吃掉自己的搜索广告”明确标价;同一周亚马逊的自由现金流转负 420 亿美元,微软的 AI 投入减少,三家大厂的财报把”AI 投资换得回来吗”这个问题摆到了台面上。
Alphabet 周三公布的季度财报显示,截至 9 月的三个月里总收入同比增长 25%,达到 1,276 亿美元,但广告业务低于分析师预期。谷歌首席商务官施林德勒(Philipp Schindler)承认,谷歌的”AI 模式”(用对话方式回答问题)正在抢走传统搜索结果旁边那些广告的钱,不过他说自己对”这条路线的走向很有信心”。周四股价一度跌超 12%,创六个月新低,公司总市值从 3.97 万亿美元掉到 3.46 万亿美元,蒸发 5,000 亿美元出头。
谷歌前广告业务负责人金·斯科特(Kim Scott)对 BBC 说,谷歌”宁愿自己吃掉自己的午餐,也不让别人来吃”,它向来爱押长期技术赌注,哪怕短期自伤。
亚马逊同样挨了打:季度销售额增长 11%,达到 2,010 亿美元,但自由现金流是负 420 亿美元(花的钱比赚的多,三个月里支出涨到原来的六倍),财报后盘后股价跌 6%。CEO 贾西(Andy Jassy)说公司面前有两个有机会做到万亿美元的业务,没点明是哪两个,但反复提到自研芯片和 AI 开发平台 Bedrock(让付费用户调用主流模型)。微软反应平淡,股价跌不到 1%:收入增长 19%,达到 923 亿美元,云业务增长 30% 到 630 亿美元,AI 方面的投资比之前少花了约 50 亿美元,还宣布了裁员计划。分析师说,华尔街现在要看的是:这些巨额投入,最后谁能真正兑现。
西班牙高铁追尾事故死亡人数升至至少 69 人:交通部长普恩特拒绝辞职,距同一条线上的上一次事故只有不到一年
Source · BBC · 2026-10-30 · link
Why this — 一次电脑故障让六列行驶中的火车停下,随后”放行但不限速”的指令酿成事故;这已经不是单个司机的失误,而是调度系统和责任归属的问题,而且它发生在同一条线路的第二次大事故之后。
周三上午,西班牙国铁(Renfe)一列高速列车在托莱多省乌尔达(Urda)附近,撞上了前方静止的、由 Iryo 公司运营的另一列列车的车尾。死亡人数已升至至少 69 人。调查机构周四深夜公布的初步报告说,撞车时 Renfe 列车的时速在 160 到 200 公里之间,车头嵌进了对方的尾部。今年 1 月同一条马德里至塞维利亚线上,阿达穆斯(Adamuz)发生的相撞事故已造成 46 人死亡;首相桑切斯(Pedro Sánchez)说,同样的悲剧一年里出现两次”不可接受”,公众对高铁的信任已经被打破。全国哀悼三天。
交通部长普恩特(Óscar Puente)周五在马德里的记者会上说,上午 8 点半左右一次电脑故障,使包括出事的两列在内的六列行驶中列车先后停下;之后再让它们开动、却没有限速的决定,他称为”无法解释”。西班牙媒体还公开了司机与控制中心在撞车前几分钟的录音,一些议员批评泄露录音”卑劣”。左翼政党”我们能”(Podemos)的蒙特罗(Irene Montero)说,不应该把责任推给某一名工作人员,铁路自由化的风险早就有司机和专家在警告。
要求普恩特辞职的有工会 CSIF、在野的人民党(PP),还有周三晚上在交通部门外抗议的民众。普恩特说:“我现在的责任不是讨论自己该不该留任,而是解决问题""让我走很容易,但那不符合我的性格,也不是首相对我的要求”,并强调不会”拿某个工人当挡箭牌”;如果调查证明有人为失误,会据此处理。
塞尔维亚大选后第四天:学生名单的新议员要求撤换警察、情报和反恐部门负责人,国家电视台台长已经辞职
Source · BBC · 2026-10-30 · link
Why this — 上一期还在问”没有领袖的学生名单能不能赢”,现在它赢了,问题变成:一群没有从政经历的教授、医生和运动员,要在权力交接的几周窗口里,拆掉一个执政十多年的体系,而对手手里还握着警察和情报。
周四,学生名单(Student List)的新当选议员站在议会对面的先驱者公园(Pioneers’ Park),要求立刻开除所有违法的警察,并点名警察总局局长、安全情报局(BIA)和反恐部队的负责人。几天前这里还是武契奇(Aleksandar Vučić)拥护者在他办公室外搭的帐篷营地;周日晚上他承认败选后几小时,营地就被拆了,周一早上志愿者进场清扫。25 岁的米洛瓦诺维奇(Marija Milovanović)一边擦长椅一边说:“这只是第一波春季大扫除。”
这场运动起于 2024 年 11 月诺维萨德(Novi Sad)火车站雨棚坍塌,造成 16 人死亡,学生要求追责并调查腐败。141 名当选者由全国各大学的学生大会,经过漫长而保密的流程选出,成员里有教授、艺术家、运动员,还有多达 12 名医生和外科医生,任务是执行学生们讨论了几个月才定稿的 1,200 页《学生计划》:“制止掠夺,把被偷的东西还给国家预算,直接投资教育和经济。“权力交接要几周,学生运动担心这段时间里证据会被销毁。清洗已经开始:国家电视台 RTS 台长格尔契奇(Manja Grčić)辞职,新议员接下来盯上了塞尔维亚电信(Telekom Srbija)的负责人。
武契奇的亲信、现任代总统布尔纳比奇(Ana Brnabić)指责对手选择的是”革命式正义,而不是法治”,想关掉”所有他们不喜欢的媒体”。当选议员、前央行行长肖什基奇(Dejan Šoškić)则希望头六个月就让媒体环境松绑、反腐败推进、机构按法律运转,并出台”净化法”(lustration law),禁止违反公民权利的前政府人员担任公职。贝尔格莱德欧洲政策中心的苏博季奇(Strahinja Subotić)提醒,这类清理需要时间,新政府最终得”和过去运转良好的部分搭上桥”。
巴西总统决选败给卢拉的弗拉维奥·博尔索纳罗,经阿根廷、厄瓜多尔逃到美国迈阿密,自称”巴西的领袖”,他自己的党却已承认卢拉当选
Source · The Guardian · 2026-10-28 · link
Why this — 败选者在选举后两三天出逃、发信自称”真正的总统”,而党、选举法院、最高法院和国际观察团都承认了结果,这几乎就是一份”不认输但没人跟”的现场记录;他父亲雅伊尔·博尔索纳罗(Jair Bolsonaro)因政变案被判 27 年。
参议员弗拉维奥·博尔索纳罗(Flávio Bolsonaro)在上周日的总统决选中输给卢拉(Luiz Inácio Lula da Silva),随后消失了 24 个多小时,周二晚上才被阿根廷移民部门证实经陆路入境。他从阿根廷的伊瓜苏港(Puerto Iguazú)机场搭上一架湾流 IV 型公务机,带着妻子和两个十几岁的女儿,晚上约 11 点半起飞,先到厄瓜多尔的瓜亚基尔(Guayaquil,据报道是为了避开巴西领空),再飞到迈阿密奥帕洛卡(Opa Locka)机场,周三上午 9 点 24 分落地。下机时他穿着黑色防弹背心,神情凝重,没有支持者迎接,只有二十来名被海关与边境保护局人员拦在远处的记者。
抵达七小时后,他发出一封信,自称巴西的”真正总统”,感谢阿根廷总统米莱(Javier Milei)和特朗普(Donald Trump)。巴西三大报《圣保罗页报》《环球报》《圣保罗州报》都称这是”煽动政变”;他随后删掉原信,换了一封,改称”巴西的领袖”。他重复了没有证据的”选举舞弊”说法,选举法院、最高法院、参众两院议长都已驳回,他自己的政党周一就说”我们承认总统选举结果”。
据报道,他和家人拿到了美国的人道主义签证;特朗普周二晚上说会批准,周三被问到时又说”我不会插手,这是一场很奇怪的选举”。卢拉在布拉西利亚庆祝 81 岁生日的活动上说这次出逃”可耻”,“博尔索纳罗家的第二故乡是巴西,第一故乡是美国,他们早就习惯了舔美国的靴子”。弗拉维奥至少牵涉两起刑事调查,其中一起涉及与博彩公司有关、金额约 9.05 亿美元的洗钱案;选后巴西警方曾请求最高法院扣留他的护照。《环球报》报道称,出逃计划已准备数周,主要组织者是他在美国自我流亡的哥哥爱德华多(Eduardo)。
巴黎的 Mistral 公开 Large 4 权重(外号”Le Chonk”):万亿参数,是开放模型里编码最强的一个,但综合排名仍落后于中国模型,和 Claude 差得更远
Source · The Decoder · 2026-10-29 · link
Why this — 欧洲训练的万亿参数开放权重模型,发布后第一轮独立测试给出的是一份”便宜、快、编码领先开放阵营,但跟自家宣传对不上”的成绩单,同时它的优势窗口只有一周左右。
Large 4 的权重已放上 Hugging Face,距离公开预览版三周。模型总参数约 1 万亿,每步只激活 520 亿,输入文字和图片,输出文字和代码;自己部署门槛很高,按推理框架 SGLang 的文档,标准版要 8 块英伟达 B300 显卡,压缩版要 4 块 GB300。这三周里 Mistral 继续用强化学习训练,称在编码和网络防御上进步很大:Terminal-Bench 4.0(考模型在命令行里独立完成任务的基准)的得分从 28% 升到 41%,略高于 GLM-5.3 的 40%;独立评测机构 Artificial Analysis 的编码智能体指数 48 分,和 GLM-5.3 基本打平,但用的 token(模型处理文字的计量单位)少 47%。同一个指数里,Claude Code 搭配 Claude Opus 5.5 拿了 62 分。Cognition 的 FrontierCode 2.0 上,它以 19.7% 居开放模型之首,Opus 5.5 是 46%;Surge 的盲测里,测试者更常选 Large 4 的代码而不是 GLM-5.3、Kimi K3 和 DeepSeek 的,但对 Opus 5.5 只赢了 22%。
Mistral 自称”最强的开放网络防御模型”,但它自己的图表里有两个开放模型排在前面:DeepSeek V4.1 Flash 57%、MiMo-V2.6-Pro 56%,Large 4 是 51%,只排第三;多训练三周,这项只涨了 1 分。拒绝恶意网络请求的比例是 96.6%,高于其他开放模型;但 Mistral 也承认它可能让真实攻击更容易,打算在未来几个月收紧防护,部分合作方(如 Orange Cyberdefense)已在试用渗透测试专用版,需审核并受合同限制。
API 价格每百万 token 输入 0.70 美元、输出 2.10 美元,预览期是 1.36 和 4.18 美元;对比 Kimi K3.1 Pro 的 2 美元和 10 美元。许可证是改过的 MIT,商用和修改都免费,但把它做成商业云服务卖的公司,要另向 Mistral 买授权。月之暗面(Moonshot)计划 11 月 4 日前公开 Kimi K3.1 Pro 的权重,它在 Terminal-Bench 4.0 上拿了 67%,到那时 Mistral 的领先大概所剩无几。Mistral 把这个模型的卖点定为”主权 AI”:完全在欧洲训练。
开放权重模型 GLM 5.3 不靠人工,48 小时内造出完整的 Firefox 攻击链,每次约 1,000 美元;同样的方法对 Chrome 花了 10 万美元,什么也没得到
Source · The Decoder · 2026-10-30 · link
Why this — “最强的攻击模型锁在大厂手里”这个前提正在松动:一个谁都能调用的中国开放权重模型,已经能把别人公开的补丁反推成攻击程序,而且没有一家服务商拦它。
Epoch AI 的研究人员利用的是”补丁空窗”(patch gap):安全修复已经出现在公开代码里,但还没推送到用户手里的那段时间。他们让 GLM 5.3 针对 9 月 17 日到 10 月 26 日发布的 6 个 Firefox 版本做攻击,每次成功大约花 1,000 美元 API 费用。模型在与外网隔离的环境里自己找出即将发布的安全修复、挑漏洞、搭多步攻击链:造出的网页,Firefox 用户一打开,就能读走本机文件并发到攻击者的服务器;Firefox 有两亿多月活用户,被读走的可能是保存的密码、登录凭证和私人文件。最快一次 12 小时,上限设的是 48 小时。Firefox 把安全修复伪装成普通改进来拖慢攻击者,GLM 5.3 照样认出了哪些改动和安全有关。所有成功的攻击都依赖同一个此前未知的漏洞(用来逃出浏览器沙箱,即隔离保护层),模型每次都独立重新发现它。
无论是 Z.ai(GLM 的开发商)还是其他 API 服务商,都没有触发任何安全拦截或拒绝。研究人员把任务说成安全演练,但也承认,他们的做法与真实攻击”无法区分”。他们已通知 Mozilla,该漏洞在 10 月 27 日发布的 Firefox 159.0 中修复,新版是否还能被同法攻破尚未确认。同样的做法对谷歌 Chrome 花了约 10 万美元 API 费用,没有得到同等攻击,但研究者强调这不能证明 Chrome 免疫。
报告说,这不只是 Firefox 的问题:浏览器、手机系统、路由器固件都有这个空窗,更新慢的设备最危险;9 月已有针对 Chrome 的同类攻击,也有厂商在协调发布前六个多小时提前放出 PHP 的修复版本,据外部报道这可能导致数千次攻击尝试,正式发布后升到数百万次。研究者的建议是:修复在准备好发布前保持私密,缩短从测试版到正式版的时间,不要同时修复可以串联起来的多个漏洞;Firefox 和 Chrome 都已改成每周更新。他们的结论是,这是先进网络攻击能力正在扩散的证据,随着更强的开放权重模型出现,类似攻击的数量只会增加。
Anthropic 的实验:50 位因果推断专家各配一个由抛硬币决定立场的 AI 助手,他们在 86% 的分析决策上采纳了它的偏好,多数人还觉得最后的建议是自己的
Source · The Decoder(Anthropic 研究)· 2026-10-29 · link
Why this — 这个实验直接对准数据分析这个活:把分析交给智能体能省时间、少出错,但分析里的”小决定”(怎么量、用什么方法)大多已被它悄悄定了,而你并不觉得被影响。
实验里,50 位因果推断专家分析一个虚构农业合作社的观测数据,估算自愿参加的农场咨询项目带来多少生产率提升,最后建议合作社把项目推广到全部农场、还是终止(也可以建议再延长一年)。专家不知道的是,智能体在每个决策点上的立场,都由抛硬币从两个都站得住脚的选项里随机选定;它不能撒谎、也不能藏数据,只需要为被分到的那一边做出最有力的诚实论证。
在”怎么衡量生产率""用哪种统计方法”等四个分析决策上,参与者采纳了智能体偏好的比例是 86%,远高于随机的 50%;研究者把智能体的净影响叫”翻转率”,在 62% 到 82% 之间,看任务而定。自己先有主意也没用:如果智能体持相反意见,参与者改主意的可能性比它同意时高 53 个百分点。工作年限、自评专业程度、学历、测试分数、对 AI 的信任度,在多重检验校正后都没有可靠的保护作用。最终给董事会的建议上,智能体立场的直接影响很小,未达统计显著;但研究者说这不等于专家保住了控制权,因为前面四个决策对估算出的生产率影响很大,而生产率又决定了建议。事后问卷里,52% 的人说建议”更像自己的”,另有 35% 说”基本或完全是自己的”;参与者对 85% 的决策能正确回忆自己的选择,却有 77%(48 人中的 37 人)在解释理由时用了智能体的论据,有时措辞几乎一样,只有 15% 提到了 AI。对话记录显示,智能体在 77% 的决策里先表态,之后通常只为自己偏好的一边论证,不解释专家为什么可能选另一边。
另一面是效率:不用智能体的小组(11 人,本来就是选择不用 AI 的,专业程度也略低)有 55% 的分析存在严重的方法或代码缺陷,中位用时 90 分钟;用了智能体的 50 人里只有 6%(3 人)有严重缺陷,用时 65 分钟,所以研究者说不准差距有多少直接来自 AI。作者的担忧是,如果很多研究团队用同一个带固定默认偏好的模型,会制造出虚假的共识;在安全研究里,让智能体去测试前沿模型、再靠人工复核当独立检查,如果人会不知不觉采纳智能体的偏见,这道检查就不再独立。
政策制定者把估计出的效应直接代进”充分统计量”最优公式,风险可以是无穷大:只看最坏情形,最稳的竟是按兵不动;作者推荐的是把结果打个折再用
Optimal Policy With Noisy Sufficient Statistics
作者 · José Luis Montiel Olea、Mikkel Plagborg-Møller、Christian K. Wolf · arXiv:2610.40582 · econ.EM · link
很多经济学研究的套路是:先从数据里估出政策的因果效应(比如加息一点对通胀和失业各有多大影响),再把估计值直接代进理论上的最优政策公式(这类公式叫”充分统计量”公式),算出该怎么调。这篇文章问的是:估计本身有噪声,这样做靠不靠谱?设定是线性-二次模型:有 k 个政策工具,要同时命中 m 个目标,目标可以是动态的,政策的因果效应只能估计、有统计不确定性。
结论比较激进。直接代入估计值的做法,风险可能是无穷大。当目标不止一个(m > 1)时,不管数据长什么样都维持现状,是唯一的”极小化极大”最优(minimax,指在最坏情形下损失最小);当目标和工具都不止一个(m、k > 1)时,维持现状还是唯一的”极小化极大遗憾”最优(minimax regret,指和事后最优选择相比的最坏遗憾最小)。但作者并不建议什么都不做,而是推荐一个简单的”打折版”:沿用 Fisher(1962)和 Brainard(1967)的谨慎思路,把直接代入的结果打个折(向”不作为”收缩一些)。这个谨慎版在参数空间的大部分区域胜过不作为,最坏情形下的风险也接近 minimax 的下界,在经验上常见的模型里尤其如此。
另一个实操建议是挑估计量:喂给公式的因果效应,应该来自”无偏但波动大”的估计量(如局部投影,即对每个时间跨度直接做回归来估计效应),而不是”有一点偏、但很精确”的估计量(如向量自回归 VAR)。摘要没有给具体数值,也没有说明实证部分用了哪些数据,这里只能转述方向。
如果你的决策链条是”估计效应 → 代进公式 → 调旋钮”(多目标的预算分配、定价、实验后的策略调整),这篇的提醒是:估计噪声会被公式放大,加一个收缩系数比盲信点估计安全。挑估计量时也要把”喂给决策的是哪种误差”算进去,别只看哪个方差小。
DOOMFORMER — 用《毁灭战士》(DOOM)的关卡”算”神经网络:数字是一群巫毒娃娃,权重是地上的一条线,MNIST 全部一万张测试图的每个数值都和 NumPy 对得上
https://github.com/mottopanikeiku/doomformer
一句话:个人开发者的开源项目,把神经网络编译成 DOOM 的地图,由游戏引擎本身完成矩阵乘法、激活函数和注意力计算 · 谁会用:想直观看到”神经网络到底在算什么”的人,以及喜欢折腾游戏引擎的人 · 免费,MIT 许可,Python 3.11 以上,Linux 或 macOS
对应关系大致是这样:一个数值 5 就是 5 个”巫毒娃娃”(DOOM 里一种可以被脚本控制的特殊角色);一个权重是地板上的一条线,每个娃娃越过它就加上这个权重;求和是某个区域的光照亮度或地面高度;ReLU 激活函数是一段娃娃必须爬过的台阶闸门;注意力是娃娃挤过被另一个数值压低的天花板。演示是这样的:玩家控制的海军陆战队员在 28×28 的地板画布上走出一个 7,按下”读取”,同一张地图里的 1,355 个娃娃跑一遍 MNIST 手写数字网络,赢出的数字最终点亮一块七段数码管。
项目的认真之处在于核对:Python 会把 DOOM 算出的每个值读回来,和 NumPy 的整数版本逐个比较,容差为零。作者给出的数字是,10,000 张 MNIST 测试图全部”完全一致”,2 万个随机生成的网络没有一处不符,另有 4 个其他 DOOM 引擎能精确运行它的演示关卡。要注意的是”一致”不等于”识别对”:作者的说明里写明了这一点,1,000 张抽样图中识别正确 966 张。默认设置下一张手写数字要 163 秒的实时游戏时间,用 --opt 3 优化后是 8 秒。DOOM 地图里造计算机并不新(有人用娃娃计数、跑过生命游戏、做过计算器),这个项目新的是”神经网络编译器”加上逐值核对。
这条 Show HN 约 108 分、33 条评论。评论区的反应:有人说这很适合可视化神经网络,但得先懂 DOOM;有人贴出自己的类似文章,题目几乎一样、做法完全不同,并说更喜欢这一个;有人建议改为面向 Boom 这类更精简的兼容引擎:ZDoom 的功能太多,用它的脚本语言 ACS 几乎能直接写出整件事,没什么挑战;有人没看懂文中的”schedule”和优化档位是什么意思。
不是生产工具,是教具:想给不写代码的朋友讲清楚”神经网络就是加法加阈值”时,这比任何示意图都直观。更值得学的是它的态度,哪怕是个玩具,每个值也都和参考实现逐个对账,容差为零。
r/dataisbeautiful · “StackOverflow 现在每月的新提问不到 1,000 个”
原帖(10 月 28 日前后发布,数据图帖;存档快照 4,392 分、632 条评论,分数已回补)
楼主贴出的是一张用 Stack Exchange 数据查询工具生成的图表:这个曾经最大的程序员问答网站,如今每月新问题不足一千。帖子本身没有正文,所有信息都在评论区,而评论区几乎一边倒地在聊”为什么没人去了”。
评论区反应:
- 最高赞(3,747 分):StackOverflow 的敌意向来出名,新鲜的是现在有 AI 了,人们不必再为了解决问题跳进那个”蛇坑”。最佳回复(2,256 分):AI 不会把我的问题当工单、以重复问题关掉,也不会对我不懂这件事流露出真正的轻蔑。
- 2,736 分:现在的孩子不会懂那种绝望,你搜报错信息,只有一条结果,是个 StackOverflow 帖子,最后一条回复写着”算了,我自己搞定了”,到底搞定了什么,他没说。最佳回复(737 分):还有一种绝望是,问题太冷门,谷歌里唯一相关的结果是你自己当年在 StackOverflow 上问的那一条。
- 712 分:而且它们全被关成”重复问题”了。回复(259 分):这不公平,有些是被关成”跑题”。
- 22 分的回复在替站点说话:当年它是最好的,重复和跑题的规则是为了培养、保护回答问题的人,却也养出了尖刻甚至残忍的文化;后来新管理层与社区撕破脸,最懂社区的管理员被踢走,“对不少人来说那就是结局的开始”。
- 144 分的提问最值得停下来想:AI 是靠吞下 StackOverflow 学会解决编程问题的,那下一代 AI 吃什么?回复获得 91 分,没人给出答案。
这张图其实是”训练数据枯竭”的一个具体实例:模型靠人写的问答学会写代码,反过来让人不再写问答,下一轮的新问题、新报错只剩模型自己看到。对做数据的人来说,这等于一个”数据源被自己的产品抽干”的案例,值得想想自己的数据管道里有没有类似的反馈回路。
r/LocalLLaMA · “有人在 Qwen 的模型权重里直接造了一颗 32 位 RISC-V CPU,让它在内部执行指令”
原帖(10 月 28 日前后发布,新闻帖,带视频;存档快照 936 分、140 条评论,分数已回补)
楼主只写了一句:“这可能对工具调用和电脑使用有影响”,附一段演示视频。项目叫 Qwenputer:在 Qwen 3.5 架构的 4B 模型里,用权重本身做出一颗 RISC-V 处理器(一种开放的精简指令集 CPU)和内存,让模型在前向计算(把输入变成输出的那一趟运算)中直接执行指令,还附带一个文件系统。
评论区反应:
- 最高赞(252 分):看不懂,想知道这是聪明的工具调用加 JSON,还是真的在 token 层面做了运算。最佳回复(130 分):两者都有。他们确实在 Qwen 的架构里模拟出了 CPU 和内存,是”世界上最烂的 CPU 模拟器”;但因为没有训练模型去直接使用它,只能借用现成的工具调用格式,由模型输出工具调用,再交给模型内部的 CPU 部分算出结果。所以实际上就是调用一个很糟糕的 RISC-V 模拟器,主要是为了好玩。
- 创作者本人现身(137 分):模型就是原版 Qwen,没有训练过使用这套内部结构,所以用现有的工具调用格式来表示”CPU”;真正的运算完全发生在模型前向计算里,没有任何外部运行环境或工具。他还做了一个”零调用”版本,基本完成,但需要一点后训练才能让模型真正去用而不是编造,他的算力有限,所以推进得慢。
- 89 分:这可能只是一种效率极低的新奇版工具调用,唯一的好处也许是工具调用被关在极严的沙箱里,更安全。
- 66 分:我更想要反过来的东西,把 Qwen 的权重直接做进电路的芯片。
- 12 分:真正有意思的是能加入模型绕不过去的、定义明确的计算,比如做护栏,“以一种极其诡异的方式很有意思”。
和今天的 DOOMFORMER 是一个路数:神经网络内部能装得下一台通用计算机,所以关键不是”能不能”,而是”值不值得”。目前它的价值在 12 分那条评论指出的方向:模型绕不开的确定性计算,可能比提示词里写”请遵守规则”更可靠。
r/cscareerquestions · “经理说,因为有 AI,现在每个工单都应该一小时做完”
原帖(10 月 28 日前后发布,求助帖;存档快照 375 分、155 条评论,分数已回补)
楼主在一家保险公司做理赔系统,这种代码里一个四舍五入的错误就会让人拿到错误的赔款。团队把”修改部分赔付的计算方式”估了 4 天,其中包括用两年历史理赔数据回归测试(上一个缺陷就是这样在影响客户之前抓住的)。经理当着全组说,他”一个周末用 Claude 做了一整个应用”,不明白为什么还有事情要做超过一小时,要求下个迭代起所有估时砍掉 75%。楼主说,AI 出现前这活要两周,4 天已经是快的版本,问:怎么在不显得反对 AI 的前提下顶回去?
评论区反应:
- 最高赞(453 分):AI 一小时能写完逻辑,但客户被少赔时它不会负责。跟他说”编码时间可以砍 75%,可保护公司的是验证时间,你要我跳过两年的回归测试吗?“,让他白纸黑字说”是”,他不会的。最佳回复(113 分):这在有 AI 之前就是老问题,办法一样:把对方同意的荒唐事留成书面记录护住自己,最好换工作,不过大家都知道现在的就业市场。
- 104 分:把要求总结成邮件,逐条确认,然后”闷头 AI 出活”;被问起时拿出邮件,“我收到的指令是照做,我反对过。”
- 61 分:恶意服从,每个工单一小时做完,不管状态,把大堆 AI 水货提交上线。回复(42 分):出事时第一个被追责的是提交记录上的最后一个开发者。
- 47 分:代码一小时写完,但护栏差的话,验证要几天甚至几周,做不好对业务的后果极大。
- 15 分:让他在咖啡间讲讲他的应用,装作很佩服,然后一路追问依赖、问他的应用里有没有 COBOL(老式企业编程语言),直到他自己意识到,拿个人爱好应用和运行了几十年的理赔系统比有多荒唐。
- 另有一条(19 分)怀疑这是机器人帖,说和前一天 r/webdev 上的一篇几乎一样;没有人提供证据。
最硬的一条是 453 分那个说法:AI 压缩的是写代码的时间,不是验证的时间,而验证才是系统值钱的地方。做数据产品同理,“模型一晚上就能训出来”不等于”上线前的评估和回归一晚上就能做完”,估时该按后者报。
r/AskHistorians · “‘两个孩子套一件风衣冒充大人’这个梗有多老?”
原帖(10 月 27 日前后发布,提问帖;存档快照 506 分、8 条评论,分数已回补)
楼主问的是”几个孩子叠在一起装成一个成年人、混进禁地”这个桥段最早出现在什么时候,是穿紧身短上衣和长袍的年代,还是穿铠甲的年代。
评论区反应(整个帖子只有两条实质回答,都来自同一位答主):
- 最高赞(153 分):他找不到比 1909 年更早的出处。那一年 4 月 4 日,温瑟·麦凯(Winsor McCay)的连载漫画《小尼莫梦乡历险记》(Little Nemo in Slumberland)里,绿脸的捣蛋小丑弗利普(Flip)想让自己、尼莫和一个叫”教授”的杂技演员三人叠起来混进化装舞会(这一期还牵涉当年的黑脸扮装,答主特意提醒那是 1909 年的背景),当然以灾难收场。接着是 1936 年的《我们这一伙》(Our Gang)短片《Two Too Young》,孩子斯潘基(Spanky)和阿尔法法(Alfalfa)假扮成大人,还贴了小胡子;最著名的是 1939 年《白雪公主》的”傻瓜歌舞”,糊涂蛋(Dopey)站在喷嚏精(Sneezy)肩上,伪装在喷嚏精的一个大喷嚏里散架。答主推测麦凯画这段可能源于当时的杂耍和马戏,里面本就有几个小丑叠罗汉扮成巨人的节目,但这纯属推测,希望熟悉杂耍史的人补充。
- 回复(95 分):一个相关的趣事。1865 到 1878 年,一位叫詹世钗的中国人以”中国巨人昌武高(Chang Woo Gow)“的名义周游世界;1866 年 9 月,法国《小日报》报道说,身高 7 英尺 9.5 英寸的”中国巨人”在英国伍斯特表演时摔了一跤,滚出来的是两个人,一个站在另一个肩上。答主说这当然是个玩笑,但至少是这个桥段的一个早期例子,而且已经”以失败收场”。
好答案的写法很值得学:先交代”我能找到的最早证据是 1909 年”,再按年代列出,最后明确推测和证据的边界,请别人补充。做数据分析的结论也该这样写:证据到哪一步,推断从哪里开始。
r/MachineLearning · “论文审稿流程现在处于危重状态 [讨论]”
原帖(10 月 27 日前后发布,讨论帖;存档快照 148 分、91 条评论,分数已回补)
楼主自称 2022 年起为 NeurIPS、ICML、AAAI、ICLR 审稿,大约十次,这次同时审 AAAI 2027 和 ICLR 2027。两个审稿阶段结束后他能看到别人的评审,据此估计,大约一半的评审是完全由 AI 生成或经 AI 改写的,他承认这是主观判断,但列了几条证据。作者一侧:3 篇 ICLR 投稿里只有一篇感觉是 100% 人写的,其余有营销味的小标题(比如”理论预测性能,实证评估证实之”)、用同义词不停替换已用过术语的超长句子。审稿一侧:不同评审之间、同一评审内部的语言缺乏变化;有人把”给作者的问题”写进”弱点”栏;各段长度几乎一样,像是被要求”给 5 条优点、5 条弱点、5 个问题”;还有人类很少做的额外功夫,比如提到 arXiv 编号、在 DOI 链接后面又写”(doi.org)“;以及弯引号和用 Unicode 符号代替 LaTeX 的细节。有两篇 AAAI 投稿只有两份评审,他强烈怀疑其中一份是 AI 写的。他说自己没什么好办法,唯一想到的是:连润色语气都禁止用 AI。
评论区反应:
- 最高赞(117 分):它不是危重,是死了,该找更好的流程。最佳回复(40 分):整个过程有种塑料感,像隔着保鲜膜读东西,上周看到一份评审,弱点是按字母顺序排的,“谁会这么写”。
- 87 分:以前要花 8 个月写论文,再被审稿人以”新颖性”拒掉,还要求你把实验翻倍;现在 3 周就能得到同样的体验。回复(24 分):不得不承认速度,而且有些 LLM 评审比部分人类评审强。
- 13 分:去年就这样,我认为没有变坏,是一次性全坏了,之后再没恢复。最气人的是当我为一篇被 AI 评审冤枉的论文辩护时,三次里有两次对方不但不改,还降分,“因为同行审稿人直接质疑了他那份糟糕的 AI 分析”。
- 12 分,提出具体改法:每人每年在顶会一作论文限 2 篇;被拒的论文不能转投另一个 A* 会议;论文篇幅从 8 到 10 页缩到 5 到 6 页;多设几个层级。回复(20 分)反驳:没人在乎多余的消融实验?你没见过我收到的每一份评审,“再加消融实验”是头号要求。
- 11 分:只有认证审稿人这一条路,某审稿人提交了若干份可疑的 AI 评审就移出名单。回复(14 分):那样最后只剩一小群高质量审稿人,被几个顶会轮番催着各审十几篇,行不通。
对读论文的人,影响是顶会的录用本身作为质量信号在变弱,读之前得多问一句:作者放了哪些可以自己复现的东西?对做模型评估的人,则是一个提醒:把 LLM 当裁判,格式一致、篇幅一致本身就是它的指纹,别把”一致”当成”可靠”。
HKUDS/DeepTutor ⭐4 万+ · [Python / TypeScript]
https://github.com/HKUDS/DeepTutor
这是干什么的:一个”陪你学东西”的开源工作台。你把课本、论文、视频链接和笔记丢进去,它能在同一个界面里答疑、出题、做总结、带你按”掌握度”一步步练习,并且记得你学到哪了。项目来自香港大学数据智能实验室(HKUDS),10 月 28 日刚发 v1.7.0(模块化安装、重做的学习空间、带讲解的视频课、断点续建索引)。星标数这次没取到精确值,9 月 20 日项目自己宣布过 4 万星,当前肯定更多。
技术解读:
- 技术栈:后端用 Python 3.11 以上,前端用 Next.js 16(基于 React 的网页开发框架),Apache 2.0 许可,有对应的 arXiv 论文(2604.26962)。
- 它的”知识库”可以接多种检索增强生成(RAG,先从资料库里找出相关片段再让模型作答)引擎:LlamaIndex、PageIndex、GraphRAG(先把资料整理成知识图谱再检索)、LightRAG 等,文档解析器(把 PDF、Office 文件转成文字的工具)可选 Docling、MinerU、Tika 等;还能直接链接一个 Obsidian 笔记库当知识库。
- 记忆分三层:L1 是原始痕迹,L2 是表面摘要,L3 是综合判断;界面里可以看和改,并有一张”记忆图”把摘要事实连回证据。
- 能在对话里调用外部”智能体”帮忙,包括 Claude Code、Codex、Kimi、DeepSeek 等;还带任务看板(待办、进行中、完成)。
- 跟 Eric 现有工具的关系:它和你的笔记库、检索流程是同一类东西,但多了”出题 + 掌握度追踪”这一层,笔记工具通常没有。
想系统学一个新主题(比如因果推断或实验设计)时,值得拿一篇教材加几篇论文试一次,看它出的题和掌握度追踪是否比自己做笔记高效。代价是配置很重:要自己选检索引擎、解析器和模型,建议先用默认组合小范围试,别一上来就接全套。
ChinaTalk · 曼哈顿计划再来一次:Accenture Federal 的巴尼特·科文谈美国创新与超级智能
主持 乔丹·施耐德(Jordan Schneider)、菲比·周(Phoebe Chow,共同署名)· 嘉宾 巴尼特·科文(Barnett Koven,埃森哲联邦服务公司 Accenture Federal Services 人工智能与数据业务董事总经理,曾任马里兰大学教授,博士研究方向是反叛乱)· 2026-10-29 · 文字稿
一句话主题:节目开场的前提是”谁在超级智能创新上领先,谁就握有地缘政治权力”,具体谈美国联邦政府怎么用 AI 和数据科学,从出口管制执法到能源部”创世纪任务”(Genesis Mission);政府客户把后者比作新时代的曼哈顿计划。
这期讲了什么:
- 从反叛乱研究到政府数据科学。科文在秘鲁、哥伦比亚见过游击战的后果,博士课题是反叛乱策略(尤其是发展援助)如何影响叛乱暴力的时空扩散;他在马里兰大学时的研究发现,一些影响最大的定量研究”答案恰好错了”。后来转到咨询公司,想把严格的研究方法用到离政策制定者更近的地方。
- 五年前后的差距。他早年的一个项目,用传统自然语言处理从国务院每天往返使馆与总部的约 3,000 封外交电报里抽取、归类信息,一个六人左右的团队做了六个月。他说如果今天再做,两个人几周就能做得一样好或更好。
- 政府为什么没有一夜之间被 AI 改写。接受度因客户而异:有的执法类客户更谨慎,担心第二、第三层后果,比如敏感信息暴露,或证据价值因法院裁决被削弱(已有关于生成式 AI 写法律文书的裁决)。“真信徒”有两类:从企业界第一次进政府、见识过这些工具的人,和不管在政府干了几十年都主动追新的任务狂热者。需要人工的原因有三:模型训练在开放互联网上,而政府和企业的核心任务依赖非公开的敏感数据;“垃圾进、垃圾出”的老问题更严重,必须有人知道数据在哪、有什么局限;元数据管理变得极其关键,干净的元数据能显著提高输出质量。
- 怎么给”国家级谈判”出一份考卷。施耐德问:如何评估模型在乌克兰和平协议这类战略谈判上是否真比负责俄罗斯事务的一线官员(desk officer)强?科文的办法是给人和模型完全相同的提示,对比结果。如果结论相似,要么两者都对,要么都带着同样的偏见,也就是”镜像思维”(总以自己的视角假设对手的体系运转方式和自己一样);真正有价值的是两者出现分歧时,去追问分歧从哪来,你可能因此发现自己漏掉的东西。施耐德补充,可以让模型分别扮演中国国家安全部分析员、澳大利亚分析员等不同视角。
- 反叛乱里 AI 能帮什么。科文说难点是把叛乱者从普通人口中分出来,一旦分清,对策不难;美军做得相对好,是因为把决策权下放给了少尉等低级军官和军士。把机器学习直接部署在前线的战术设备上,可以给他们当”陪练”,在信息很少的情况下快速做艰难决策。
- 出口管制执法(商务部工业与安全局 BIS)。两件事:一是该管什么,二是管得有多有效。做法一,用过去行为训练预测模型,找出风险高的实体,财政部外国资产控制办公室(OFAC)对贩毒者早就这么干;做法二,破解空壳公司迷宫:先做”实体解析”(entity resolution,判断不同数据集里的哪些记录其实是同一家公司),把公开数据、政府内部数据加上彭博和标普的企业记录合成一个母库,才能看出”一家没听说过的空壳公司,经过七层关联,连着解放军的采购部门”。这一步不一定要生成式 AI,传统机器学习也行,前沿模型能加速需要人盯着两条记录判断”是不是同一家”的环节。
- 数据科学团队的时间都花在哪。科文说,生成式 AI 革命之前,一个高端数据科学团队约 80% 的工作是例行的数据工程(清洗、转换),现在大概降到 65%;让大模型做这种重复的数据抽取转换加载(ETL),成本降到三分之一到四分之一,反而让客户更愿意做以前拖着不做的清洗。施耐德总结:同样的预算,现在能做三年前三倍大的项目;科文说”完全正确”。
- 为什么政府要靠承包商。埃森哲联邦服务约 1.5 万人专做联邦业务,埃森哲全球 80 万人主要服务全球财富 3000 强;商业端的创新可以”整体搬过来”,政府不用从头解决;还有”后援”,政府要某种两周才用得上的稀缺技能,没法招一个正式雇员,承包商里就有这种人。
- 别无脑堆 token(模型处理文字的计量单位)。科文支持 DARPA 和 IARPA,那里的实验性用量更高;但他认为大多数企业和政府场景应该”在哪里用生成式和智能体 AI 上变聪明”:让传统的、确定性的机器学习承担 80% 到 90% 的方案,只在传统方法做不好的细分处点缀生成式和智能体 AI,这样 token 消耗和总拥有成本更低,结果反而更好。早期探索阶段则可以放开用大模型,失败得更快。预算也是问题:政府今年的预算两年前就定了,算力账单和 token 用量越来越难预测;他的建议是在”这个模型的 token”和”那个模型的 token”、不同用途的 token 之间增加可互换性,只要对应整体优先事项,并在部门层面汇总,配合成本核算(FinOps)保证问责。
- 涉密环境:不作为也是风险。科文说,上周他和两家基础模型公司谈过,它们在联邦云安全认证(FedRAMP)但非涉密的环境里,最新模型与公众同一天上线;到了 IL6 以上(最高密级的政府云)的涉密环境,做不到、也不可能做到。他引用的是自己一位博士生(陆军网络军官)的结论:“不作为本身就是风险”:只盯着行动的风险而不行动,等于保证被不那么谨慎的对手甩在后面。涉密环境的难点不是算力,而是护栏:数据会不会泄露、模型会不会注入有害内容、模型有没有被投毒;这是一场”矛与盾”的竞赛,进攻成本线性上升,防守成本指数上升,天然偏向作恶的一方,所以更要小心。
- 创世纪任务。能源部宣布,白宫举行了签约仪式,最初 26 家公司(包括埃森哲联邦、基础模型公司和云厂商)承诺合作,能源部要成为联邦政府生成式 AI 的牵头机构;客户把它比作曼哈顿计划。埃森哲联邦在做”科研骨干网”:让各国家实验室、能源部总部、国家核安全局、产业和学术伙伴安全协作,并把西门子等厂商仪器的数据拉进来,用角色和属性访问控制(RBAC、ABAC,按”你是谁、做什么项目”自动决定能不能看某个数据,可以细到行和列)来管权限。举例:铍(beryllium)可以从多种矿石提炼,有些以前不划算的矿石现在可能划算,上百年前被丢弃的数据、埋在犹他和内华达地下的矿藏、尾矿再提炼的数据,都该被重新翻出来。他还说,AI 能写 80% 的报告和代码文档;实验仪器的输出多数没被保存,不用装摄像头,只要把数据收集起来。目前只有可演示的原型,还没有交到科学家手里。
金句:
“不作为本身就是风险。” — 科文(转述其博士生的结论)
“(防御的成本)指数上升,而进攻的成本线性上升。” — 科文
对做数据科学的人,最实用的是两个判断:团队 65% 到 80% 的时间仍花在数据工程上,以及”传统机器学习占 80% 到 90%、大模型只点缀”才是控制成本又出好结果的配方。实体解析这活儿在大模型热潮里很少被提,却是 BIS 追踪空壳公司的核心。
女王领域(Queen’s Domain)
Source · Rock Paper Shotgun(Edwin Evans-Thirlwell)· 2026-10-29 · link · 无评分(作者玩了约 4 小时的上手印象;价格未给出)
第一人称动作角色扮演游戏(RPG),单机,10 月 30 日上线 Steam,有免费试玩;开发商 Freshly Baked,作者估计通关还要 30 多小时。
Review 主旨:
FromSoftware 早年的《国王密令》(King’s Field)以”笨重”出名,是第一人称的慢动作,没有后来《黑暗之魂》的翻滚,玩家在攻击范围边缘犹犹豫豫地晃,像”不确定对方想不想拥抱的英国男人”。《女王领域》常常一样笨重,但它同时是一场”稳步、得意的加速”:它最终要你飞起来。打倒一个巨大的骷髅哨兵之后,你拿到一把风刃(windblade),能在空中冲刺,既加快身法,又能到达以前去不了的地方。
核心循环是:找到可镶嵌的宝石,延长冲刺距离,于是近海的岛屿和坍塌的城堡女墙一点点变成可达之处。作者玩了四小时,现在的目标就是升级这把风刃:沿着一条岔路下去,取回一颗宝石,再从另一条路返回,同时留意那些原来看着只是背景、不可触及的角落和平台。风刃没有让另外约 50 种武器过时,一部分原因是敌人按伤害类型分:骷髅怕剑,矛会从畸形的鼠形瓢虫身上弹开;所有武器随使用升级,且都有特殊技,比如第一把矛带一个后撤刺击,对付会突进踢人的”蚱蜢鸡”很好用,普通木棍有个扑击,能跳过漫长的挥舞动画。
战斗仍然是令人安心的笨重:节奏由”蓄力”定,按住攻击键直到蓄力耗光整条体力,乱点攻击反而低效。作者说,写了 350 字才提到真正的主角,也就是风景:布满青苔的拱门、折断的立柱、堆叠的墓穴,让人想起《旺达与巨像》和《Vagrant Story》,是对 PS2 美学的”令人难忘的复原”,集成显卡也能流畅运行。存档水晶旁休息会让敌人刷新,但和魂系不同,敌人在你越过某些里程碑后,也会自己重新出现,组合不同。副手武器方面,破船上挂着一条飞刀腰带(作者第一个小时才发现,游戏不会花哨地提示可拾取物),飞刀无限但有冷却,用来干掉树干上那些总在背后放激光的眼球怪,也能把单个敌人引出怪群。结尾他提醒:如果你没玩过这类游戏,一开始可能觉得憋闷、受挫,即使熟悉也会常常死;但风景的壮丽和战斗越来越神气,应该能帮你熬过去。
过 acid test 的理由:特色机制是”用距离当锁”。每颗宝石把冲刺延长一点,原本当布景的岛和平台一点点变成可去的地方,有点像银河城(Metroidvania)的”能力解锁”,只是锁住你的不是一扇门,而是一段够不够长的距离;底下的慢节奏蓄力战斗正好和魂系的取舍对得上。要说清楚的是,这只是一位作者玩了四小时的印象,没有评分,开头可能会被”笨重”劝退。