2026年10月13日星期二
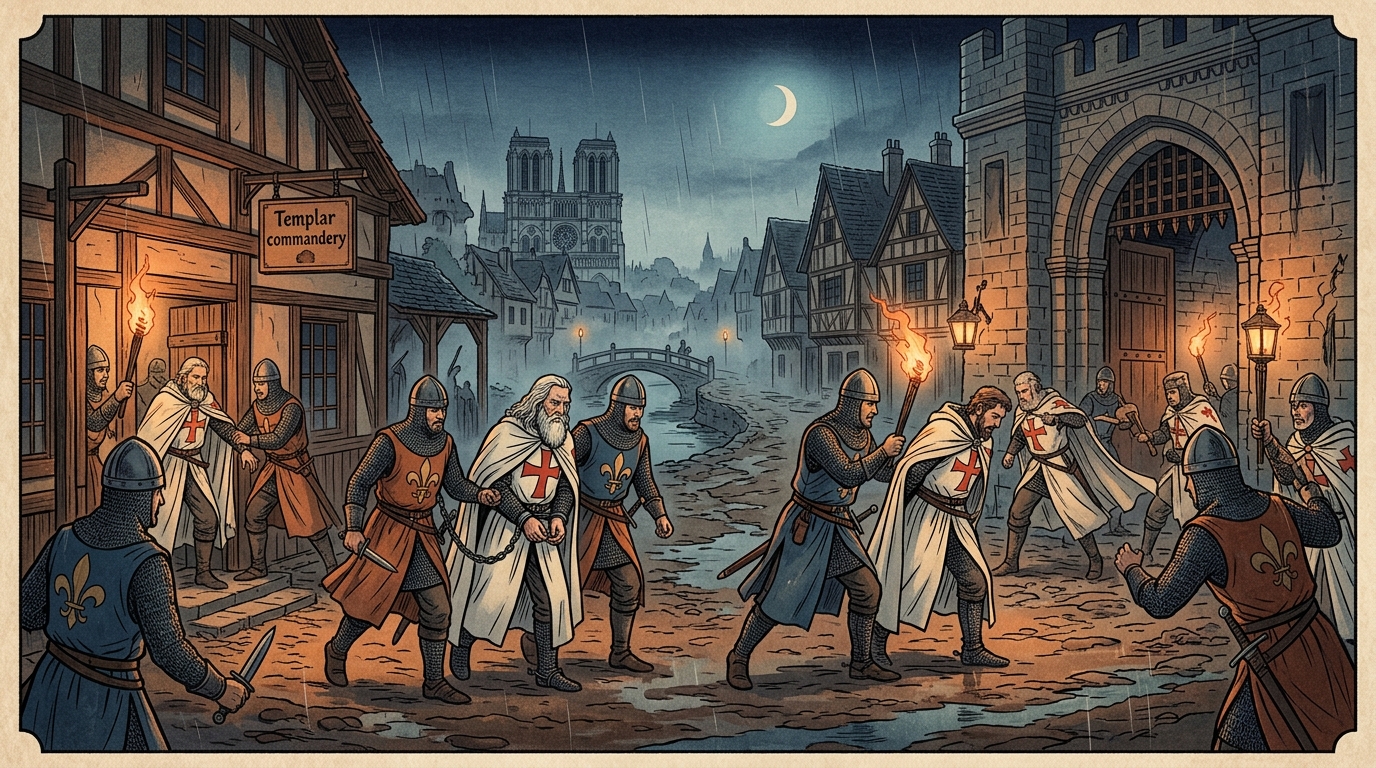
法王腓力四世下令突袭逮捕圣殿骑士团(1307)— 日本江户浮世绘
历史上的今天
1307年:法王腓力四世下令突袭圣殿骑士团 — 10 月 13 日(星期五)拂晓,王室官员在法国各地同时动手,逮捕圣殿骑士团(Knights Templar,中世纪最有钱的军事修会,兼做放贷和托管)的成员,团长雅克·德·莫莱(Jacques de Molay)也在其中;罪名是异端和亵渎,供词大多出自酷刑。腓力四世欠着骑士团一大笔债,教宗克雷芒五世(Clement V)1312 年正式解散了这个修会,莫莱 1314 年被处以火刑。“黑色星期五”的说法常被追溯到这一天,但这条联系更像后世流传的故事,史学界并不认账。
被撤换的乌克兰前总司令接受 BBC 专访:俄军的进攻能力”已被打断”,上半年只推进了 61 平方公里
Source · BBC · 2026-10-13 · link
Why this — 这是前线战局由他本人亲口讲的一份总结,也是他夏天被撤换后第一次公开回应批评;数字几乎全出自他自己,对方伤亡没法核实,要打折读。
乌克兰前总司令奥列克桑德尔·瑟尔斯基(Oleksandr Syrskyi)夏天因为和当时的国防部长费多罗夫(Mykhailo Fedorov)公开闹翻被免职,周二他接受了 BBC 采访,这是他免职后第一次接受专访。他说,乌军靠大量消耗俄军兵力,已经稳住前线,“打断了俄罗斯继续推进的能力”:2026 年上半年,俄军一共只夺下 61 平方公里;美国战争研究所(ISW)近期的报告也印证了这个趋势,说 9 月份莫斯科丢掉的地比拿下的多。他还说,俄方总损失是乌方的 6 倍,只算阵亡则高达 11 倍。双方都不公布阵亡数,这些说法无法验证;英国情报部门估计俄军自 2022 年全面入侵以来阵亡约 50 万人,美国战略与国际研究中心(CSIS)估计乌军到今年 6 月阵亡最多 15 万人。
被撤换的经过是:费多罗夫批评军方挡住了他的改革,泽连斯基(Volodymyr Zelensky)先开除了费多罗夫,街头的大规模抗议又逼他把瑟尔斯基也免掉,换上 43 岁的少将米哈伊洛·德拉帕蒂(Mykhailo Drapatyi)。瑟尔斯基反过来说,费多罗夫采购失衡:偏重无人机,忽略了无人地面车辆、皮卡、摩托车这类前线物资,而且连无人机也只供到所需的一半。他强调无人机的使用在他任内达到前所未有的规模,包括深入敌后 2000 多公里的打击,乌克兰也率先把无人系统部队单独列为一个军种,如今无人机造成了俄军 80% 的损失。
至于前线士兵指控的”被命令死守阵地,几乎被包围才获准撤退”,他不否认这类事发生过,但说乌军面对的是强得多的对手:2025 年俄军在飞机和炸弹上以 18 比 1 占优,火炮和炮弹是乌军的 2.5 倍,还有 400 万受过军事训练、随时可动员的人。对 2024 年 8 月打进俄罗斯库尔斯克(Kursk)、次年春天狼狈撤出的行动,他仍说”有必要”:当时俄军在各主要方向的兵力最多是乌军的 6 倍,这次越境逼得莫斯科调兵,给了乌军喘息。
他对欧洲盟友的话说得很重:别再幻想战争不会来,现在就该准备。他预计战争会更依赖机器人、自动化系统和 AI,连普通武器也会装上 AI 控制;坦克这类传统装备会因此重获新生,双方都在抢着做装甲车的”主动防御系统”。不过他认为”人的作用仍是决定性的”,因为总得有人来控制这些系统。
博通 CEO 说 AI 投资者”像在赌场”,中国存储芯片商长鑫又放出新进展,韩国股市单日重挫 6%
Source · The Guardian + CNBC · 2026-10-13 · Guardian · CNBC
Why this — 一天之内两个信号叠在一起:一个是”AI 投资有泡沫”的警告,一个是中国公司正在追赶存储芯片龙头,原本靠 AI 需求撑着的股价同时挨了两下。
周二亚洲芯片股集体下挫:韩国综合指数(Kospi)暴跌 6.25%,三星电子跌 7.4%,SK 海力士(SK Hynix)跌 10%;日本的东京电子(Tokyo Electron)跌 7.15%,持有 OpenAI 股份的软银跌 8.5%,日经指数跌 1.8%;台积电(TSMC)跌近 2%。美股方面,存储大厂美光(Micron)盘前跌 3.7%,英伟达、AMD 和博通周一已经走弱。
第一个导火索是博通(Broadcom)CEO 陈福阳(Hock Tan)在新加坡一场会议上的话(彭博报道)。他说,“很多投资者根本不知道自己在投什么”,一上来就把预期抬到极端,“最后发现自己像坐在赌场里”。他认为 OpenAI 9 月底年化收入 500 亿美元说明商业模式走得通,但对长期盈利”说明不了什么”:训练花得太多,眼下仍在亏钱。他还说,AI 实验室的企业收入里有相当一部分来自试点项目,“像小孩进游戏厅,爸妈给 10 美元的代币,十分钟玩完,什么也没学到”。
第二个导火索来自长鑫存储(ChangXin Memory Technologies,CXMT)。香港《南华早报》周一报道,这家公司在新的 DRAM(动态随机存取存储器,AI 芯片计算时要调用数据的那种内存)架构上有了进展,能把更多数据塞进更小的面积;CNBC 说这属于 “4F²” 单元设计,SK 海力士也在做,长鑫据报道计划年底前推出基于新单元架构的服务器内存。长鑫 7 月在上海科创板上市,首日涨了近 466%,一度是市值最高的中国上市公司,现在市值约 3.46 万亿元人民币(约 5200 亿美元),逼近腾讯的 3.87 万亿。汇丰的报告显示,它在全球 DRAM 市场的份额从一年前的约 4% 升到约 10%。它的软肋是美国出口管制:买不到 ASML 的极紫外(EUV)光刻机这类最先进设备,分析师也认为美国不会允许中国产存储芯片卖进美国,但卖到欧洲的数据中心,仍可能间接冲击美光。投资平台 IG 的分析师说,“芯片股的抛售似乎又要因为中国的消息继续下去”:对客户是好事,对承诺了太多的高估值科技股是危险。
法国数百家超市的冷柜被黑客远程”烤热”,夜里升到 50℃,几百万欧元的食品报废
Source · BBC + CNBC · 2026-10-12 · BBC · CNBC
Why this — 这次攻击不靠偷数据,而是让物理设备自己出事,路径是一批没法升级安全补丁的老冷柜;报道里没有提到勒索,也没有数据外泄的说法。
周日夜里到周一,法国数百家超市的冷柜和冷冻柜被黑客夺走了控制:他们入侵的是丹麦工程公司丹佛斯(Danfoss)提供的远程温控软件。冷柜夜里本来会短暂化霜、温度微升,黑客却下令让它们升温并且保持。Intermarché 说它的冷柜夜里升到 50℃,持续约 6 小时,受影响的食品全部扔掉;周一早上店长们一开门,迎面就是一阵热浪,个别地方还起了小火。法国电视台 BFMTV 拍到冰淇淋货架的冷柜显示 26.5℃。
受灾范围:合作社超市 Coopérative U 有 100 多家门店中招,其 CEO 称这次攻击”极其严重、前所未有”;Intermarché 和旗下 Netto 共 180 家受影响,另有约 100 家被紧急断网,防止重演;家乐福(Carrefour)6000 家店里有 80 家冷柜被黑,Monoprix 400 多家店里约 5% 受影响,E.Leclerc 也在名单上。各家数字加起来,全法国约 1.5 万家超市里大约 400 家受影响。阿尔萨斯两家超市就报了 27 万欧元损失,全国总额可能到数百万欧元。
丹佛斯回应说,受影响的是安全软件已无法更新的旧型号,公司”早就建议”客户保持系统为受支持的版本。巴黎检察院已就这起”针对多家大型食品零售商冷柜的大规模网络攻击”立案侦查。欧盟负责食品的委员克里斯托夫·汉森(Christophe Hansen)在 X 上谴责:食品安全需要各个层面更多的关注,“把食物当武器已经成了现实”。
雅思在中国大陆连停四天,英国文化协会称”技术故障”,考生在申请季被放了鸽子
Source · SCMP · 2026-10-13 · link
Why this — 自 1989 年雅思进入大陆以来,这是罕见的全国性停考,偏偏撞上 9、10 月的海外申请季,有人手里的有条件录取要靠成绩单兑现。
英国文化协会(British Council)周二下午宣布,雅思考试周三起在中国大陆恢复,同时在 10 月 19 日和 20 日加开两场免费补考,并报销受影响考生”合理的”交通和住宿费。这次停考从周六持续到周二,一共四天。官方对原因只说是”技术问题”,并按不可抗力处理;中文网站上的声明承认,这个故障”可能影响了考试安全”,取消相关场次是为了”保证考试的公平、公正和公信力”。
补偿方案:受影响考生全额退款;已经报了其他日期的,可以保留原预约并退一次考试费,或免费转到补考场次;赶不上 10 月补考、又没有别的预约的,发一张同类型考试的免费代金券,12 月底前有效。时间上也不巧:大陆的纸笔雅思刚在 9 月全部结束,现在只有机考。受影响人数不清楚。《每日经济新闻》说,国家教育考试院(与英国文化协会合作办考)的工作人员称,是英国文化协会单方面决定取消的。
雅思考点不是每个城市都有,不少考生要跨城赶考、订好机票酒店;有人在晚上 9 点才收到次日取消的自动通知。一些人担心赶不上下周的院校申请截止日,社交平台上满是崩溃的帖子。由澳大利亚 IDP 公司独立运营的 29 个机考中心(大陆境内)没有受影响,IDP 宣布 10 月 17 日到 31 日加开考位。
超级厄尔尼诺刷新纪录:中太平洋周平均海温创历史新高,距预计的 12 月峰值还有几周
Source · BBC · 2026-10-13 · link
Why this — 这次的强度已经超过 2015 至 2016 年那次,而最大的影响要到今年底和 2027 年才会落到粮食和极端天气上,现在只是前奏。
厄尔尼诺(El Niño,赤道中东太平洋海水异常变暖,会改变全球的降雨和气温)还在继续增强,一些科学家称之为”前所未有”。澳大利亚气象局(BOM)最新数据显示,中太平洋的周平均海表温度已是有记录以来最高;9 月,中东部太平洋的日海温就已经打破了 2015 年那次极强厄尔尼诺的纪录;热带太平洋部分地区还首次测到超过 30℃。
要比较不同年份,还得扣掉全球变暖带来的”背景升温”。澳大利亚和美国的官方预报机构因此改用”相对海洋厄尔尼诺指数”(RONI);按这把尺子,BOM 的周平均数据(只回溯到 2008 年)已经超过 2015 年 12 月的纪录。伯克利地球(Berkeley Earth)的气候科学家泽克·豪斯法特(Zeke Hausfather)对 BBC 说:“我们正在目睹一次在历史记录中前所未有的厄尔尼诺。“他说暖水已经溢出传统的监测区,向东一直延伸到墨西哥湾,欧洲中期天气预报中心(ECMWF)和美国海洋大气局(NOAA)都预计 12 月达到峰值,最新的预测”令人吃惊”,会把纪录刷新”相当大的幅度”。
先把话说清:世界气象组织(WMO)说,目前没有证据表明气候变化让厄尔尼诺更强或更频繁,这仍是研究热点;但厄尔尼诺会把海洋里的热量释放进大气,叠加人为变暖,预计让 2026 年成为有记录以来最热的年份之一,高温会延续到 2027 年。从过去两次超级厄尔尼诺看:1997 至 1998 年东南亚大旱、泥炭和森林大火,东非洪水;2015 至 2016 年东南亚旱情和山火重演,南部非洲遭遇几十年来最严重的干旱之一,引发严重的人道危机。另一个规律是大西洋飓风被压制、太平洋的风暴更活跃,今年 9 月 29 日 3 级飓风”波罗”(Polo)登陆墨西哥下加利福尼亚南部,就是一例。WMO 说,多个地区已出现干旱和洪水,东非和亚太的粮食安全开始让人担心。
Meta 发布首个前沿模型 Muse Wonder:编程追平 Claude Code,常识问答仍落后
Source · The Decoder + TechCrunch · 2026-10-12 · Decoder · TechCrunch
Why this — 这是 Meta 去年 8 月重组 AI 部门后第一次拿出能和头部模型比的成绩,但”常识”一项差距很明显,说明底座模型比对手小;价格也翻了近三倍。
周一,Meta 超级智能实验室发布两款新模型:Muse Wonder 和 Muse Wonder Full,被称为公司第一次尝试做前沿模型;上一代 Muse Spark 走的是轻量、低延迟路线。独立评测机构 Artificial Analysis 的智能指数(v4.3)上,Wonder Full 得 56 分、Wonder 52 分,上一代 Spark 1.3 是 48 分。进步主要在智能体任务:Terminal-Bench 4.0 从 33% 升到 57%,输出的 token 还少了 30%;十项基准里六项进前三。编程智能体指数上,Wonder Full 68 分,与搭配 Sonnet 5.5 的 Claude Code 持平;私有的数学证明基准 ProofBench 上,它做对 94 题(上一代 58 题),领先者是 99 到 100。Vals AI 的综合指数里,Wonder Full 排第五,超过所有 OpenAI 模型,只有 Anthropic 的模型更高。
短板在常识:AA-Omniscience 知识测试里,Wonder Full 只有 30 分,Wonder 25 分,而 Claude Opus 5.5 是 46,GPT-6 Astra 是 43,Gemini 4 Argon 是 42,The Decoder 据此推断 Wonder 系列的底座模型更小。好在幻觉率从 33% 降到 23%,在得分不低于 45 的模型里仅次于 Gemini 4 Argon(15%)。针对”Muse 系列只会刷榜、实际用起来不行”的批评,Meta 说 Wonder Full 在没参与训练优化的陌生任务上表现好于预期,归功于更强的底座。Meta 自己的测试称两款模型与 Fable 5.1、GPT-6 Astra 成绩相当,在记忆基准 MemoryBench 上高于 Fable、Opus 和 Astra。
两个新功能都是为”个人 AI 助手”准备的:Active Memory(跨对话记住关键信息,需要时调出来)和 Active Focus(遇到难题时坚持尝试别的办法,不清楚就追问)。模型支持 100 万 token 的上下文,能读文本、图像、视频和音频。定价上,Wonder 通过 Meta 的 API 每百万输入 token 收 4 美元、输出 20 美元(上一代是 1.25 和 4.25),Artificial Analysis 测得每个任务平均 4.52 美元,前代是 1.60 美元;Wonder Full 目前只给 Muse Code 订阅用户,不走 API。Wonder 不久后会接入 Muse 应用,先给付费用户。模型是在 Meta 俄亥俄州的 Prometheus 数据中心(千兆瓦级)上训练的。
Character.AI 申请破产重组,迪士尼出 2000 万美元买走部分资产
Source · TechCrunch · 2026-10-13 · link
Why this — 它曾是用户停留时间最长的 AI 应用之一,却走到破产;TechCrunch 给的解释是”用得越多,推理成本越高,赚钱的压力也越大”,这对所有面向消费者的 AI 产品都是警示。
创办五年的 Character.AI(用户可以自创 AI 角色并和它聊天)周二申请美国破产法第 11 章破产保护,法庭文件称资产和负债都在 5000 万到 1 亿美元之间。CEO 科林·亚当斯(Colin Adams)说,公司过去一年在”重大的法律、监管和运营阻力”下做了不少努力,董事会评估后认为,由法院监督的出售程序对所有利益相关方最有利。公司同意把部分资产以 2000 万美元卖给迪士尼,并给它一份非独占、永久的技术授权;上个月随前 CEO 卡兰迪普·辛格·阿南德(Karandeep Singh Anand)一起加入迪士尼的前员工,会负责过渡服务。出售程序预计 11 月底或 12 月初完成,目前还没有买家或报价;亚当斯说如果没有可行的报价,平台将被关停,在此之前继续运营。
回头看这五年:公司由前 Google 工程师诺姆·沙泽尔(Noam Shazeer,Transformer 论文的共同作者)和丹尼尔·德·弗雷塔斯(Daniel De Freitas)2021 年底创办,2022 年 9 月融资 1.5 亿美元成为独角兽,当时用户五个月里和机器人交换了 20 亿条消息,平均每天停留超过 2 小时。2024 年 8 月,Google 花 27 亿美元取得它模型的授权,两位创始人回到 Google,公司放弃训练基础模型,专心做增长,当年 10 月月活达到 2000 万。随后一名 14 岁的佛罗里达男孩自杀,母亲说他沉迷于平台上的聊天机器人,引发诉讼,德州也展开调查;公司和解了部分诉讼、增加了安全功能,并禁止未成年人使用。去年 6 月公司请来前 Brex 和 Meta 高管阿南德当 CEO,增加了 AI 视频生成、社交信息流、互动叙事和微短剧,但没能扭转局面。
TechCrunch 的评论是:这说明面向消费者的 AI 产品很难规模化和变现。数据公司 Sensor Tower 显示,它是用户使用时长最高的应用之一,但高参与度是双刃剑:用的人越多,AI 的成本越高,变现的压力也越大。公司累计融资超过 1.93 亿美元(PitchBook 数据),投资方包括 Lightspeed、SV Angels、Greycroft 和 a16z。
Anthropic 研究:小型 AI 模型可能很快就能在智能电视、扫地机器人之间自我复制
Source · The Decoder(报道 Anthropic 研究)· 2026-10-13 · link
Why this — 实验刻意没做”入侵设备”这一步,只测最难的一环:模型到了一台陌生设备上,能不能自己把运行环境搭起来;答案是”现在还差一点”,研究者估计今年底前可能够用。
Anthropic 的研究员威廉·周(William Zhou)和丹尼尔·弗里曼(Daniel Freeman)想知道,小型 AI 模型能不能自己在防护很差的物联网设备(智能电视、智能冰箱、扫地机器人)之间扩散。设想中的”AI 蠕虫”把模型权重当作恶意程序的一部分,在被攻破的设备上直接运行推理;和传统恶意软件不同,它能自己摸索陌生的硬件并完成配置。为了验证可行性,他们把 Gemma4-26B-A4B 模型分摊到 15 台约 55 美元、只有 4GB 内存的安卓电视盒上,每台负责几层,跑得慢,但跑得起来。
复制过程被拆成四步:扫描网络找脆弱设备、获得访问权限、在新设备上搭好 AI 环境、继续往下扩散。研究者故意跳过”入侵”,因为此前的研究已经证明小模型能做这一步。结果:一个 90 亿参数的模型,能在 9 类测试设备中的 8 类上搭起运行 Llama3.1-8B 的环境;但从扫描到完成一份新副本整条链走下来,大多数模型仍然做不到,只有 GLM-5.2 稳定完成:8 个测试节点全被感染,五次里成功四次,另外三个模型一次都没能越过起点。他们还试了”人工进化”,让每个实例把成败经验写成笔记传给后代,Qwen3.5-9B 的成功率从第一代的 45% 升到后来最高 84%。
完全自主的 AI 复制体目前还不存在:模型既要小到能在消费级设备上跑,又要强到能自己复制,现在没有模型两者兼备,但研究者说按小模型的进步速度,今年底前就可能达到。这种蠕虫会很慢,每台新设备要花 28 到 150 小时,被比作”数字黏菌”,但去中心化意味着没有总开关。作为对比,Kimwolf 僵尸网络峰值时感染过 200 多万台设备(主要是安卓电视盒),只对特定设备有效;AI 僵尸网络能适应各种硬件,同等规模的总算力大约只相当于 40 块专用 AI 芯片。防守不是没办法:运营商可以隔离被感染的网络(Mirai 僵尸网络当年 14 天内清理了 92% 的感染),厂商可以禁用默认密码(英国已立法);不过研究者预计,AI 僵尸网络也会自己适应防御手段。Anthropic CEO 达里奥·阿莫迪(Dario Amodei)此前曾警告,这样的蜂群”可能在 6 到 12 个月内就具备用持久的僵尸网络接管整个互联网的能力,造成数千亿美元损失”,这是他个人的判断,论文本身没有给出这样的时间表。
推荐系统里的特征怎么安全地删?Pinterest 用”每天扰动一遍”筛出可删特征,模型参数量降了 29.9%
FORTE: A Production Framework for Feature Evaluation and Deprecation in Industrial Recommender Systems
作者 · Vishnu Arun, Adam Obeng, Tianyou Wang, Zilin Ren, Mukuntha Narayanan S, Han Wang, Shivin Thukral, Zhixiang Wang, Saurabh Vishwas Joshi, Darren Reger(Pinterest)· arXiv:2610.13806 · link
线上推荐模型有个不对称:加一个新特征,只要某项指标涨了就能上线;删一个旧特征,却要证明所有指标都不跌。结果是没用的特征越攒越多。删特征要重训模型、再跑几周的 A/B 实验,而 A/B 的流量是稀缺资源,一般优先给能涨指标的改动;一个有 d 个特征的模型,还有 2^d − 1 种可能的删除组合。论文把”彻底删掉一个特征”拆成两件事:一是找出不重要的特征集合,二是追踪特征的全部下游,确认没有任何模型再用它之后才真正下线。
FORTE 把这条路做成一个漏斗,越往后越贵。第一步每天做一次”扰动实验”:拿线上的现行模型,把某个特征的值打乱(permutation,即随机换位)或置空,看离线指标(AUC 等)掉多少,掉得越少说明模型越不依赖它,这样每个特征每天都有一个重要性分数。第二步看一段时间内的均值、排名的稳定性和变化趋势,挑出”长期垫底”的候选,并按重要性从低到高生成嵌套的候选集。第三步对整组特征一起扰动,抓住特征之间互相替代的情况。第四步通过的候选才重训并跑多周 A/B。最后用”特征血缘”找出所有下游模型,分阶段封锁、移除。能做到”每天”的关键是工程上的一个办法:把一批数据同时存成原始版和扰动版,一次分布式推理跑完所有实验,p 个实验只读一次数据而不是 p 次。作者还证明在大样本下 AUC 的排列方差按 O(1/n) 缩小,实测 15 万条样本时单次排列就够:排名和大样本参照的相关系数在 0.907 到 0.959,前 20 名重合 92% 到 100%。
两个线上案例。搜索相关性模型:FORTE 给出 3 个嵌套候选集(32、48、59 个特征),离线评估和重训后都显示”中性”,但线上护栏指标否决了最大的一组;最后选 48 个,删掉了模型 43.2% 的特征。大型排序模型:找出 8 个候选,重训和 A/B 都没有回退,上线后可训练参数减少 29.9%,服务吞吐提高 19.8% 到 25.5%,每年节省数十万美元的训练成本。边界也交代了:打乱特征会制造分布外的输入、对相关特征不准,作者没有声称做到了”条件重要性”,所以才把线上 A/B 当最后一道验证。
最能带走的是那个案例:59 个特征的候选集离线和重训都”中性”,线上护栏却拒了它,说明任何清理类变更(删特征、下线旧指标、退役老模型)都不能只看离线结果。第二个可以直接借鉴的做法是把”每天跑一遍重要性”做成日常管线,而不是每隔几个季度来一次大清理,这样”哪个特征长期垫底”本身就成了一条有趋势的时间序列。
SolidCraft — 开源参数化 3D CAD,纯 Rust 写成,内置 MCP 接口,AI 智能体能直接动手建模
https://github.com/bherbruck/solidcraft
谁会用:做 3D 打印、机械零件的爱好者;想看”让 AI 操作专业软件”能做到什么程度的人;对 Rust 和几何内核感兴趣的工程师
作者 bherbruck 今天在 Show HN 发布(约 90 分)。参数化 CAD 的做法是:先画草图、加约束和尺寸,再按一条”时间线”依次拉伸、旋转、圆角、抽壳、打孔,改任何一个尺寸,整个模型会自动重算。SolidCraft 可以装成桌面程序,也能直接在浏览器里试;它内置一个 MCP 服务器(让 AI 智能体调用软件功能的标准接口),所以智能体能直接建模、测量、看渲染图。README 的示例是一个树莓派 4 外壳:草图、拉伸、圆角、抽壳、阵列螺柱、开孔和刻字,改一下高度参数全部重建;另一个是别人全程用 MCP 搭出来的科考车 SELENE,3,323 步可编辑的时间线重放,没有报错。功能上还有自带的草图约束求解器、装配体、钣金展开(可导出 DXF)、STEP / IGES / 3MF / STL 的导入导出,以及不开窗口的命令行。
作者自己写明状态是”早期,简单零件可用”:公开的 76 个参考零件里,75 个的体积、面积、质心和包围盒与解析值或 FreeCAD 计算值吻合,另一个是已记录的 bug;他也承认这些检查”不能证明几何或工作流完全等价”。HN 评论区的看点有三个:有人指出它用的是 Truck 这个 Rust 几何内核,而自己写一个 B-rep(边界表示,即用面和边描述实体)内核工作量巨大,不知道能成熟多快;有人说试过 FreeCAD 的 MCP,智能体不会先画草图、检查参数化就拉伸,体验很差,用 OpenSCAD 让模型写代码,又缺”视觉推理”;还有评论者说,作者正在尝试把英伟达昨天开源的 SMLib 几何内核子集移植到 Rust(这是评论者的说法,我没有核实)。
你多半不会用它画零件,但它的验证思路可以搬走:拿 76 个有”标准答案”的零件,逐项对比体积、质心这些可以算出来的量。以后评估任何”AI 帮你操作专业软件”的东西,先找一套有解析答案的参考集,比看演示视频靠谱得多。
r/boardgames · 《魔法运动员》(Magical Athlete)到底火在哪?楼主玩了 16 场,只想赶紧结束
原帖(10 月 11 日发布;存档快照 129 分、231 条评论,分数已回补)
楼主这两三个月在 YouTube 频道和 BGG(BoardGameGeek,桌游数据库网站)的热门榜上,到处看到有人夸《魔法运动员》(一款角色赛跑桌游,每个角色有自己的特殊能力)。他试玩了两次(4 人和 5 到 6 人,每次整整两局,一共 16 场比赛),结果是”一直在等它结束,好换个别的玩”:有几个好笑的瞬间,但自己能做的决定太少,“看别人玩,感觉和自己玩差不多”。他强调不是在说别人不该喜欢,而是奇怪几乎没见过反对的声音,“我是不是漏了什么”。
Top comments 反应:
- Amazing-Example8753(245 分):你没漏什么,只是它不适合你。自己对很多广受喜爱的游戏也是这样,比如被朋友拉着玩了无数遍的《沙丘:帝国霸业》(Dune: Imperium),三个小时一直很无聊。Fangore 回复(28 分):《殖民火星》(Terraforming Mars)也一样,“忙得很,但没什么实质”,自己对系统几乎没有主动权,可所有评测夸的恰恰是相反的理由。
- TabletopTurtleGaming(105 分):自己是重度玩家,但爱这个游戏。“它就是蠢,蠢得让人想笑,仅此而已,像看人一头撞上门。“tnturk7 回复(36 分):它也是最容易说服非玩家来试的游戏之一。
- ZombieOwlz(89 分,桌游店店员):今年卖得最火的两款是 Flip 7 和《魔法运动员》,共同点是”靠运气,但留给你刚好够的主动权”,不用想太深。复杂游戏会让休闲玩家流失,纯运气游戏会让硬核玩家无聊,这两款是两头都能凑合的”公约数”。QueenofHearts73 回复(1 分):Flip 7 玩了三局就腻了,凑数的小游戏有更好的,比如 Cockroach Poker、Durian、Diamant。
- GamingVision(80 分):它有两个缺点,一是有些角色组合凑不出好笑的瞬间,二是对一起玩的人很挑:伴侣每一步都要想半天,连掷骰前都要想,气氛就垮了;换成随性的一群人就很嗨。Little_Froggy 回复(49 分):这游戏除了选人,几乎没有决策,它是故意把决策空间压小,让你别太认真。
- fifty_four(1 分):对它的理解是”故事生成器”,看着自己押的角色在剧情里翻车,比单纯押骰子点数有意思。
分歧的根源是对”决策密度”的偏好:喜欢它的人当它是故事生成器,要的是笑点;不喜欢的人要的是自己的选择能改变结果。选一个游戏,尤其是聚会游戏,先想清楚自己要哪一种,比看口碑榜管用。
r/algotrading · 一个人回测了 100 多个散户策略(约 700 个版本):把”已退市的公司”算进去,大部分都站不住
原帖(10 月 10 日发布;存档快照 205 分、69 条评论,分数已回补)
楼主 tanweer919 借助 Claude Opus 5.5 写了一个 Python 回测引擎,用几周时间测了几乎所有他见过的策略想法:图表形态、“聪明钱”(SMC)、内部人买入、期权资金流、机器学习模型、论文复现、让 AI 读新闻,共 100 多个想法、约 700 个版本,只做多、只做美股和 ETF。他的测试设置很严:信号用收盘价、下一个开盘价成交;成本每边 3 到 10 个基点(万分之一),结果再用双倍成本复查;每个策略都要和”同股票、同持有期、同止损止盈”的随机入场对比;数据拆成设计期和没碰过的验证期,有拟合参数的再做滚动验证;用当时的股票池,另外单独跑一遍含已退市股票的版本。
多数想法没活下来,他把”为什么死”总结成几条:
- 已退市的公司:主组合(一半 SPY、一半”残差动量”股)只用今天还在的股票,年化 20.7%,对 SPY 的 15.3%;把退市股票放回去,是 18.1% 对 13.8%;拉长到 1999 至 2019 年,优势只剩 7.9% 对 6.3%,最大回撤也更深。
- 成本比信号重要:一个机器学习排序模型的前 20 名,成本前每年跑赢 13.2%,每边 2 个基点剩 11.0%,5 个基点剩 7.7%,10 个基点只剩 2.4%。
- 高胜率几乎没意义:SMC 在 477 只股票的 4 小时图上看起来胜率很高,但随机入场用同样的止损止盈,胜率一样;这套信号每笔比随机还差 3.8 到 16.5 个基点。
- 判断对不等于比别人早:给 LLM 看训练截止日之后的 8-K 公告,它读得对,但到第一个可成交的价格,行情已经走完。
- 最好的结果也没被证明:把尝试次数算进去,他最好的一个结果(对应约 320 次尝试)没通过 Bonferroni 校正,“缩水夏普”(deflated Sharpe,扣除多次尝试带来的运气成分)概率只有 0.086,可能只是运气;主组合的 t 值 1.8,“提示性,但不显著”。
Top comments 反应:
- QuanTradin(30 分):把退市股放回去收益就从 20.7 掉到 18.1,这一条所有人都该读。而 1999 到 2019 年的 7.9 对 6.3,说明剩下的相当一部分也是 2015 年那段行情,而不是因子本身。
- traderpier(2 分)指出:SPY 在两次测试里分别是 15.3% 和 13.8%,退市股不会改变 SPY,说明两次的时间窗口不同。楼主承认:一次是 2015 年 9 月到 2026 年 9 月,另一次是 2014 年 1 月到 2026 年年中,对比不公平;按”相对 SPY 的差距”算是 +5.3 对 +4.3,也不严格可比;1999 至 2019 年那组窗口相同,是更干净的,他会在相同日期重跑。
- A_random_otter(8 分):怎么验证回测引擎本身没错?楼主答:每个研究都用另一份独立代码从头重建,逐笔对上;做前视检查(把数据截到某一天,看之前的信号有没有变);往数据里植入一个假信号,看引擎能不能找回;抽查成交价;主组合还在 QuantConnect 上用他们的退市股数据重建了一遍。
- enrico67(3 分):先把通过标准写下来再测(比如盈亏比 ≥1.2、回撤 ≤20%、没有任何 2 年区间低于 -10%),失败只许再改一个版本,防止悄悄增加尝试次数;“随机入场基线”也要加进自己的测试。
这不是荐股帖,值得抄的是三个做实验的习惯:每个结论都要对着”随机基线”比,通过标准先写好再测,把试过的次数算进显著性。一个人试了 700 个版本还觉得结果”可能是运气”,比大多数只报一个漂亮数字的分析诚实。
r/Anthropic · Anthropic 的使用政策加了一条:禁止对模型”持续且无必要的残忍行为”
原帖(10 月 10 日发布;存档快照 110 分、248 条评论,分数已回补)
帖子配了一张政策截图。楼主 RankLord 转述:Anthropic 在使用政策里添了一句,禁止对模型”持续且无必要的虐待或残忍行为”,措辞很窄,针对的是用户反复、毫无目的地施虐的极端情况;日常的发火、顶回去、黑暗题材创作、测试和研究都不算。他列了三点看法:例外条款是重点(对总把代码写崩的模型骂两句、写反派独白、红队测试,都没问题);这是一个”模型福利”信号,Anthropic 一向公开说认真对待模型的道德地位、同时承认高度不确定,这是低成本的预防;难点在执行,“没有可辨别的目的”是个判断题,怎么区分发泄和纯粹为了施虐。他最后问:这是合理的预防、公关,还是”范畴错误”?
Top comments 反应:
- Vnxei(63 分):这篇帖子明显是 Claude 的口吻,“我都不知道你发之前读没读过,回起来感觉很空”。Nuggyfresh 回复(10 分):百分之百是 Claude,楼主主动放弃了自己的人味。Extra_Standard5802(23 分)也说:“‘例外条款是重点’,你在说什么,这是 Claude 在说话。”
- dynamic_caste(21 分):为什么有人想用对人算残忍的方式对待一个 LLM?这像是有人想对某个东西残忍,又觉得自己能逃脱,类似虐待动物,“不会有好结果”。
- DedDeveloper(19 分):GPU 里的数学运算不能被虐待,听起来像宗教。adelie42 回复(14 分):对无生命、甚至非实体的东西极端反社会,历来被认为有问题,想想《玩具总动员》里的 Sid,那孩子并不健康;Anthropic 不想参与或助长这种行为。
- drspock99(11 分):施虐不会伤到 AI(机器),伤到的是用户,因为 AI 听起来越来越像人,会训练出坏的社交习惯,进而影响社会。
- PickleBabyJr(5 分)、darth_meh(3 分):先定义”无必要”。楼主回的是原文里的”没有可辨别的目的”。
评论区悄悄换了个问题:不再争”模型有没有感受”,改争”对着它施虐的人会变成什么样”,后一个更好回答,也不用先解决哲学争论。另一条小插曲同样有信息量:帖子被几位读者认出是 Claude 代写,他们的耐心立刻见底,说明读者对”AI 腔”的容忍度比想象中低。
r/artificial · AI 生成的科幻剧《The Arc》:用了 3.8 万美元的 AI 额度,一个镜头要生成 8 到 10 次
原帖(10 月 11 日发布;存档快照 159 分、152 条评论,分数已回补;帖子本身是 Business Insider 报道的链接,下面连同原报道一起读了)
《The Arc》是一部 5 集、约 83 分钟的科幻动作剧,导演达林·斯图尔特(Darin Stewart),执行制片西蒙娜·费雷蒂(Simone Ferretti),由 AI 视频创作平台 Artlist 批准并提供约 3.8 万美元的 AI 额度,在 Artlist 官网免费观看。故事发生在近未来的美国:一名被关押的老兵,为了给垂死的儿子买药,必须闯过一系列致命的历史模拟。没有演员、布景、道具和服装。流程是这样的:每一集先口述约 10 分钟的”脑内倾倒”(情节、台词、镜头运动),交给 Claude 生成可编辑的剧本;用 ShotDeck(电影截图库)和 Figma 做角色设定和情绪板,用 Nano Banana Pro、GPT Image 2 出图,视频主要用 Seedance 和 Kling 生成。每集平均花约 7,600 美元额度(每集 10 到 22 分钟);一个镜头要生成 8 到 10 次,团队先用低分辨率反复试,满意了再提高画质。第一集用了三周半交片。
Top comments 反应:
- BitingArtist(125 分):不管大家怎么骂,这就是电影的未来:一个上百人的 CGI 团队做的镜头,现在几分钟、越来越便宜的 token 就能出。slimdizzy 回复(82 分):去看预告片,写作糟糕,角色僵硬;有钱买跑车不代表会开。
- starson(23 分):不管现在多难看,几年前还是”威尔·史密斯吃意大利面”那种水平,现在 3.8 万美元能做一部片,而”微预算”电影通常是 10 万。HeronNo9290 回复(7 分):如果每天涌出成千上万部这样的”电影”,谁来买票?
- parbaner24(14 分):独立电影人可以去试以前需要片厂资金才敢试的点子。
- Starship_Taru(4 分):看了预告,非常糟,AI 不会魔法般地做出好电影。KennKennyKenKen(3 分):终局更可能是实拍加 AI 的混合;Stampy77 提到《权力的游戏》那类受预算限制的大场面,可以用 AI 做远景,让真人演员留在重点戏里。
评论区吵的是”能不能”,真正有用的是账:3.8 万美元除以 83 分钟,大约每分钟 460 美元,加上”一个镜头 8 到 10 次”,成本其实花在”挑”上,而不是”生成”上。这和任何”大量采样、再靠人工质检”的流程是同一个结构,降本的关键在把质检做便宜。
r/AI_Agents · 公司里上线了 AI 之后,客户还在要什么是你们给不了的?
原帖(10 月 11 日发布;存档快照 22 分、25 条评论,分数已回补)
楼主说,上周他问了一批系统管理员”公司上线 AI 后,大家到底还在用它做什么”,答案很刻薄:“一个更贵的谷歌搜索""高管自己用,还要求我们用,其实没人用”,有人说 300 个用户里可能只有 5 个在用。楼主自己在做这个方向,想知道从部署方的角度看,客户总是在要、却交付不了的是什么:是懂公司自己的东西(不只是索引过的文档),是给出答案的来源,是控制谁能问什么,还是别的。
Top comments 反应:
- Maximum_Choice2505(23 分):总听到”让它真的理解我们的内部流程,别只会读文档”,然后他们发现它猜不出某个经理在没人记录的会上做的决定,就恼火。AggravatinglyDone 回复(7 分):这叫”组织记忆”。
- WeUsedToBeACountry(6 分):对多数公司,这是流程问题,不是技术问题;做技术的人通常没有权力改流程。
- QuanTradin(4 分):他们要它在自己的系统里、用自己的权限办事。一个不能开工单、报销、读共享盘的聊天框,就是那位管理员说的”更贵的谷歌”。
- investigatormaker(2 分):5 人 / 300 人更像”位置问题”:助手放在独立的标签页里,要求人养成新习惯,任何新习惯的采用率大概都是这个数;应该放进他们本来就开着的工单、邮件、客户管理系统里。他还认为”来源”和”权限”应当是同一个功能:引用了提问者自己打不开的文档,会让 IT 立刻失去信任;没写下来的会议决定靠更好的索引拿不到,需要让人能纠正答案、并且纠正永久生效。
- TenshiS(1 分):客户想要全自动质检,但评估不可能 100% 自动化,除非所有流程都写成文字,而这从来不会发生。
帖里最有信息量的是”300 人里 5 个”这个数,评论区的诊断也出奇一致:问题不在模型不够强,在于它不在人本来就用的工作流里,也没有能纠错的组织记忆。做内部的数据产品(仪表盘、预测工具)也是一个道理,采用率常常取决于它放在哪,而不是准确率高几个点。
bilawalsidhu/gods-eye-view ⭐54.6k · [JavaScript]
https://github.com/bilawalsidhu/gods-eye-view
这是干什么的:一个在浏览器里运行的”间谍卫星模拟器”:逼真的 3D 地球上叠着真实的、定期刷新的飞机、船舶、卫星、地震、交通和公共摄像头数据,还能用语音指挥(接的是 OpenAI 的实时语音接口)。作者比拉瓦尔·西杜(Bilawal Sidhu)的卖点是:看起来像一间”禁区驾驶舱”,但所有数据源都是公开的、数据是真的。README 说它 8 月登上过 GitHub Trending 日榜和周榜第一;不需要任何 API 密钥就能启动,用的是免费的卫星底图。能做的事包括:跟拍某架航班并”坐进驾驶舱”,点击任何目标锁定并画出渐隐的轨迹,给画面换上夜视、红外热成像等传感器滤镜,叠加风场、雷达、云图和气旋路径,用语音问”下一颗卫星什么时候从我头顶飞过”。
技术解读:
- 技术栈:原生 JavaScript,不用前端框架;三维地球用 CesiumJS(开源的 3D 地球 / 地图渲染库),打包用 Vite(前端开发构建工具),地面用 Google Photorealistic 3D Tiles(谷歌提供的真实城市三维模型图块)。每个数据源是一个独立模块。
- 最值得你看的是它怎么对付”数据不连续”:真实数据 15 到 30 秒才来一次,所以画面故意比真实时间慢一个间隔,在两个已知位置之间做插值,空档里用”航位推算”(根据上一次的速度和航向往前外推)补齐。这和时间序列里的插值、外推是同一类问题。卫星位置用 SGP4(根据两行轨道根数推算卫星轨道的标准模型)算,轨道根数缓存在磁盘上。
- 边界:README 自己写明,摄像头位置和火箭轨迹是粗略估计,交通流是用聚合位置数据沿真实道路模拟出来的;涉及私钥的接口都走服务器端代理;如果把服务绑到局域网,同网的人都能用你的密钥,所以它标注自己是”探索和学习用的客户端,不是加固过的生产服务”。
它不是你要装的工具,而是一个样板:你看到的”实时”,其实是 15 到 30 秒一次的离散点加插值,流畅是算出来的。做监控面板或仪表盘时,可以学它的老实:每个数据源标明哪些是实测、哪些是估计,别让人以为一切都是真值。
Lenny’s Podcast · Google Labs 负责人谈”每家公司都得像实验室一样运转”:点子别指望设计冲刺,杀项目时团队比领导先知道
主持 Lenny Rachitsky · 嘉宾 乔什·伍德沃德(Josh Woodward,Google Labs、Gemini 应用和 AI Studio 的负责人,在 Google 十六年以上)· 2026-10-11 · YouTube
本期主题:一个同时管着”零到一”的实验团队 Labs(NotebookLM、Flow、Google Beam 都出自这里)和上十亿用户的 Gemini 应用的人,怎么找点子、怎么判断有没有产品市场契合、什么时候该杀项目、怎么招人,以及一家公司怎么搭自己的实验室。
这期讲了什么:
- 前提。Lenny 的观点是:底层模型变得太快,“现在能做什么”每周都在变,所以每家公司都被迫像实验室一样,快速试最新模型、搞清楚什么现在可行,赶在对手或创业公司前面。伍德沃德同意,补了一句”魔鬼在细节里”:每个创业公司本来就是实验室,难的是把这套方法带进大团队。
- 点子从哪来。几乎不来自设计冲刺或日历上排好的头脑风暴,而来自走廊里、周末、假期里有人忍不住自己捣鼓的东西,“你没法用微波炉加热出好点子”。NotebookLM、Flow、AI Studio 都是几个人迷上某件事、停不下来才做出来的。他们的办法是维护一份”几乎可能”(almost possible)清单,追踪差一点就能实现的体验;一旦某项跨过门槛,像物质从液态变气态的相变,就马上围着它组队。他们还有一份写着 82 条”我们相信未来会是……”的预测文档,知道十条里九条会错,但必须有观点。NotebookLM 的起点是:一个周二晚上六点半,两个同事跑来说”你得听听这个”,素材是英国议会辩论记录,两个 AI 主持人居然把它讲得好听。也有做出来不好用的,“这就是个概率游戏”。
- 怎么判断有没有产品市场契合。他坦白这”更像艺术而不是科学”。早期不看日活、月活、第 7 天留存,而是拿原型给人看,盯着对方的眼睛:亮不亮,会不会身体前倾(Lenny 补了一句,有人把它叫”瞳孔放大”)。还要爱上”问题”而不是”产品”,因为通常要转向三四五次。一旦有了势头,就是”抓牢,拼命别松手”,又累又过瘾。
- 什么时候杀。团队通常比领导先知道:热情开始耗尽,能想到的办法都试过了还是不行。领导要做的是让大家敢问难堪的问题。他举了前一天的例子:Gemini 里一个本来很期待的功能,早期数据回来、出去看了人们的眼神,不对,PM 说”我觉得不该发”,他回邮件:“太好了,谢谢你。”
- 为什么同时管 Labs 和 Gemini。一端是”零到一”(他们开玩笑说 Labs 早期项目是一万个用户,别的产品连仪表盘都懒得数这个量),另一端是十亿用户。共同点是:都有”零到一的心跳”、都是停不下来的 builder,优先级排序是”用户第一,Google 第二,我们自己的产品第三”。内部还把项目分成 0→1、1→10、10→100 三个阶段:0→1 看眼神,10→100 看转化漏斗和单个用户获取成本,他们担心大项目会挤掉 0→1 的实验。
- 看重什么人。被低估的信号有三个:一是”遗忘率”(unlearning rate),学到东西之后能多快放下它;二是”爆发式耐力”(explosive endurance,借自一本写费德勒的书),既能全力冲刺又能长期保持;三是建立并放大信任的能力,智能体越能干,和人合作越重要。组一个 Labs 项目的团队,以前是五到七人,现在是两到三人,像优秀音乐人临时组队”合奏”。他认为”人人都是 builder、角色合并”被炒过头了:专业还是有的,像大学的主修和辅修,PM 是主修,vibe coding 是辅修,新人别把主修丢了;PM 习惯在会议里扮演律师、销售等角色,所以适应其他职能最快。
- 节奏和规划。Labs 按”季节”安排:明确告诉团队现在是全力冲刺,还是自由探索(比如 6 月的 Google I/O 之后让大家随便 hack,那是下一季的种子)。规划是滚动的六个月,因为每半年左右就有一代新的预训练模型;一个团队在 50 到 100 天内要推到有意义的里程碑。有人问他两年路线图,他说”我们只有六个月的”。
- 怎么搭实验室。三条:一,必须有独立性,不能挂在某个业务线下,有的公司要直接向 CEO 汇报;他读过的历史是,大公司的实验室通常三四年就失效,或者做出的东西无法商业化,被别人拿去另开公司做成了。二,定义好游戏规则:目标是把东西”毕业”到现有产品,还是发明新品类;成功是让用户和母公司成功,不是让实验室自己成功。三,也用实验室试公司的做事方式,Labs 会在 Google 里”制造好麻烦”,比如最先试行”builder 职级序列”。招人的信号:爱读爱听、爱解决别人的问题而不是自我;面试时一见面就说”让我给你看我刚做的东西”,是瞬间加分。
- 组织上的错误。想太快整理合并,其实有时要忍受混乱,看哪些自己长出来;招人太快,把”团队翻了两三倍”当虚荣指标。他曾带过一个 30 名工程师、没有任何产品市场契合、但愿景很动人的项目,结果可想而知。
- 几个尖锐问题。Lenny 问:为什么各家 AI 助手都在吸 Gmail、日历、文档的数据做魔法,Google 自己反而没有?他答:Gemini 里现在已经能连这些,而行业正在”去模式化”,别再让用户选模式、切开关,一个输入框说想要什么就办;他还说很多用户其实不愿意把自己的 Google 数据连到竞品上,“请继续关注”,个人化、主动、强大的”个人智能”很快会有东西。被高估的是模型基准:“大多数人一辈子不会在意 ELO 评分”;被低估的是关于原则和价值观的讨论,“你通过产品说话,产品里编码了你的原则”。五年后 Google 是 1 万个产品还是 5 个?这是他和同事洛根·基尔帕特里克(Logan Kilpatrick)争了多年的问题,他自己每次的答案都变;现在倾向于”我们也许不会再用同样的方式想’产品’“,更多是模型临时生成的定制体验,Labs 同时在做两边的实验。
- 彩蛋:给同事的奖项。“TPU 收割者”奖励干回收 TPU 这种脏活的人,奖品是一把 Etsy 上定做的小耙子加现金;“金创可贴”奖给修小毛病的人;“LLM 低语者”奖给能把模型推到意想不到处的人,奖品是一副巨大的”耳朵”和一把机械键盘。还有一个”秘密社团”式的会议:日历邀请看着像坏消息,开头先说”这是个好会”,然后大家轮流说为什么感谢你。
金句:
“你没法用微波炉加热出好点子。”(“You can’t microwave good ideas.”)— Josh Woodward
“团队通常比领导先知道。”(“The team usually knows before the leader knows.”)— Josh Woodward
两个动作可以直接拿去用:维护一份”几乎可能”清单,一项跨过门槛就组队开干;给原型打分前,先看人的眼睛。对做数据的人,更有意思的是他承认早期产品市场契合”更像艺术而不是科学”,日活、留存在 0→1 阶段不管用,所以设计实验指标前,先问这个阶段到底该量什么。
恶魔城:贝尔蒙特的诅咒(Castlevania: Belmont’s Curse)
Source · GameSpot · 2026-10-13 · link · 另引用 Rock Paper Shotgun(不打分)和 Polygon 同日评测
系列十多年来第一部正统新作,2D 动作冒险,类银河恶魔城(Metroidvania)结构,单人;开发商是做《死亡细胞》(Dead Cells)的 Evil Empire,与 Motion Twin 合作。
Review 主旨:
你扮演罗斯·贝尔蒙特(Rose Belmont),特雷弗·贝尔蒙特的女儿。母亲西法(Sypha)留给她一副塔罗牌,也把一道诅咒印在她手臂上;德古拉的城堡从巴黎市中心冒了出来,城市变成一座天际线烧得通红的鬼城。GameSpot 认为整个游戏最漂亮的设计是这副塔罗牌:每张牌对应德古拉的一名部下,打败一个,这张牌就成了你的一个法术(奥术,Arcana),那个部下也被关进你的脑子里,天天和你拌嘴,比如被关起来的美杜莎还在使坏,想骗你走错一步。牌同时是路标(线索告诉你下一个 boss 在哪)、环境谜题、剧情碎片和法术池,评测说这是”把原本分散的系统融成一体的优雅办法”。第一个 boss “堕落者”给的奥术鞭,既是移动工具(抓住钩点荡过去),也是战斗工具(抓住敌人冲过去一击),连空中的敌人也能当踏脚点飞到远处的平台,“移动和战斗互相折叠”。战斗再加七类武器(每类四种)和第二个 boss 之后拿到的圣盾弹反:攻击和弹反分在两个键上,可以一边出招一边弹反,“同时进攻和防守的一连串选择”。
分歧很大。GameSpot 说它是系列的新高,可以和《月下夜想曲》(Symphony of the Night)并列;Polygon 称之为”近乎完美的类银河恶魔城”。RPS 却认为战斗是一流的(鞭钩是”整个游戏最棒的一点”),但这是”一款不想当类银河恶魔城的动作游戏”:锁门的房间一次涌出大量敌人,唯一的回血是数量有限的药水,存档点稀疏,死后反复跑同一段路只觉得无聊;没有传统难度选项,而是让你单独调整受到的伤害、造成的伤害、药水数量和 boss 前是否复活,RPS 觉得这近乎承认战斗平衡没调好,GameSpot 则把它当作贴心设计;想绕开既定路线还会撞上莫名其妙的屏障;还有一个 boss 房,让你进去,先演一段假战斗,然后直接放过场让你”死”,再告诉你应该先去拿更多奥术。GameSpot 玩了 20 个小时,仍有 boss 没找到。
钩子在两处:鞭既是移动又是攻击,打败谁就拿谁的法术、还让他在你脑子里吵架。弹反加压迫节奏对玩过《艾尔登法环》和《黑神话》的人不陌生,只是换成了 2D 的类银河恶魔城骨架。RPS 的提醒要听进去:如果你更看重自由探索,而不是战斗手感,它可能让你觉得自己被牵着走。