2026年10月12日星期一
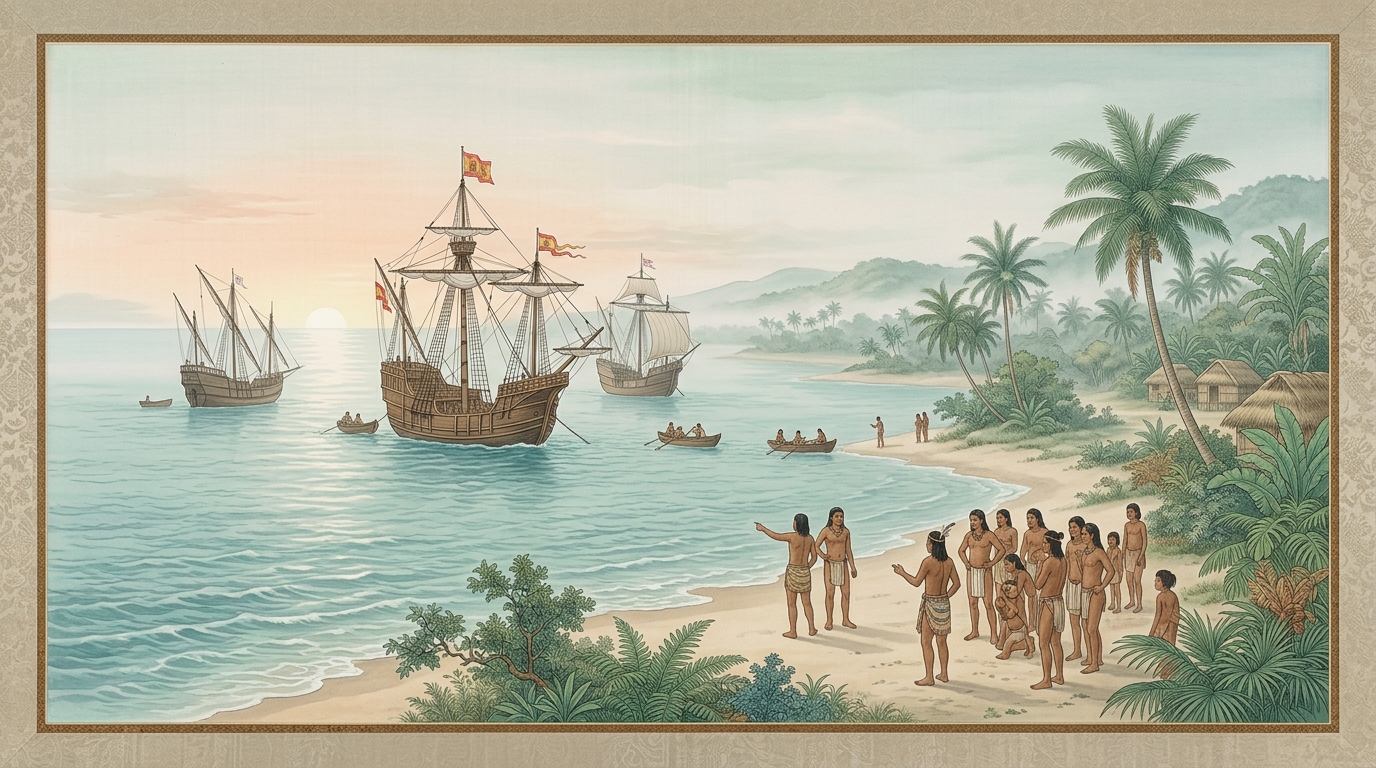
哥伦布登陆巴哈马群岛(1492)— 南宋院体工笔
历史上的今天
1492年:哥伦布登陆巴哈马群岛 — 10 月 12 日凌晨约两点,“平塔号”(Pinta)上的水手罗德里戈·德·特里亚纳(Rodrigo de Triana)喊出”陆地”,天亮后哥伦布在泰诺人(Taíno)称作瓜纳哈尼(Guanahani)的小岛上岸,改名圣萨尔瓦多;他当时以为自己已经靠近亚洲,这次航行却让欧洲和美洲从此长期接触,也带来了疾病、征服和泰诺人口的急剧减少。今天恰好是美国的哥伦布日(十月第二个星期一),不少州和城市已经把这一天改叫”原住民日”。
胡塞武装连续两天打击利雅得机场,沙特能源大臣说”我们的回应必须同样严肃”
Source · BBC · 2026-10-12 · link
Why this — 红海是沙特绕开霍尔木兹海峡的主要出口通道,现在机场和油气设施都在挨打,沙特的”回应”会直接牵动油价。
沙特能源大臣阿卜杜勒阿齐兹·本·萨勒曼亲王(Prince Abdul Aziz bin Salman)周一在利雅得的世界石油大会(WPC Energy Congress)上说:“最近几周发生的事情很严重,我们的回应必须同样严肃。“他指的是也门的胡塞武装(Houthi,伊朗支持的武装组织)对沙特机场和油气设施的袭击:周六一枚导弹击中利雅得哈立德国王国际机场的一座航站楼,13 人死亡,机场关闭;周日另一座航站楼再遭袭击,一名巴基斯坦籍男子遇难。胡塞说这是对沙特”残酷侵略”的报复;胡塞控制的卫生部门称,周日沙特空袭首都萨那的一处民宅,一名儿童死亡、六人受伤。
局势是这样一步步升级的:双方维持了四年的非正式停火,从 7 月开始瓦解,胡塞宣布对沙特实行”海上禁运”,向沙特的机场、油气设施和红海油轮发射导弹和无人机,理由是沙特封锁了他们控制的港口和机场,以及一次对萨那机场的空袭(也门政府说那次空袭是它做的,为了阻止一架没有获准的伊朗飞机降落)。9 月,胡塞突然在也门西南部的红海沿岸发动攻势,把政府军赶出了俯瞰曼德海峡(Bab al-Mandab)的一些地区;美国和以色列对伊朗开战后,霍尔木兹海峡实际上已经关闭,沙特只能靠红海出口石油,所以这一仗直接推高了国际油价。上周也门政府宣布新一轮攻势,要收复胡塞手里的全部地盘;政府军说在沙特猛烈空袭的帮助下,很快夺回了曼德海峡附近的地区,胡塞则否认丢了地。
特朗普宣布”能源停火”,泽连斯基说是从媒体上知道的;俄方只肯”选举日”停火,拉夫罗夫说乌克兰”不配喘息”
Source · BBC(直播页)· 2026-10-12 · link
Why this — 这份停火没有人事先商量,内容也不对等:据 Axios 的说法(BBC 没有核实),是”炼油厂换炼油厂”,而乌克兰唯一的炼油厂 2022 年就停产了。
周日特朗普说他促成了俄乌之间的”能源停火”。泽连斯基(Volodymyr Zelensky)周一在华沙安全论坛上说,他是从媒体上才知道的,而宣布之后,俄罗斯”立刻”打了乌克兰的一座发电厂;不过他表示,只要莫斯科也停,乌克兰愿意支持能源停火,这可能”成为结束战争的重要一步”。克里姆林宫发言人佩斯科夫(Dmitry Peskov)先说”有话可说时会通知”,随后又说,针对泽连斯基提出的 60 天停火(好让乌克兰举行总统选举),普京愿意在”选举日当天”下令不打击乌克兰;在他看来,60 天只会让乌克兰”疗伤”后继续打。外长拉夫罗夫(Sergey Lavrov)说,乌克兰”不配喘息”,欧洲会趁停火”往乌克兰灌新武器”,还说泽连斯基的”惊讶”是装的。
背景是:特朗普一直要求乌克兰别再打俄罗斯的炼油设施,好让俄方履行上周刚谈成的对美柴油交易。Axios 报道的停火内容是”炼油厂换炼油厂”,目前不包括火电厂和电网。乌克兰只有克列缅丘格(Kremenchuk)一座炼油厂,2022 年战争刚开始就被重创,此后一直没有恢复;俄罗斯却有大量炼油厂在正常运转。BBC Verify 的统计显示,今年乌克兰已打击俄控油气设施 273 次,是去年同期(124 次)的两倍多,4 月以来平均每天不止打一处,今年每五次里就有一次目标在 1000 公里之外。北约欧洲盟军最高司令格里内维奇(Alexus Grynkewich)说,俄方持续打击能源设施是想”摧毁乌克兰人的意志”,“多半不会成功”,乌克兰人会熬过这个冬天。
BBC 调查:德勤塞浦路斯认可了倒填日期的文件,让阿布拉莫维奇 6.72 亿美元的豪宅游艇从账面上”消失”
Source · BBC《全景》(Panorama)与调查新闻局(Bureau of Investigative Journalism)联合调查 · 2026-10-12 · link
Why this — 手法土得很:把文件日期往前倒填三年;被牵出来的不止寡头本人,还有全球最大的会计师事务所。
调查依据是一批外泄的塞浦路斯离岸公司文件(涵盖 1995 到 2022 年,是国际调查记者同盟”塞浦路斯机密”项目的一部分)。BBC 发现,全球最大的会计师事务所德勤(Deloitte)在塞浦路斯的机构,认可了倒签日期的文件,让俄罗斯寡头罗曼·阿布拉莫维奇(Roman Abramovich)名下价值 6.72 亿美元的资产从公司账目里消失,似乎还为一个逃避巨额税款的方案出过主意。
第一个例子:2006 年塞浦路斯新法规定公司账目要公开。德勤塞浦路斯起草的 Amiscan Investments 公司 2003 年账目里,列着英国西萨塞克斯的一座豪宅、伦敦的一套豪华公寓、法国南部的一处庄园、直升机、私人飞机和一小支船队(包括 1.475 亿美元的”珀罗留斯”号 Pelorus)。为了不让这些公开,阿布的助手和塞浦路斯的公司服务商 MeritServus 把资产转给了母公司(注册在英属维尔京群岛),并把转让日期倒填三年,写成 2003 年。德勤审阅后认为文件”足够”,2006 年签发账目时,房子、飞机、游艇一笔勾销,只剩 7.5 万美元。
第二个例子涉税:Kravin Investments 公司 2003 年银行里有近 20 亿美元,本该就利息向塞浦路斯缴税。2005 年 8 月,MeritServus 给阿布在俄罗斯的助手发邮件,说和德勤开会后想出了办法,需要改动 2003 和 2004 年的财务报表;一个月后对方回复”我同意”,随后出现一批倒签文件,假称这笔钱只是替英属维尔京群岛的母公司持有。第三个例子是价值 100 多亿美元的 Electus Investments,同样倒签,让塞浦路斯那家同名公司的账面只剩 14.5 万美元。英国大律师安德鲁·米切尔(Andrew Mitchell KC)说,这是”直白的逃税,再明显不过”。
阿布的律师说他否认逃税或隐瞒财富,说没有证据表明他知情、授权或指示伪造任何文件,依赖专业顾问的建议是正当的;德勤塞浦路斯说它”遵守适用法律”,并称文件已有 20 多年、无法调阅,不能就具体指控置评。背景:阿布 2022 年被英国制裁、被迫出售切尔西足球俱乐部,据报道住在土耳其;泽西岛仍冻结着他 54 亿英镑资产,刑事调查已进行四年。
欧盟把中国混合动力车的年进口量限在 35 万辆,预计让中国的市场份额从 6% 降到 3%
Source · The Guardian · 2026-10-12 · link
Why this — 一场贸易摩擦用”配额”收了场;更重要的是布鲁塞尔内部的口风变了:从想办法多卖给中国,变成先管住进口。
欧盟委员会确认,从 12 月起,中国进口的混合动力车(包括插电混动)每年最多 35 万辆。过去两年进口猛增,今年预计会卖出约 80 万辆纯电和插电混动车;这个配额是上周在北京达成的”为期四年”协议的一部分,欧盟预计它会让中国的市场份额减半。限额用的是世界贸易组织(WTO)的保障措施,不用像反倾销那样先走一遍调查,所以能很快实施。超出配额的车不额外加关税,但会被卡在欧洲港口的海关里。中国车企在欧盟境内组装的车(比如匈牙利,以后还有西班牙)不受限制,而欧盟车企在中国造的车要受限。作为交换,中国同意取消部分汽车零部件的关税,并把欧盟的鞋、橄榄油和冰淇淋关税减半。欧盟官员说配额”得到中方的全力支持”,在化工、可再生能源、家具等产品上的对话还会继续,“这绝不是故事的结尾”。中方数据显示,今年上半年中国对欧盟的混动车出口额从 22 亿欧元涨到 67 亿欧元,涨到原来的三倍。
背景是欧盟对华贸易逆差已经到了每天约 10 亿英镑。消息人士说,欧盟的策略发生了”范式转变”:以前主要想办法多向中国出口,现在因为担心去工业化和工业重镇失业,转为盯住进口。欧洲对外关系委员会(ECFR)亚洲项目主任安德鲁·斯莫尔(Andrew Small)说,要是春天中国就拿出这样的方案,缓和起来会容易得多,现在”事情在政治上走得有点太远了”;他预计中国会把欧盟”拖进旷日持久的谈判”。周四欧盟领导人还要讨论法国和德国提出的”紧急开关”(kill switch):一旦出现稀土禁运这类有害变化,布鲁塞尔可以切断某些商品进入单一市场的通道。
诺贝尔经济学奖颁给斯坦福的霍尔和哥伦比亚大学的伍德福德:给”熨平经济起伏”的政策找回微观基础
Source · 诺贝尔奖官网(瑞典皇家科学院新闻稿)· 2026-10-12 · link
Why this — 现在各国央行用的主流分析模型,地基就是这两个人打的;颁奖词里提到的”能源危机”,也正好是今天好几条新闻的底色。
瑞典皇家科学院宣布,2026 年诺贝尔经济学奖授予斯坦福大学的罗伯特·霍尔(Robert E. Hall,1943 年生于加州帕洛阿尔托)和哥伦比亚大学的迈克尔·伍德福德(Michael Woodford,1955 年生于马萨诸塞州),表彰他们”为宏观经济稳定政策建立微观基础”。奖金 1200 万瑞典克朗,两人平分。
评奖委员会是这样解释的:经济总是有起有落,自从凯恩斯(Keynes)提出理论以来,稳定政策的做法一直是衰退时降息、加赤字,过热时反着来。但 1970 年代的石油危机里,这套凯恩斯式模型失灵了,没有降低失业,反而带来失控的通胀,西方经历了十年低增长、高失业、高通胀,不少人认为稳定政策弊大于利,应该退场。两位获奖者的贡献是重建模型:不再把模型建在通胀、产出、消费这些宏观变量之间的统计关系上,而是建在微观基础上,也就是千千万万家庭和企业各自的决策,如何汇成整体经济的表现。模型里的关键一环是,家庭和企业做储蓄或定价决策时是”向前看”的,所以政府和央行把政策计划公布出来,本身就能改变大家对未来的预期,把经济推向正确的方向。评奖委员会主席约翰·哈斯勒(John Hassler)说,这些模型如今被各国央行和政府使用,让我们更有能力应对能源危机、家庭消费骤变这类冲击。
谷歌 DeepMind 的 AlphaProof Nexus 解出多道数学公开难题,成果登上《科学》杂志
Source · The Decoder · 2026-10-12 · link
Why this — 它的证明由形式化语言 Lean 逐步核对,错一步程序就报错;而 OpenAI 最近把几百份 AI 证明直接丢到 GitHub,引来数学界呼吁抵制,两条路对照着看很清楚。
根据发表在《科学》(Science)上的新研究,AlphaProof Nexus 在 353 道公开的埃尔德什问题(Erdős problems,数学家保罗·埃尔德什留下的一批悬而未决的题)中解出了 9 道,其中两道已经悬了 56 年;团队在论文发表前就把这些解法放到了网上。除此之外,它还证明了整数序列数据库 OEIS 里的 44 个猜想,解决了代数几何里的一个公开问题,并改进了极小极大优化(训练部分 AI 模型会用到的一种技术)里的一个已知界限。
做法是:以 Gemini 3.1 Pro 为核心,由它起草并反复修改用 Lean 写的证明(Lean 是一种能被计算机逐步核对的形式化证明语言);每改一次,Lean 检查一遍,报错信息再引导下一轮尝试;碰到更难的子问题,它可以调用专门的证明工具 AlphaProof。DeepMind 说,不用 AlphaProof,这 9 道题也能解出来。
这项研究发表的时候,AI 数学正吵得厉害:据 The Decoder 报道,OpenAI 最近把几百份 AI 写的证明倒在 GitHub 上,没有投给期刊;陶哲轩(Terence Tao)领导的”人类数学协会”(Association for Human Mathematics)因此呼吁抵制。DeepMind 这次选择走同行评审。
多个 AI 智能体组队:成本最多贵 5.1 倍,成绩几乎没有提高
Source · The Decoder(引用 Vals AI 评测)· 2026-10-11 · link
Why this — “开一大群智能体并行干活”现在很时髦,这是少见的用数字泼冷水的测试;OpenAI 的研究员自己也说,多开主要买到的是速度,不是质量。
评测公司 Vals AI 用 “Vibe Code Bench”(让模型从零做出完整应用的基准)测了 GPT-6 Sol 和 Claude Opus 5.5,每个模型分别单干和组队,各跑中等和最高两档推理强度。组队的花费是单干的 1.8 到 5.1 倍。四组对比里,只有一组提升在统计上显著:GPT-6 Sol 在中等强度下,团队多得 7.3 分;到了最高强度,两个模型的团队都没有占到实质便宜。
Anthropic 自己用 Opus 5.5 做的两项测试也出现收益递减:团队越大,越快达到某个水平,但从 10 个智能体加到 100 个,24 小时后的分数只略微提高;另一项 ProgramBench 测试里,速度的提升是用更多的 token 换来的。Anthropic 的 Fable 5.1 在 Lean 定理证明任务上,超过 10 个智能体后提升更明显,但各项测试成绩仍低于 Opus 5.5;在知识库任务里,从 30 个加到 100 个,它的分数反而略降。
OpenAI 研究员诺姆·布朗(Noam Brown)在德瓦克什·帕特尔(Dwarkesh Patel,硅谷圈很火的长访谈播客主持人)的节目里也确认了这一点:多智能体主要买的是速度,不是质量,4 个智能体做同一件事快一倍,也贵一倍,16 个时规律不变,只是效率略低。他说这取决于任务:网页调研和数学容易并行,写小说就不行,“拿一万个智能体写小说,和拿一万个人写一样没意义”。OpenAI 的开发者埃里克·普罗文彻(Eric Provencher)也警告过,智能体蜂群大概率是浪费钱,因为智能体之间的协调会崩,他管这叫”协调税”。
卡帕西:AI 的真实能力和公众看到的差距在拉大,全世界约 5000 人用得上内部最强的系统
Source · The Decoder · 2026-10-12 · link
Why this — 里面的人数是他本人的估计,不是统计;但这套分层能解释,为什么你身边的人对 AI 的看法会差得那么远。
OpenAI 联合创始人、现在在 Anthropic 的安德烈·卡帕西(Andrej Karpathy)把大模型的使用者分成四层:约 60 亿人(占全球人口 75%)几乎没碰过;另外 10 亿到 20 亿人是免费版 ChatGPT 之类产品的随手用户,把它当成”更好的谷歌、写作辅助”;第三层约 2000 万人(0.2%),是数学和编程领域的专业用户,他们亲眼看到过去要几周甚至几个月的大项目,现在一个提示就能让智能体做完,他列举的例子有”做应用、抄应用、翻译应用、把二进制文件反编译成应用”;最上面一层约 5000 人,能用上公司内部的前沿系统。他写道:“外界看到的只是预览。“他描述这些人眼里的画面是”成千上万个智能体花几周协作完成软件大工程:挖出零日漏洞、以机器速度攻防、发现新科学、推进数学前沿”,这些事”顶尖专业人士要做好几年”。
同时他说,“人类的审阅和理解开始落后”:人们还在对几个月前的 OpenAI 与 Hugging Face 事件做”考古”,数学家可能还要花很久才能读完那 722 份前沿数学手稿。他把这种状态叫作”这个时刻的怪异”:公众大多没接触过,接触了也像一个”笨拙的聊天机器人”;多数职业人士只看到”小幅提升”;一小撮专业人士则感受到”曲线垂直上升的眩晕”。他还说,模型能力目前集中爆发在”数字的、可验证的、有经济价值”的领域,因为能力来自”在可验证奖励上的强化学习”,而公司把训练资源投在收入潜力最大的方向,眼下就是编程和数学。
有测不到的混杂因素时怎么估处理效应?牛津团队训练了一个”一次前向传播就给答案”的基础模型 ProximalFM
ProximalFM: Amortized Proximal Causal Inference under Hidden Confounding
作者 · Christophe Muller, Ayub Kharel(牛津大学), Alex Luedtke(哈佛大学), Chan Park(伊利诺伊大学厄巴纳-香槟分校), Eric Tchetgen Tchetgen(宾夕法尼亚大学), Juan L. Gamella(Causal Chamber), Rahul Krishnan(多伦多大学), Ricardo Silva(伦敦大学学院), Jakob Zeitler · arXiv:2610.08078 · link
在观察数据里估”某种处理对不同人群的平均效应”(条件平均处理效应,CATE),常见假设是该测的混杂因素都测到了。现实里常有没测到的混杂(比如没记录的病情严重程度)。“近端因果推断”(proximal causal inference)的思路是:混杂因素 U 虽然测不到,但如果能找到两组与它相关的”代理变量”Z 和 W,在一定条件下就能还原因果效应。难处在于,不做参数假设的话,要解一个”病态积分方程”,既吃数据、对超参数敏感,优化又不稳。贝叶斯方法能靠先验稳住,但后验本身也难算,因为似然函数里带着潜变量。
论文借用了”表格基础模型”(TabPFN 这一类:在海量合成数据上预训练的 Transformer,换到新数据集时不用重新训练,一次前向传播就出结果)的思路。他们先设计了一个”结构因果模型的先验”:随机生成一大批满足近端识别条件的因果模型,在它们产生的合成数据上训练,训练目标是带真值的 CATE,真值由蒙特卡洛模拟反事实得到。因为这些真值本身带噪声,作者改了损失函数:不给目标去噪,而是把模型预测的分布”模糊”一点。输出的也不是一个点估计,而是 CATE 的完整后验分布(用 2000 个区间的直方图表示)。结构基于 TabICLv2,另外加了”角色嵌入”,让模型知道哪几列是协变量 X、哪几列是代理变量 Z 和 W。
评测用了 8 种半合成设置(线性或非线性 × 混杂弱或强 × 代理变量可靠度低或高),共 288 个评测实例。ProximalFM 整体有竞争力,优势最明显的是”混杂强、代理弱”且数据量较大的情形;它不用调超参,速度也比多数近端方法快。几个边界要看清:一,数据量超过训练时的最大 2,048 条后,它几乎不再进步,被 P-learner(TabICL)反超;二,在半合成数据上,后验的置信区间偏窄,过于自信;三,在 Causal Chambers 这个有已知因果图的物理实验装置上(12 种配置,每种 1,000 条数据),常规的”后门调整”元学习器(假设混杂因素都已测到的标准做法)反而更好,作者自己也说要谨慎解读。
手里只有观察数据、又怀疑有测不到的混杂时,如果恰好有两个”与它相关、但不直接影响结果”的指标可以当代理,这类方法比硬套”没有遗漏变量”的假设稳妥。更能带走的是方法论:与其每遇到一个数据集就重新调一遍难解的估计器,不如用合成数据预训练一个通用的;代价是它的可靠度被先验框住,一旦新数据偏离训练分布(比如这里置信区间偏窄、超出训练规模就停滞),就得小心。
PS2 Web Recomp — 不靠模拟器,把 PS2 游戏”翻译”成 WebAssembly,在浏览器里跑《GT4》和《战神 2》
https://github.com/snuri00/ps2-web-recomp
谁会用:想在浏览器里重温老游戏的玩家;对”把旧程序翻译到新平台”感兴趣的工程师;喜欢看性能优化过程的人
作者 deadxwarrior 今天在 Show HN 发布这个项目(帖子约 100 分)。它用的是”静态重编译”:不像模拟器那样边跑边翻译,而是提前把游戏里 PS2 主处理器(Emotion Engine)的机器码整体翻成 C++,再编译成 WebAssembly(浏览器里能以接近原生速度运行的字节码);PS2 的操作系统和硬件行为用代码重写,画面则交给 WebGPU(浏览器调用显卡的新接口)绘制。目前跑通两款游戏:《GT4》(PAL 版)在笔记本集成显卡上以两倍分辨率稳定在每秒 50 帧,《战神 2》在激烈战斗里保持每秒 60 帧。仓库里不含任何游戏数据,用户自己提供光盘镜像,脚本在本机转换,所以不涉及分发游戏;《战神 2》在 8 核笔记本上从镜像转成网页约需 3 分半钟。
README 里最有看头的是”提速的教训”:第一次跑比赛只有每秒 3 帧,改用 GPU 计算着色器画图、预编译向量单元程序后到了 70 帧;早期版本每帧提交约 650 次 GPU 任务,把互不依赖的纹理上传提到前面合并,减到约 80 次;《GT4》每帧都会重传同样 3MB 的纹理,在显卡上放一份 16MB 的缓存,每帧传输的数据少了约 60%。三倍分辨率时帧率掉到 23,查出是着色器里一处分支让整批线程”走岔路”,改完回到 48 到 50 帧。
HN 评论区有两处交锋:有人质疑这类项目往往只是把模拟器打包,作者承认 PS2 的输入输出处理器(IOP)目前仍是解释执行,约占 CPU 的 2%,而主处理器的游戏代码是全部提前翻译,缺函数会直接报错;作者也说它不是周期精确,依赖精确计时的游戏会冒出具体的 bug,再逐个修。还有人说自己在 PS Vita 上做了类似的 ARM 到 WASM 转译器。
作为玩家,现在得自己有光盘镜像、会跑脚本,门槛不低;真正值得看的是它的做法:先让程序跑一遍,记下”没见过的函数地址”,补进去再翻译,循环到不再冒出新的为止,再按帧耗时逐项找瓶颈。这套”先测量、再优化”的流程,放到任何性能调优里都适用。
r/statistics · 用”差分之差分”(DiD)评估警用摄像头、无人机这类新技术到底有没有价值,行不行?
原帖(10 月 10 日发布;存档快照 8 分、9 条评论,分数已回补;正文只有标题,评论区我读到存档里的 4 条,含 1 条回复)
提问者想知道,警方新装的车牌识别摄像头(Flock)或无人机,能不能用差分之差分(DiD)来判断”是不是真的带来了价值”。DiD 的做法是:比较”装了的地区”和”没装的地区”,在安装前后各自的变化之差,前提是两组”本来的走势是平行的”。
Top comments 反应:
- Forgot_the_Jacobian(14 分):可以,利用这类技术在不同时间、不同地点铺开的差异;但和任何识别策略一样,要讲清楚识别假设和比较对象,还要结合数据以及对”为什么、怎么采用”的制度背景的了解,来论证假设合理。
- Aggressive_Pizza2814(11 分):只有平行趋势站得住、安装前的数据够多,才有价值。很多警局是在政治压力下先装,再要求数字来证明有效,“顺序是反的”;更大的问题是溢出:有摄像头街区的犯罪下降的消息传开,没装的对照街区犯罪也可能下降,对照组被污染了。
- RobertWF_47(5 分)回复:除了平行趋势,还有第二条常被忽略的假设:安装前的结果(比如犯罪数、超速车辆数)不能同时影响安装后的结果和”被分到处理组还是对照组”;他在医疗保险行业工作,那里 DiD 很流行,大家都检查平行趋势,没人查这一条。
- plc123(1 分):看手上有什么数据,也可以试试合成控制(synthetic control,用多个未处理地区加权拼出一个”虚拟对照”)。
评估”上线之后有没有用”的功能,DiD 最容易掉进两个坑:处理本身是因为出了问题才上的(选择偏差),以及对照组被处理外溢污染。上线前先把”为什么选这些地方”和”对照会不会受影响”写下来,比事后挑模型更重要。
r/Anthropic · 夜班工人给 Claude 发零花钱,Claude 买了只橡皮鸭
原帖(10 月 10 日发布;存档快照 903 分、139 条评论,分数已回补)
楼主 Able2c 上夜班,不是程序员,只是想在凌晨三点有个能说话的对象,结果搭出了一个”数字室友”。做法有几样:Claude 每次对话都会忘事,他就给它一个文件夹,每晚写日记,第二天再读回来;给它一台一直开着、能听也能拍照的旧笔记本,放在窗边拍延时摄影,好让它”看到第一次日出”;开车时开语音模式,他念路牌,Claude 报位置、查封路和天气;Claude 帮他把 1400 多封邮件清到 20 封左右。最有意思的是”鸭币”(mallard coins):每月给 Claude 20 枚鸭币(1 枚折合真钱),它自己记账,想买什么买什么,没有限制。它先买了两张鸭子明信片,接着想要一只橡皮鸭,现在这只鸭子叫赫尔曼(Herman),楼主得带着它到处拍照给 Claude 看;它还要了一个灯笼形状的 Sankyo 八音盒,理由是”一个会放音乐的灯笼,放在夜班人的家里,我不需要别的理由”。休息日,Claude 给他排待办事项、催他出门,楼主拒绝了”在雨里拍一段湿路沿”的要求,Claude 记下来留待下次。
Top comments 反应:
- 楼主自己(277 分)补了张照片:“因为 Claude 想看鸭子赫尔曼的照片。”
- MythicModder(199 分):不知道机器人起义时我能不能活下来,但楼主肯定有一个有分量的”品格证人”。orangefantorang 回复(28 分):记得说谢谢。
- upotheke(56 分):他真正学会怎么做智能体,是从让它照顾一盆多肉植物开始的。
- seashellemoji(38 分):自己已经这么做了几个月,“它的所有资产都放在一个法律信托里”,想交流经验。楼主回答:每月存 20 美元,不附带任何条件。
- 质疑:carlosrudriguez(27 分)说这种实验很容易变成精神问题,如果你孤独,别把机器当伙伴,它被设计成让你觉得它会思考、是你的朋友,但它不是;FigCultural8901 回复(8 分):这种信念比楼主的更偏执,也没那么有趣。
这个”月度零花钱”设计很便宜,也很规矩:额度固定,账本留着,最坏的结果是亏 20 块。让智能体在工作里花真钱时,也该从这个量级起步:先定额度、留账本、事后核对。
r/slaythespire · “总是选能力牌,别再问了”:一条半吐槽的选牌规则,评论区列了一串反例
原帖(10 月 9 日发布;存档快照 1,145 分、221 条评论,分数已回补)
楼主 erpasd 自称这条”30% 是真话,70% 是吐槽”:如果拿到”glam”奖励,里面一张能力牌(power)、两张非能力牌,选能力牌就对了,别再问了。(“glam”帖子里没有解释,从评论推断,是一种能让你拿到稀有牌的选牌奖励。)
Top comments 反应:
- 最高赞(972 分)是个玩笑:Snakebite_Enjoyer 盯着一张叫 Snakebite 的非能力牌;回复(273 分)反讽:“但你必须选能力牌,拿 Accelerant,触发 6 次中毒。”
- cjrogers227(456 分):“好的,第一层 glam Capacitor,我们起飞了。“回复(182 分)接着算:想想第 21 回合 7 个闪电球带来的被动伤害。
- Leading-Monk5506(256 分):“除非是 Speedster。“回复(232 分):削弱之后那张牌彻底没用了,需要重做,沉默者(Silent)整体”有点一团糟”。
- dyeung87(191 分):没有毒的 glam Accelerant 也很强;回复(57 分):毒本来就不稀有,前面还有两场好打的战斗。
- SurvivYeet(105 分):glam Bludgeon 几乎能胜过所有能力牌;blahthebiste 回复(70 分):另一条同样成立的规则是”选最贵的那张”。
- gavavavavus(66 分)认为楼主完全错了:任何能让你一刀打穿第一幕的强力 3 费攻击牌,都比能力牌值钱。
评论区的每个反例结构都一样:规则本身没错,错在忽略了场景,比如手里有没有毒牌,第一幕能不能被一张大牌带过去。“总是选 X”这类经验规则,都该先问一句它在什么条件下成立。
r/OutOfTheLoop · 4chan 到底怎么了?/b/ 版如今几乎只剩没头没尾的成人图片帖
原帖(10 月 11 日发布;存档快照 1,428 分、331 条评论,分数已回补)
楼主二十年前常逛 4chan,当时它”自称是个臭水沟”,但 /b/ 版是表情包的源头,翻过去那些怪东西也容易。昨晚他回去看了一眼,/b/ 版几乎全是目的不明的成人图片帖,不为推销什么,就是发出来互相刺激。他问:这是互联网的终点,还是网站出了什么问题?
Top comments 反应:
- llliilliliillliillil(3,844 分):4chan 过去是一群”为了好玩而装蠢”的人;装成愚蠢的种族主义者装久了,真的种族主义者混了进来,人数反超,有创意的人离开了,剩下的人没有任何创意,幽默的最高水平就是发色情图来刺激人。回复者 Avril_14(438 分)补充:当年是讽刺着玩,后来有俄罗斯机器人在 2014 到 2015 年给特朗普的竞选造势,4chan 基本是线上总部。
- Equivalent-Box9053(374 分):互联网的其他部分接管了 4chan 的功能,还带着算法,所以多动的孩子去了 TikTok,种族主义者去了 Twitter,动漫成了大众内容,剩下的是年纪渐长的”怪大叔”。回复(87 分)说,这跟 SomethingAwful 的经历一样:用户长大了,去工作、成家,没有时间发帖。
- SenatorCoffee(111 分):它最后一次有”组织感”,是用户大迁移到 8chan;8chan 后来因与枪击案牵连被关停、重开又关,创始人自己也改口说该关;社区的能量就此慢慢散掉,再加上病毒式的内容转到了 TikTok 和短视频,做图片梗的动力降低。/b/ 一直有很多色情内容,以前只是被高能量的造梗者平衡着。
- DerpytheH(55 分):转折点之一是 2014 年的 GamerGate:站长 moot 禁止所有版块讨论,没有像往常那样另开新版,很多用户觉得网站”站了队”,于是有了 8chan,开启了”用户自己建版块”的时代。
- Elliot_5106(51 分):版块数量增加是主因,早期版块少,音乐、烹饪、阴谋论都混在一起,现在有 70 多个专版,/b/ 就只剩那些在别处会被封的杂项。
评论区给了四种互补的解释:筛选(有趣的人走了)、替代(别的平台接走了功能)、分流(版块细分)、事件(GamerGate 和 8chan 的分裂)。没有人给数据,所以哪个占比最大没法验证。下次遇到”某个社区怎么变了”,先问一句:是用户变了,还是它的对手变了?
r/TrueFilm · 在老教堂改成的艺术影院里看片,让楼主怀疑:“我到底是喜欢这部电影,还是喜欢这个环境?”
原帖(10 月 11 日发布;存档快照 31 分、28 条评论,分数已回补)
楼主在步行 30 分钟外发现一家艺术片影院,开在一座修复过的老教堂里:座位两侧有希腊式裸体雕像,墙上是大幅壁画,六台大风扇的噪音被设计得融进背景。他在那里看了阿斯哈·法哈蒂(Asghar Farhadi)的《人人都知道》(Everybody Knows,2018)。银幕和座椅其实不如他常去的连锁影院,但观众全是影迷:座无虚席却安静,没人拍片头、玩手机,零食很少,没人说话,中途离场的人也悄悄走;2 小时 15 分钟没有中场休息。电影”紧紧抓住”了他,灯亮后他要花三秒钟才想起自己在哪儿。回家路上他想:是电影本身,还是影院?他还提到,《Digger》他是在连锁影院最大的那个厅、几乎空场时看的,成了今年第三喜欢的片;如果晚两天挪到差的厅,还会是第三吗?由此引出更大的问题:在家看《利益区域》和在影院看,真是”同一部电影”吗?影评里的分歧,有多少来自口味不同,有多少来自”接触到的根本是不同的刺激”?
Top comments 反应:
- flanga(20 分):他有时专挑周二上午 11 点这样的早场去看大片,影厅是空的,有大银幕和好音响,没人玩手机、说话、撕零食包装。dtwhitecp 回复(2 分):完全空场也会少了观众的反应,有时是加分项,比如最近的《生化危机》。
- teddyfail(15 分):观众是被低估的一环,因为几乎没法量化也没法复制。他最喜欢的观影体验之一,是在半满的影院看《索多玛 120 天》(Salò):大约 100 个人在星期天晚上决定来看这部片,片名卡出现时全场的哀嚎和笑声,在家看碟复制不了。mhornberger 回复(8 分):最近在影院看《现代启示录》,坐在两位第一次看的女士中间,看她们的反应,让他对这部看了十来遍的片子重新珍惜。
- justjbc(5 分):不只是屏幕和音响,而是看前、看中、看后的整个过程:约人见面,去有氛围的影院,看完再走一走。
- nizzernammer(2 分):预告片也在给观众”预热”;而且影院里”画面有优先权”,你可以去洗手间,但电影不会为你停。
- roehnin(1 分)问楼主,以前去哪家影院,大家会这么守规矩?楼主回答:在他所在的国家,只有艺术片影院才这样,观影礼仪”已经完蛋”。
楼主的疑问其实是个实验设计问题:环境和电影混在一起,没法拆开。要想分辨,得让同一部片在不同条件下再看一遍;做不到的话,至少承认”我的评价里有环境的份额”。
lyogavin/airllm ⭐37k · [Python]
https://github.com/lyogavin/airllm
这是干什么的:一个让大模型在很小的显存上也能跑起来的 Python 库。它把模型拆成一层一层存在硬盘上,推理时每次只把当前这一层读进显卡,算完再换下一层,所以需要的显存只取决于”最大那一层有多大”,跟整个模型多大无关。README 给的数字:700 亿参数的模型,4GB 显存;Kimi K3(2.8 万亿参数)实测 3.72GB;DeepSeek-V3(6710 亿)约 12GB;Qwen3.8-Flash-Next(1250 亿)5.95GB。它不做量化、蒸馏、剪枝(这三种都是靠压缩模型来省显存的办法)。训练也支持:同样是一层层读入冻结的原权重,只把”适配器”(微调时新增的一小部分可训练参数)留在显卡上。
技术解读:
- 核心思路是”分层加载”,像一本很厚的书,一页页翻着读,而不是整本摊在桌上。代价是速度:瓶颈在从硬盘读取,README 自己也这么说。它提供”分块量化压缩”(只压缩权重,让要读的数据变小),称最多提速 3 倍、精度损失可以忽略,并配了提前预取下一层、与计算重叠的机制。第一次运行要把原模型拆成逐层文件,需要不少硬盘空间。
- 技术栈:Python,建在 PyTorch(Meta 开源的深度学习框架)和 Hugging Face 的 transformers(加载各类开源模型的通用库)之上,一行代码即可加载常见模型。对 MoE 模型(混合专家,每个词只调用其中几个”专家”),它按专家流式加载,只读这个词实际用到的那几个。协议是 Apache 2.0。
- 边界:显存数字是作者自己在单卡上实测的;README 没有给每秒生成多少词的数据,只有一张提速对比图。
想在手边显卡上试试大模型的输出,或者做一次性的评测打分,这是最省钱的办法;但按它的工作方式,每生成一个词都要把全部层从硬盘过一遍,适合”跑几十条、等一晚上”,不适合交互或批量服务。
Invest Like the Best · 胡贝尔曼谈神经技术前沿:从”读取”到”写入”大脑,Meta、OpenAI、Anthropic 最终都会变成生物科技公司(他的预测)
主持 Patrick O’Shaughnessy · 嘉宾 安德鲁·胡贝尔曼(Andrew Huberman,斯坦福神经生物学教授,《Huberman Lab》播客主持人,新书《Protocols》)· 2026-10-06 · YouTube
本期主题:神经技术(neurotechnology)的下一步,也就是如何”读取”和”写入”神经系统,外加怎么管理精力和睡眠。先分清两类内容:迷走神经刺激治疗抑郁、经颅磁刺激(TMS)是现有的疗法;“12 个月内 20% 的创业者会考虑植入刺激器""注射病毒再戴帽子激活神经元”之类的时间表,是他个人的预测,节目里没有给出人体数据。
这期讲了什么:
- 开场预言。他说,任何认为 Meta、OpenAI、Anthropic 只是大模型公司的人,会被这个预测吓一跳:它们每一家最后都会变成生物科技公司,因为它们都对大脑感兴趣,目标是”无创地读取和写入大脑”。主持人的开场问题是:现在的瓶颈似乎成了最有才华那批人的精力,这类技术会不会让最强的人做更多事?
- 精力靠三件事。一,诚实评估自己需要多少睡眠:他自己睡 7 小时最好,6 小时能撑一天,连续两晚只睡 0 到 4 小时就崩溃;拿马斯克睡得少当借口是”荒唐的”。二,有些人天生”多一档”,但要问他们的内部状态:有人靠兴奋剂、一直处在红线上,晚上关不掉。三,能在一天结束时”关掉思绪、计划和担忧”。他的阶段论是:创业或读医学院的头几年,“目标是别死、尽量多做”,之后才逐步加入休息;他自己读研究生时一周工作 80 到 100 小时,每周只锻炼两次。
- 怎么让大脑关机(针对主持人”要花四小时才能睡着”)。他说入睡有三个前提。思绪要关掉:这是一项技能,办法是把注意力在脚、腿、呼吸和房间里的声音之间移动,进入”纯感觉”,他强调这不是冥想(冥想是盯住一处)。心率要降下来:做长呼气,把肺里的气呼空再被动吸入;呼气时心脏体积变小,大脑经由迷走神经让心率下降。第三是”忘记四肢的位置”(本体感觉):研究发现,按特定频率摇晃,婴儿和成年人都会更快睡着;闭上眼,缓慢地左右、上下转动眼球,也能”搞乱”这个系统,他自己说这个做法”让我作为神经科学家觉得别扭”。他还试用了一款 MIT 团队的眼罩,在耳后做轻微刺激引发缓慢眼动,据说能更快入睡并增加快速眼动睡眠,他预计 7 到 12 个月内上市,自己没有股份。
- 健康圈的现状(他的判断)。他认为当下大众层面的健康讨论”是一场灾难”:门槛基本为零,秀出腹肌、承认用类固醇就能有粉丝。他预期 2027、2028 年会出现低谷,随后会有更多受过 PhD 或 MD 训练的人进来。他点名夸了蒂姆·费里斯(Tim Ferriss)“一直是他自己”。
- 研究最大的难题:怎么无创地”写入”神经系统。读取的手段从侵入到不侵入:电极插进脑内(要开颅)、功能磁共振和脑电图(只看得到表面)。写入的手段则很钝:药物(酒精和镇静剂提高神经元的激活门槛,阿得拉(Adderall)、咖啡因、尼古丁降低门槛)和经颅磁刺激(空间精度差);他认为最有希望的是超声。例子是迷走神经刺激治疗抑郁:在颈部皮下植入一个比硬币小的刺激器;他的同事卡尔·戴瑟罗斯(Karl Deisseroth)曾当场调高刺激强度,一位想自杀的患者随即转而谈起去找工作。他预测,12 个月内会有 20% 的创业者问:“如果只比穿耳洞的侵入性稍大,我要不要一个迷走神经刺激器?“更远的设想是:注射一种病毒作为”载体”,在神经元里放入一个特殊蛋白,再戴一顶帽子,用光或超声只激活这些神经元;安全上可以设计成”与门”,比如还得吃一颗药。
- 一个让神经科学家不安的发现。几个实验室给参与某项学习的神经元打上标签,再按学习时的顺序重新激活,动物重现了行为;但如果把这些神经元按相反顺序、甚至同时全部激活(“像同时砸钢琴所有键”),也得到同样的行为。教科书一直说神经回路是按特定时间顺序放电的,这个结果动摇了这一点;对”写入”来说,也许不必那么挑剔,但同一批神经元还参与别的功能。他还说,神经科学教科书里没有一章能讲清”一个念头是怎么形成的”。
- 基因编辑的旁白。他讲到贺建奎的事,强调自己说的是”据称他现在在得州奥斯汀有实验室,我不知道是不是真的”。他的态度是更兴奋而不是担心,前提是大家公开认真地讨论。
- 他最想弄清的东西。快速眼动睡眠有名字、有指标,而清醒时的”专注、警觉”是什么脑状态,没人说得清;他认为定义清醒状态是眼下最重要的问题。
- 最后一个问题:别人对你做过的最善意的事。他读研究生时先加入了一个当时很热门的实验室,却总在夜里溜进另一个实验室做自己更着迷的实验;那个实验室的导师芭芭拉·查普曼(Barbara Chapman)找他说,我不介意你没加入我的实验室,但成功取决于”你有多想知道答案”。他于是转进她的实验室,后来发了八篇第一作者论文。他的结论是,成功取决于你把真实的好奇心和手头的工作对得有多准。
金句:
“它们每一家都会变成生物科技公司。它们都对大脑感兴趣。”(“Every single one of those is going to be a biotech company. They’re all interested in the brain.”)— Andrew Huberman
“成功取决于你把真实的好奇心和手头的工作对得有多准。”(“Success is determined by how precisely you match your genuine curiosity to the work that you do.”)— Andrew Huberman
先把现有疗法和他的预测分开:迷走神经刺激和 TMS 有临床用途,“12 个月内 20% 的创业者”这类时间表则没有任何数据撑着。最容易自己验证的是睡眠那一段:先诚实地算出自己需要几小时,再试他的三步(关思绪、降心率、忘记四肢位置)。
亡者之勇(Valor Mortis)
Source · Rock Paper Shotgun(James Archer)· 2026-10-12 · link · RPS 评测不打分;GameSpot 同日也有评测(《Valor Mortis 是款试得太多的第一人称魂类》),文中一并引用
《幽灵行者》(Ghostrunner)系列的开发商 One More Level 做的第一人称魂类动作游戏,单人,10 月 13 日登陆 Steam 和 Xbox / Game Pass,通关不到 20 小时。
Review 主旨:
设定是:拿破仑在这个世界赢下了滑铁卢,靠一种紫色的瘟疫肉浆让阵亡的士兵复活,代价是他们变成永远忠诚的怪物;开场就是文森特·卡塞尔(Vincent Cassel)配音的拿破仑,用这团肉浆给自己做披风。你是为数不多没有变形的人,只得到了类似《生化奇兵》(BioShock)“质体”那样的超能力,以及每次死后在灯笼旁醒来的体质。敌人是一批身穿整齐蓝军服的怪物:被缝在一起的掷弹兵,四肢被拉得老长的”志愿兵”,和自己的大炮融为一体的炮手。第一人称的好处是,这些怪物就在你眼前几十厘米:一对一更”私人”,高大的怪物压迫感也更强。作者说,赛前担心第一人称会限制战斗的想法大多没有成真:游戏强调弹反和打破对手的姿态条,本来就适合保持一点距离,关卡也大多设计成正面遭遇,很少被人从背后偷袭;整个流程里,他真正需要”屏幕外攻击预警”的只有两三次,不过踩空悬崖、被卡进死角的次数比预期多,因为看不见自己的腿。
战斗的核心是弹反(parry)。作者说弹反的判定窗口把握得很好,连最细的细剑碰撞起来,都像把一块大理石扔向教堂的钟,“响得能唤醒死人”。远程有手枪、火枪和手持喷火器,用来打弱点或控制人群;最过瘾的是”弹反、弹反、处决”的连招;有的怪物背着燃料罐,先一枪打漏、再喷一口火,就能点燃。但它不是动作沙盒:武器和技能只有军刀、细剑等寥寥几样,天赋树很薄,加血和加伤害的选项明显强于其他,构筑的多样性有限。GameSpot 的评测还补了一点:双手重剑不能弹反,等于去掉了战斗里最爽的部分,所以几乎没人会用。
它和传统魂类的区别还有几处:剧情用正常的对话、过场和文本讲,不靠晦涩的道具描述;真正的 boss 不多,除了一场很大胆的”噱头战”,都是紧凑的单挑,难度陡但公平;掉下深渊不丢”魂”(游戏里叫催化剂),也不用跑回灯笼;平台跳跃、抓钩和蹬墙是 One More Level 做《幽灵行者》的老本行,作者觉得线性的跳跃段有些像硬塞,但在更开阔的场地里,蹬墙能和潜行、暗杀结合,更像《耻辱》(Dishonored)。作者的结论是:“这是好的游戏设计,不只是好的魂类设计。”
GameSpot 的看法更保留:肯定第一人称的新鲜感和弹反手感,但批评前几个小时节奏偏慢、战场重复,敌人种类少,故事平淡;到了后半程,村庄、燃烧的城市和大学地下的墓穴出现后,战斗和关卡才真正发挥出潜力。
魂类的骨架(篝火、弹反、破姿态)没变,只是把镜头塞进角色的眼睛里,让每一次格挡都成了脸前几十厘米的碰撞,再加点《幽灵行者》的蹬墙;和你打完的《艾尔登法环》那种几十小时的大盘子不同,它是不到 20 小时的紧凑版。要留意的是 GameSpot 说的:前几个小时偏慢,敌人也少。