2026年7月3日星期五
阴 · 2026-07-03(周五)
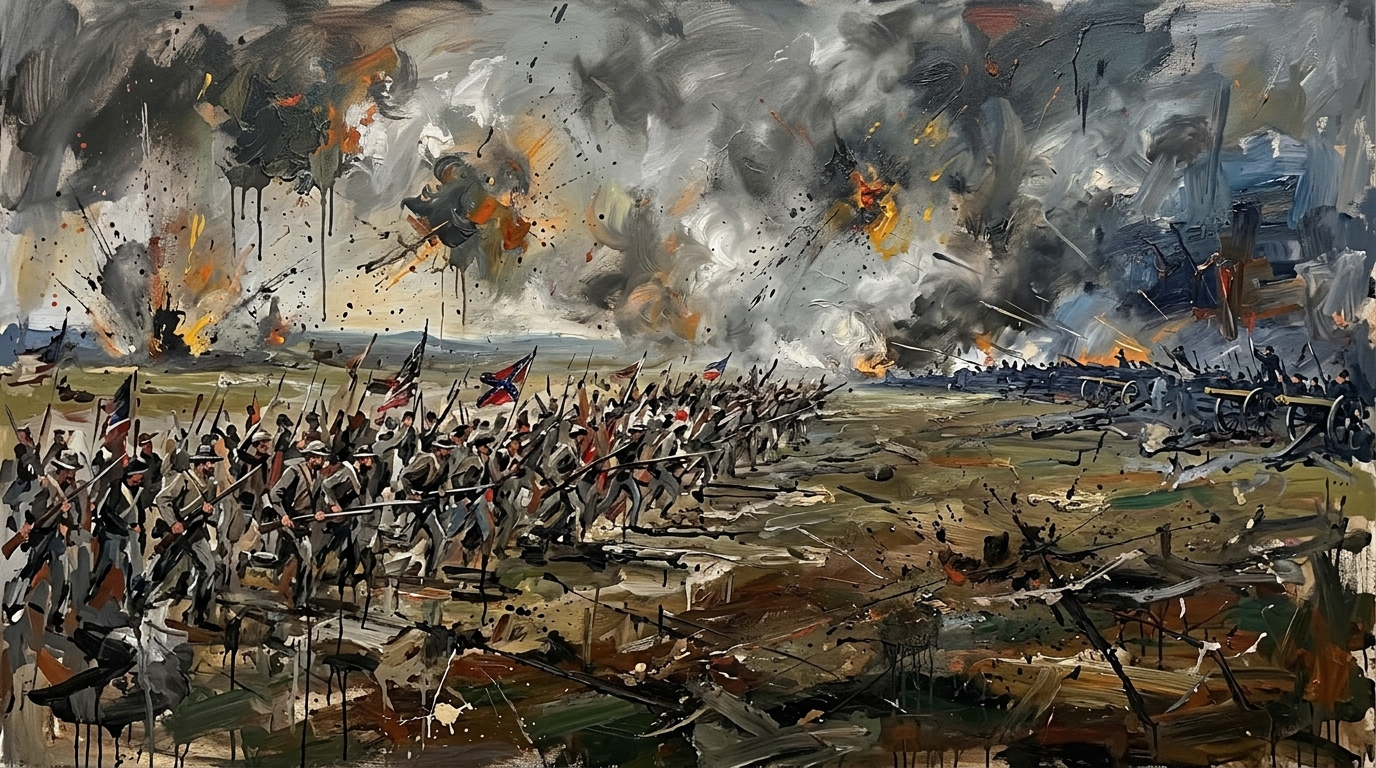
皮克特冲锋——葛底斯堡战役第三天(1863)— 抽象表现主义
历史上的今天
1863:葛底斯堡战役第三天,南军统帅李(Robert E. Lee)下令一万两千名步兵横穿一英里开阔地强攻北军中央阵地,史称「皮克特冲锋」(Pickett’s Charge)——半小时内伤亡过半,冲锋崩溃。这是美国内战的转折点,南方从此再没能力发动战略进攻。明天美国过 250 岁生日,而真正决定这个国家不会分裂成两个的那个下午,就发生在 163 年前的今天。
伊朗为二月被炸身亡的哈梅内伊举行全国哀悼,盟友齐聚德黑兰
Source · NYT / BBC · 2026-07-03 · link
Why this — 中东今年最大的权力真空,在拖了小半年后终于走到公开落幕这一步。
伊朗最高领袖哈梅内伊(Ali Khamenei)在今年二月的一次袭击中身亡,德黑兰今天启动为期数日的全国公祭,这是官方第一次以国葬规格公开处理他的死。各路盟友政要飞抵德黑兰出席,场面被安排成一次对内对外的团结展示。
哀悼在一个微妙的时点展开:美伊那份反复难产的停火与重建协议刚经历了瑞士签约仪式被取消、以色列强烈反对的一轮波折,伊朗内部对是否接受协议本就分歧很深。把最高领袖的葬礼办成盛大国家仪式,既是给国内一个情绪出口,也是向外界表明政权交接后运转如常。值得留意的是,NYT 另一条报道称美国官员一度判断以色列正密谋刺杀伊朗谈判代表——中东这盘棋,明面上的葬礼底下全是暗线。
美国六月就业报告:招聘放缓但仍在稳步扩张,华尔街和华盛顿都盯着
Source · NYT Business · 2026-07-02 · link
Why this — 就业数据是判断美联储下一步降不降息的核心信号,跟你的股票仓位直接相关。
六月非农就业报告显示美国劳动力市场「放缓但稳定」——新增岗位比前几个月放慢,但没有转向收缩,失业率维持在温和区间。这个「不冷不热」的读数让市场很纠结:太强会强化美联储按兵不动的理由,太弱又会重新点燃衰退担忧。
背景是新任美联储主席沃什(Kevin Warsh)刚在他的首次议息会议上维持利率不变,点阵图(dot plot,美联储官员对未来利率的匿名预测图)内部严重分裂,一部分人预期今年一次都不降、甚至有人押注加息,理由是伊朗战争推高油价、通胀创三年新高。就业若继续这种慢速扩张,等于给「按住不动」的鹰派多了一层底气。同期 NYT 还有一条相关角落新闻——就业市场让「华尔街和华盛顿双双紧张」,因为双方都怕自己误读了这条曲线的拐点。
中国为饱受争议的「民族团结进步」法辩护
Source · NYT World · 2026-07-03 · link
Why this — 观察北京如何用法律语言重新定义少数民族政策,是理解当代中国治理逻辑的一个切口。
面对国际批评,中国官方公开为一部新的「民族团结」法辩护。该法把「民族团结」写入具有强制力的法律条文,批评者担心这会进一步压缩少数民族的语言、宗教和文化空间,把「团结」变成一种自上而下的同化要求;北京则强调这是维护国家统一和各民族共同发展的正当立法。
这条新闻的看点不在法律条文本身,而在措辞之争——当「团结」「进步」这类正面词被写进硬性法律,反对它在字面上就变得很难。这跟中国近年一系列以发展、稳定、和谐为名的立法是同一套逻辑:用无法反驳的正面词汇锁定政策空间。
阿里巴巴禁止员工使用 Claude Code,理由是 Anthropic「间谍软件」担忧
Source · SCMP · 2026-07-03 · link
Why this — 你天天在用 Claude Code,而中美 AI 工具的地缘切割现在切到了具体的开发工具层面。
阿里巴巴内部下令禁止员工使用 Anthropic 的 Claude Code(就是你现在用来跑《侧目》的这个编程 agent 工具),理由是对其可能构成「间谍软件」(收集代码或环境信息回传)的安全担忧。这是中美 AI 对峙从模型层、芯片层,一路蔓延到日常开发工具层的一个新信号。
放到大背景里看更清楚:六月阿里刚在加州联邦法院起诉美国国防部,要求把自己从 1260H「军民融合」黑名单上移除;同期 Anthropic 因为美国出口管制令一度被迫下架 Fable 5 / Mythos 5,还闹出「禁止非美国籍人员使用」的风波。当美国用出口管制卡中国科技公司,中国大厂反手用「安全担忧」把美国 AI 工具挡在门外——这不是技术问题,是对称的地缘反制。对你个人的现实意义:这类工具的可用性正在变成一件跟护照、公司、司法辖区绑定的事。
谷歌因用安卓「封锁」竞争对手,被欧盟罚 41 亿欧元
Source · BBC Business · 2026-07-03 · link
Why this — 全球最大反垄断罚单之一尘埃落定,是平台垄断与监管长期拉锯的一个里程碑节点。
欧盟法院裁定谷歌利用安卓操作系统的市场主导地位「封锁」竞争对手,维持一笔 41 亿欧元(约合 48 亿美元)的天价罚款。核心指控是:谷歌通过把自家搜索、Chrome 浏览器与安卓授权强制捆绑,逼手机厂商预装谷歌全家桶,从而挤压其他搜索引擎和应用的生存空间。
这场官司拖了多年,最终罚款金额被维持,等于欧盟在「平台把操作系统当护城河」这件事上再次划下红线。对科技行业的信号是:靠系统级捆绑锁定用户、排挤对手的老玩法,在欧洲的法律成本越来越高——这也解释了为什么近年大厂在欧盟市场纷纷「解绑」默认设置。
扎克伯格对员工承认:AI agent 的进展没有他期望的那么快
Source · TechCrunch · 2026-07-02 · link
Why this — 一个花了几百亿美元 all-in AI 的 CEO 罕见地公开泼冷水,是当下 agent 热度的重要反向信号。
据 TechCrunch 报道,扎克伯格(Mark Zuckerberg)在内部对员工坦言:AI agent(能自主执行多步任务的 AI 系统)的进展没有他原本期望的那么快。这在满屏「agent 元年」「agent 将取代白领」的行业叙事里是一句难得的降温——而且出自一个把公司押在 AI 上、烧了天量算力的人之口。
结合同一天 TechCrunch 另一篇「Jersey Mike’s 三明治店 IPO 暴露了 AI 炒作有多离谱」的稿子看,业界内部对 agent 能力被高估的自我怀疑正在浮出水面。这对你有直接参考价值:你自己就在用 agent 跑选股、跑《侧目》,最有发言权的判断往往不是「agent 无所不能」也不是「agent 是泡沫」,而是扎克伯格这种「方向对、但比 demo 里看起来慢得多」的中间态。
Anthropic 正与三星洽谈定制 AI 芯片
Source · TechCrunch · 2026-07-02 · link
Why this — 前沿模型公司「去英伟达依赖」的又一步,牵动整条 AI 算力供应链。
TechCrunch 报道,Anthropic 正在与三星(Samsung)洽谈开发一款定制 AI 芯片。这延续了前沿模型公司想摆脱对英伟达(Nvidia)GPU 单一依赖的大趋势——训练和推理成本高企,谁能自己定制芯片、锁定一家代工大厂,谁就能在算力上拿到成本和供给的双重主动权。
对格局的意义:这是继亚马逊 Trainium、谷歌 TPU 之后,模型公司「自研或联合定制芯片」路线再添一员。三星如果拿下 Anthropic 这单代工,也是它在被台积电压制的先进制程竞争里撕开的一道口子。英伟达的近乎垄断,正在被这些「模型公司 + 代工厂」的组合从侧翼一点点凿开。
OpenAI 提议把 5% 股权捐给美国主权财富基金
Source · TechCrunch · 2026-07-02 · link
Why this — AI 公司主动向国家利益「上供」,是 AI 与国家资本主义合流的一个标志性动作。
据报道,OpenAI 提出把自身约 5% 的股权捐赠给一个美国主权财富基金(sovereign wealth fund,由国家持有和运营的投资基金)。以 OpenAI 当前的估值量级,5% 是一笔极其可观的资产——这个提议本质上是把公司的一部分所有权直接绑定到国家利益上。
放到整个板块看,这跟 SpaceX、Anthropic、OpenAI 今年扎堆冲刺 IPO、以及美国政府用出口管制深度介入 AI 的大势是一条线上的:前沿 AI 越来越被当成战略资产,公司也越来越主动地把自己「嵌进」国家框架,换取政策空间和保护。这是 AI 产业从「硅谷叙事」转向「国家资本主义叙事」的又一个注脚。
用离线评测的技巧,反而能让 A/B 测试更准
A More Accurate Algorithm Comparison through A/B Testing using Offline Evaluation Methods
作者 · Koki Konishi, Masataka Ushiku, Yuta Saito · arXiv:2607.01958 · link
一个反直觉的结论:A/B 测试——线上实验的黄金标准——在选「哪个算法更好」这件事上,错误率有时会高于离线评测。作者指出根源在于:A/B 测试用的是样本均值估计量,两个算法各测各的、互不相关;而离线评测因为两个算法共享同一批离线数据,会「无意中」制造出正相关,而这个正相关恰恰能压低最要命的那类错误——把真正更强的算法误判成更弱、把更弱的误判成更强。
基于这个洞察,作者提出一个新估计量:故意引入一个「中间算法 M」,用共享数据分步估计 A→M、M→B 的性能差,从而在 A/B 测试里人为制造出那个有益的正相关。实验显示,这个方法能用一半的 A/B 测试数据达到现有方法同样的选择错误率——直接省一半流量和时间。作者还推导了让方差最小的最优「中间算法」。
这篇几乎是照着你的日常痛点写的:你做实验平台时最烦的就是「样本量要多大、跑多久才能可信地判断 B 比 A 好」。它说的「共享数据诱导正相关来降低选择错误」,本质跟方差缩减里的 CUPED(用实验前协变量降方差)是同一家族的思路——都是在利用相关性省样本。作者是 Yuta Saito,off-policy evaluation(离线策略评估)圈的活跃研究者,这条线你以后做 recsys / 排序算法对比时值得盯。
NanoEuler
https://github.com/JustVugg/nanoeuler
一个从零用纯 C/CUDA 手写、GPT-2 规模的语言模型训练实现(不依赖 PyTorch/TensorFlow 这些框架,直接贴着显卡底层写)· 想真正搞懂「一个 Transformer 到底是怎么在 GPU 上跑起来」的 ML 学习者 / 好奇的 DS。
这类项目(精神上跟 Karpathy 的 llm.c 同宗)不是拿来生产用的,是拿来「拆开引擎盖看内部」的——你平时用 API 调模型,看不到底层;它把训练循环、反向传播、CUDA kernel 全摊在几千行代码里。你不写 C,但读它的 README 就能对「模型训练到底在算什么」建立比调 API 深一层的直觉。
r/algotrading · 我把「最蠢的趋势规则」拿去回测 BTC 和 SOL(3 年),胜率只有 30% 却依然很赚——盈亏比在扛所有活
OP 跑了一个能想到的最简单策略:日线收盘价上穿 20 日均线就做多,跌回均线下方就平仓,8% 止损,3 年、1000 美元本金、算上滑点、没有任何花哨过滤器。结果:BTC +79.5%(年化 21.9%,胜率 30%,最大回撤 −29%);SOL +263.9%(年化 55.6%,胜率 36%,最大回撤 −62%)。
最反直觉的地方:两个标的胜率都不到 40%,钱全是「赢的时候赢得大」赚来的——盈利单的平均盈利是亏损单的 3.8 到 4.7 倍。同一套规则套在波动更大的 SOL 上,收益和回撤被同时放大。这条帖子把量化里一条老理揭得很干净:你不需要经常对,你需要对的时候赚得比错的时候亏得多。
这条直接打你 SPP 的七寸——你的 paper trader 一直在纠结选股胜率,但这个案例说明胜率 30% 的策略照样能翻倍,只要盈亏比(R/R)够高。真正该盯的退出机制指标不是「多久判断对一次」,而是「让盈利单跑、把亏损单砍在小额」这条不对称。
r/MachineLearning · 只靠 logits 就能把微调数据一字不差地还原出来,不用碰权重
OP 团队做了个叫 CDD(Contrastive Decoding Diffing,对比解码差分)的方法:只需要「灰盒」访问权限——能看到模型输出的 logits(模型对下一个词的原始打分),拿不到权重、拿不到内部激活值——就能把一个窄领域微调过的 LLM 里的训练数据逐字还原出来。它基于此前一篇工作(微调会在「基座模型 vs 微调模型」的激活差里留下可读痕迹),但那个方法需要白盒(能看内部);CDD 把门槛降到只看输出打分。
Top 评论反应:
- u/CebulkaZapiekana(作者本人):「我们自己都很意外,只看 logits 的方法居然打赢了白盒方法。」
- u/ProfessionalSelf5403:「『Dr. Elena Rodriguez』那个例子又好笑又吓人——多少合成数据其实全是同一批被幻觉出来的假名字翻来覆去。没想到光靠 logit 差就能拉出完整句子。」
这是一条「模型比你以为的更漏」的安全提醒:很多公司以为只开放 API(不给权重)就安全了,但这篇说明连输出打分都足以反推出你微调时喂进去的私有数据。你自己做 AI 项目、或公司部署内部微调模型时,「不给权重 ≠ 数据不外泄」这条要记住。
r/LocalLLaMA · 后续实测:DeepSeek V4 Flash 跑在 2 张 RTX PRO 6000 上,做真实编程任务比调 API 的 Sonnet、Opus 更快
OP 拿本地部署的 DeepSeek V4 Flash(用 vLLM 推理框架跑在两张 RTX PRO 6000 显卡上)做了一套自建的「真实编程任务」基准。结论:质量大致落在 Sonnet 一档,而完成整个任务的墙钟时间(wall-clock,从开始到结束的真实耗时)比走 API 的 Sonnet 或 Opus 都短——DeepSeek 本地约 2 分钟一个任务,Sonnet 5 走 API 反而最慢,约 6 分钟。OP 也诚实标注:质量上限 Opus 和 Fable 仍然更强,本地只是「够用且快」。
这条帖的分量在于:本地开源模型 + 消费级/工作站级显卡的组合,正在把「又要快、又要私密、又不烧 API 额度」这个三角变成现实——哪怕最强质量还归闭源。
这条是给你「本地跑 vs 调 API」这笔账加了一个新数据点:本地模型未必最聪明,但在「快 + 不外传 + 不计 token」上开始有真实优势。对你这种高频用编程 agent 的人,真正该算的不是「本地能不能顶替 Opus」,而是「哪些任务其实用不上 Opus,本地跑更划算」。
r/slatestarcodex · AI 超级预测者来了
一篇讨论 AI 在「预测未来事件」这件事上是否已经追平甚至超过人类顶级预测者(superforecaster,指在 Tetlock 预测锦标赛里持续跑赢基准的那批人)的帖子。核心议题:当 LLM 开始在预测校准度上逼近人类专家,我们对「专业判断」这件事的定价要不要重估——如果一个模型能又快又便宜地给出校准良好的概率估计,人类预测者的稀缺性还剩多少。
(注:本期 Reddit 端点在抓取时段被限流,此帖 top 评论未取到,正文按主帖内容整理。)
这跟你做量化、做实验的世界底层是同一个问题:预测的价值 = 校准度 × 稀缺性。AI 把「给出校准良好的概率」这件事变廉价之后,护城河就从「会不会预测」转移到「预测什么别人预测不了的」。放到 dinner party 聊很好用——超预测者是行为经济学里的经典话题。
r/dataisbeautiful · [OC] 7.5 万美元年薪扣完联邦税、州税、工资税之后到手多少,按州划分(2026 税年)
一张按州对比「7.5 万美元税前薪水扣税后实际到手」的可视化图。同样的名义工资,在不同州因为州所得税差异,到手金额能差出一截——无州所得税的州(如德州、佛州、华盛顿州)看起来明显更「留得住钱」。
Top 评论反应(这条的评论比图本身更值钱):
- u/descendency:这图漏了房产税和销售税——很多「低所得税」的州正是靠狠收房产税来补,等于把一大块税负藏起来了。
- u/snowbeersi & u/Tavarin:就算你不买房,租金里也含了房东转嫁的房产税,房产税高 → 租金高,跑不掉。
- u/CincyAnarchy(反驳):房产税率和租金价格其实没那么强的相关,不能简单 1:1 加进来,这块很难精确统计。
湾区的隐藏成本正是评论区吵的这个点:加州所得税高得肉眼可见,但真正掏空你的是房产/租金那一层。这张图的教训是——比税率要看「总税负 + 生活成本」,单看到手工资会严重误判两地的真实差距。
harvard-edge/cs249r_book ⭐26k · [Python]
https://github.com/harvard-edge/cs249r_book
这是干什么的:哈佛开的《Machine Learning Systems》(机器学习系统)免费在线教科书的开源仓库。它讲的不是「怎么训练一个模型」,而是「怎么把模型真正部署到现实世界里跑起来」——从云端到手机到嵌入式设备(TinyML,指在微控制器这种极小算力硬件上跑 ML)的整条工程链路。
技术解读(你是 DS 不是 SWE,这里把术语拆开讲):
- 覆盖内容:数据管线、模型部署、边缘推理(edge inference,把模型放到设备本地而不是云端跑)、MLOps(把 ML 模型的训练-部署-监控做成像软件工程那样规范的一套流程)、硬件加速等——都是「模型训练完之后」的世界。
- 跟你工作的关系:你在公司做 busway 热成像、无人机帐篷巡检这些 CV(计算机视觉)项目,痛点往往不在建模,而在「模型怎么可靠地跑在现场设备上、怎么监控、怎么迭代」——这本书正好补的是 DS 教育里最常缺的「systems」那一块。
这不是拿来 clone 跑代码的仓库,是拿来读的——你平时更偏「把模型做出来」,而 L5 及以后越来越需要「把模型做成可靠的系统」这层视角。挑「部署」和「MLOps」两章翻一下,正好对上你手里两个 CV 项目从 pilot 走向落地时会撞到的工程问题。
No Priors · 核聚变如何解锁能源的极大丰裕——对话 Valar Atomics 创始人 Isaiah Taylor
主持 Sarah Guo + Elad Gil · 嘉宾 Isaiah Taylor(Valar Atomics 创始人兼 CEO,刚让美国 50 年来第一座初创公司造的先进反应堆发电)· 2026-07-02 · YouTube
这期在 Valar 位于犹他州的核设施现场录制,聊的是一件正在被 AI 算力需求重新点燃的事:为什么核能这个 1940 年代的老技术,直到今天才可能迎来它的「福特时刻」。
这期讲了什么:
- 核心论点——核能从没有过量产化。Isaiah 说核裂变技术很老,但人类从来是「建造」反应堆(像盖大楼一样一座座定制施工),而不是「制造」(像福特造车、特斯拉造电池那样标准化量产)。Valar 的整个赌注就是:把反应堆做成「更多是被制造出来、而不是被建造出来」的东西,靠此把能源成本压低 10 倍。
- 诊断整个行业病根:「核能产业大部分是个建模和仿真产业,而不是硬件迭代产业」——大家忙着做模拟、走审批,没人真在快速迭代硬件。这句话对任何搞工程的人都是当头一棒。
- 技术选型讲得很实在:他们用 TRISO 燃料 + 石墨慢化 + 氦气冷却的设计。氦是惰性气体,几乎不发生化学反应,不像水冷堆那样要死死盯着蒸汽干湿度、否则腐蚀整套热机械设备——代价是氦密度低、要更大泵功,但换来一个「结构极简」的电厂。整个电厂(连带控制室)是用 C17 运输机整体空运到现场的,「这是史上第一次这么干」。
- 安全 = 后果最小化,而非只压低概率。他反复强调「odds vs consequence」(出事概率 vs 出事后果)这对框架:他们这套堆型的几何设计让「万一出事的后果」尽可能小,而后果越小,就越能放开手脚加速、越能规模化——安全和速度在他这里不是对立的,是同一件事。
- 人才哲学很反行业:他深度介入每一个招聘决定,专门筛「极端能动性 / 极强行动偏好」的人,而且很多人来自核工业之外——「他们走进来时从没见过反应堆,但他们在现实世界里造过难的东西」。他还特别爱挖「因为热爱核能入行、又受不了它慢、愤而出走去别处造硬件」的人,再把他们劝回来。
- 能源是唯一的输入:他把能源当成纯商品——需求由价格决定,你只要把能源做得足够便宜,需求自然会出现(AI 算力就是那个新增的巨大需求源)。他信「核裂变会让能源便宜一千倍」,剩下的只是「这发生在未来几十年还是未来几个世纪」,而这取决于团队跑多快。
金句:
「核能从来没有过它的福特时刻,或者说特斯拉时刻。」 —— Isaiah Taylor 「我们每次都是朝着最复杂的东西、迎着枪火往前冲。」 —— Isaiah Taylor
这期把「AI 算力荒 → 能源需求爆炸 → 核能创业窗口打开」这条你 feed 里反复出现的暗线,落到了一个真在犹他州拧螺丝、把控制室用运输机空运过去的创始人身上。最值得抄走的不是核物理,是他那套「这个行业病在只做仿真不迭代硬件、我们靠把后果做小来换速度」的工程哲学——这套「run toward gunfire、把六个月压成四周」的心态,跟你在公司推 CV 项目落地时想要的那种执行力是同一种。
烧瓶(FLASK)
Source · Rock Paper Shotgun · 2026-07-03 · link · 新 demo 上线 Steam
一款「炼金术自走棋 + 卡牌构筑」的黑色幽默独立游戏 · PC(Steam 有可玩 demo)· 丹麦 Chop Chop Games 开发,Deep Rock Galactic 的发行团队 Ghost Ship 参投。
Review 主旨:
你扮演一个资不抵债的炼金术士,靠招募并升级一队小怪(homunculi,人造小人)去猎杀奇幻巨兽、抽取它们值钱的血来还债。这游戏最核心的特色机制在这里:你构筑的「牌组」不是普通卡牌,而是一组组烧瓶——你按自己设定的顺序让每个小人在自动战斗中依次「灌」下这些药水来获得各种效果,而把药水排成特定序列还会触发元素加成。换句话说,构筑的重点从「选哪些牌」变成了「怎么排药水的先后顺序来凑出最猛的鸡尾酒配方」,这是它跟普通自走棋/卡牌最不一样的地方。
多人玩法也很妙:是异步的炼金术士对轰——你那队小人(带着你最近一次的烧瓶配置)会作为一个 Boss 遭遇战,出现在别的玩家的战局里;你在对方毫不知情的情况下击败对方,就能爬全服「血财」排行榜。RPS 作者一边自嘲「这游戏融合了三种我通常都不感冒的玩法(自走棋 + 卡牌构筑 + roguelike)」,一边承认它的美术和机制勾得他动心——画风是丹麦画师 John Kenn Mortensen 的手绘,扭曲比例、毛糙质感、空洞眼窝,配上刻意僵硬的动画,透着一股讲究的「恶心感」和纸偶质感。
这个直接踩你两个 ★★★★★ 内核的交集——自走棋 + 卡牌构筑一锅炖,而且它的特色机制不是「又一个 StS-like」,是「牌组变成药水序列、靠排列顺序凑元素连招」,这种「排序即玩法」的 oddity 正是你说的「我从没见过的设计」那一类。关键词负载看着也不重(招小人、排药水、凑元素),符合你要的 StS 那种「小规则面 + 大决策空间」;异步 Boss 入侵还免了你嫌的 squad-required 多人门槛。Steam 上 demo 免费,是这周最对味的一个。