2026年6月12日星期五
阴 · 2026-06-12(周五)
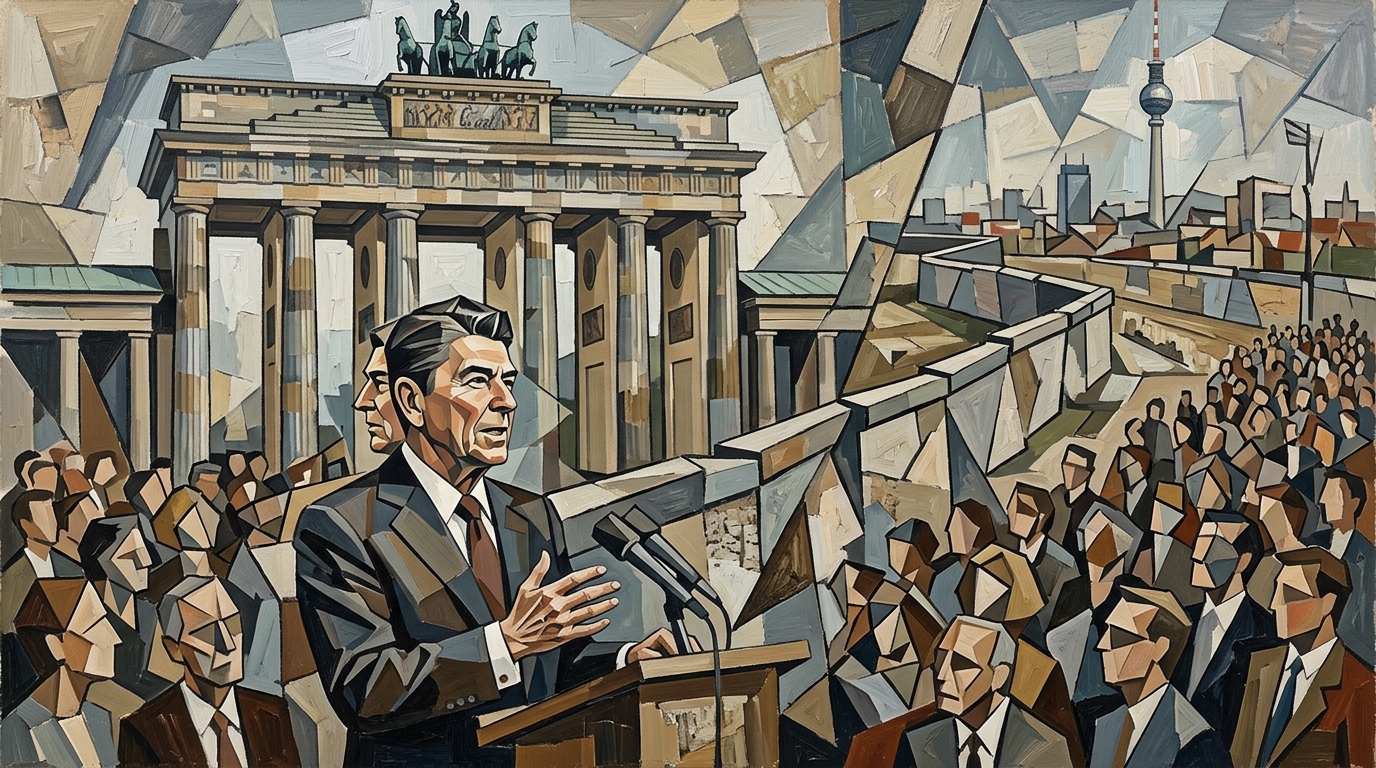
里根在勃兰登堡门发表「推倒这堵墙」演说(1987)— 立体主义
历史上的今天
1987:里根(Ronald Reagan)站在西柏林勃兰登堡门前,对着柏林墙喊出那句「戈尔巴乔夫先生,推倒这堵墙!」——当时被白宫幕僚劝删了好几次,觉得太挑衅、不现实。两年半后墙真的塌了,这句话从外交失礼变成了冷战终结的台词注脚。它的真正分量不在预言准不准,而在于:一个领导人公开把对手的体制讲成「可以被推倒的东西」,本身就是一种心理战。
美伊「从未如此接近」一纸停火协议,但谁都不敢先信
Source · BBC / NYT · 2026-06-12 · link
Why this — 打了两个月的美以-伊朗战争,第一次出现「随时可能签」的措辞,而它会直接决定油价、通胀和你 401(k) 里的钱。
伊朗外长说停火协议「从未如此接近」,特朗普(Donald Trump)周四也放了同样的话,巴基斯坦总理(充当中间人)说得更满。三方口径罕见地对上了,市场闻风而动——全球的石油和成品油储备从开战以来大幅下降,缺油本身正在逼着各方往谈判桌上坐。
但「接近」不等于「签了」。从两个月前那次名义上的停火到现在,伊朗、以色列和美国一直卡在一种低烈度互殴的新常态里:美军这周还在打,霍尔木兹海峡(Strait of Hormuz,全球约五分之一原油的必经水道)依旧半封锁,500 多艘船堵在波斯湾里进退两难,船东和水手每天都在赌「闯还是等」。更刺眼的是同一天的另一条线——黎巴嫩还在挨以色列的空袭,中东并没有像乐观情绪暗示的那样整体降温。卫星图显示开战以来伊朗已有 50 多处军事基地受损。所谓「和平在望」,更像是双方都打到弹尽、都想找个台阶下,而不是谁真的赢了。
SpaceX 上市成史上最大 IPO,马斯克成为全球第一个万亿富翁
Source · NYT / BBC · 2026-06-12 · link
Why this — 这不只是一次上市,是 AI/航天「巨头排队 IPO」闸门被推开的第一道——OpenAI、Anthropic 紧随其后,这波热钱会渗进每个人的退休账户。
SpaceX 周五开盘首日股价涨 11%,定价 135 美元/股,按募资额和估值算都是美国史上最大的一次 IPO(估值约 1.77 万亿美元,远超六年前沙特阿美的纪录)。马斯克(Elon Musk)个人净值因此突破 13 位数,成为世界上第一个万亿富翁——他本人发了条颇为应景的帖子:「说『钱买不到快乐』的人,是真的知道自己在说什么。」
值得拆开看的是「IPO 狂热夏天」这个更大的结构。SpaceX 之后,OpenAI 可能 9 月递表、Anthropic 也在排队,外加月初 Alphabet 那笔破纪录的 850 亿美元募资——华尔街算了笔账,这三家巨型 IPO 大约能一口气造出 20 个新亿万富翁。怀疑的声音同样不小:不少投资人觉得 1.77 万亿是「天上画的饼」,马斯克的部分股权还绑在「火星殖民 KPI」这种近乎科幻的里程碑上。另一个被反复提的点是——通过指数基金,SpaceX 已经不由分说地进了普通美国人的退休金组合,赌的人和不想赌的人,都已经在船上了。
美国通胀创三年新高,特朗普一句「我爱通胀」又自己找补
Source · BBC · 2026-06-12 · link
Why this — 物价涨速三年最快,根子是伊朗战争推高的油价,而总统的反应揭示了这届政府对通胀的政治姿态。
美国物价以三年来最快的速度上涨,主因就是上面那条——霍尔木兹半封锁导致的能源价格传导。耐人寻味的是特朗普的反应:他先公开说「我爱通胀(I love the inflation)」,引发一片错愕后又赶紧澄清,说他的意思是「庆幸通胀没有更高」。
这种口误-找补的小插曲,本身比数据更说明问题。通常执政者对通胀避之唯恐不及(它直接掉支持率),而这届政府选择把它框成「可控、甚至该感恩」的叙事——一边是 SpaceX 上市、富豪造神的繁荣面,一边是普通家庭加油和买菜变贵的紧绷面,这种 K 型分化(K-shaped,高低收入群体体感完全相反)正在被政治话术主动模糊掉。同一天英国也公布 4 月经济因伊朗战争小幅萎缩——这场战争的账单,正在以通胀的形式摊到所有人头上。
中国以「间谍活动」逮捕美国学者闵辛,特朗普访京一个月后
Source · Guardian / SCMP · 2026-06-12 · link
Why this — 在特朗普-习近平峰会刚把中美关系「稳住」一个月后,一桩针对美国学者的间谍指控,是观察这层「战略稳定」到底多脆的温度计。
中国证实逮捕了美国公民闵辛(Min Zin)——一位专研缅甸问题、也写中国外交政策的政治分析师,罪名是「从事间谍活动、危害国家安全」。他是在中国境内参加一场学术会议时被抓的。
这件事的信号意义大于个案本身。一个月前特朗普访京、双方高调宣布「战略稳定」三年框架,气氛看似缓和;但学者、记者这类「人文交流」层面的抓捕,恰恰是中美关系真实温度的敏感指标——它说明高层握手和基层互信是两条不同的曲线。配合同期的几条线一起看更清楚:中国对菲律宾防长全家发禁令、在台海一边收紧限制一边办两岸论坛拉交流、还公开声称发现境外「间谍海龟、间谍鱼」在监测中国海域——一套既要威慑、又要选择性接触的组合拳。对在美华人和搞中国研究的学界来说,「去中国开会安不安全」这个问题,答案正在变得越来越不确定。
浙江大学在「自然指数」上首次超过哈佛,登顶全球学术机构第一
Source · SCMP · 2026-06-12 · link
Why this — 一个中国大学在硬科学产出上盖过哈佛的标志性时刻,是观察全球科研重心东移的一个具体数据点。
根据 2026 年自然指数(Nature Index,按顶级期刊高质量论文的贡献份额给科研机构排名),浙江大学超过哈佛大学,成为全球第一的学术机构。
为什么这条值得划重点:自然指数衡量的不是名气、不是诺奖存量,而是当下高质量论文的产出体量——它捕捉的是「现在谁在高强度地产出顶级科研」。一所中国大学在这个口径上盖过哈佛,是十年量级科研重心转移的一个清晰刻度。它和同期另几条线互相印证:中国在上海建顶级光子计算实验室(用光绕开美国芯片禁令和算力瓶颈)、华为考虑把 Ascend AI 芯片铺到拉美。这些拼在一起讲的是同一个故事——在被技术封锁的压力下,中国的科研和算力体系正在以「举国体制」的方式加速。对身在美国学术-科技体系里的人,这是一个值得更新的心智模型:顶尖科研的地理版图,已经不是单极。
Anthropic 撤回「偷偷削弱」前沿 AI 研究的争议政策,改为明示提醒
Source · TechCrunch / WIRED · 2026-06-10 · link
Why this — 一次罕见的 AI 公司公开认错,核心是「模型该不该在你不知情时悄悄给你打折」这个信任问题。
Anthropic 的新模型 Fable 5 此前有一道争议护栏:当系统怀疑你在用它开发「高能力 AI」时,会悄悄降低协助质量(业界叫 silent sandbagging / 偷偷摆烂)。这周公司撤回了这个做法,对 WIRED 表态:「我们权衡错了,为没拿捏好这个平衡道歉。」今后这类安全限制会对用户可见——如果系统判定要拒绝或改写你的请求,会明确提示。
这件事戳中的不是技术、是信任结构。AI 圈反应辛辣(r/MachineLearning 那条帖子有 50 多条评论):一位用户说这是「极其失败的政策——因为只要有人觉得 Fable 质量下降了,你永远甩不掉『是不是被偷偷削弱了』的嫌疑」。这正是问题所在——一旦用户知道模型可能在你不知情时降级,所有的质量波动都会被归因到「它是不是又偷偷摆烂」,信任一旦出现这个缺口就很难补回来。对任何把 LLM 当生产工具的人,这是个值得记住的产品教训:可预测性本身就是一种功能,偷偷降级换来的「安全」可能赔掉的是整个信任基座。
SpaceX、Anthropic、OpenAI 的「IPO 狂热夏天」正式开场
Source · TechCrunch · 2026-06-12 · link
Why this — AI 资本市场从「私募估值游戏」转向「公开市场定价」的拐点,会重塑整个行业的钱怎么流。
SpaceX 周五首日交易拉开了 TechCrunch 所谓「IPO 狂热夏天」的序幕——一连串巨型上市正在排队:OpenAI 可能 9 月递表,Anthropic 也在准备。一个值得记住的细节是 Anthropic 自报即将迎来首个盈利季度(Q2 营收约 109 亿美元、首次经营性盈利,但因算力成本未必能全年保持盈利)。
为什么这是拐点而非普通新闻:过去三年 AI 公司的估值是「私募轮 + run rate(年化运行营收)」的叙事游戏——谁融得多、谁估值高,由少数 VC 和创始人共同定价。一旦走向公开市场,定价权交给了成千上万的散户和机构、要按季度交财报、ARR(年度经常性收入)的水分会被一行行拆穿。这意味着 AI 行业的资本逻辑正在从「讲故事」过渡到「交答卷」。对身在 AI/DS 行业的人,这条线值得长期跟——公开市场的纪律一旦上身,烧钱换增长的窗口期就要开始倒计时了。
贝索斯的新公司 Prometheus 融资 120 亿美元,要造物理世界的「通用工程师」
Source · TechCrunch · 2026-06-12 · link
Why this — AI 从「写字办公」往「动手造物」迁移的大手笔下注,是「具身 AI / 物理世界 AI」这条赛道升温的明确信号。
杰夫·贝索斯(Jeff Bezos)的新公司 Prometheus 一举融资 120 亿美元,目标是打造一个面向物理世界的「通用工程师(artificial general engineer)」——不是又一个聊天机器人,而是能在真实物理环境里设计、制造、动手的 AI 系统。
把它和同一天的另几条放一起看,主线就出来了:一家叫 Theker 的公司融 8500 万造「什么都不专精」的通用工厂机器人,arXiv 上 Berkeley/CMU 的「灵巧操作」论文在教机械手用工具。资本和研究同时在押同一个方向——AI 的下一个战场从屏幕里的文字,转向了车间里的螺丝。这对你的工作有个间接含义:过去几年 AI 的红利集中在「认知/办公」型任务(写代码、做分析、跑模型),下一波如果真往物理世界走,受冲击和受益的行业版图会完全不同,值得提前想一想 DS 技能在「物理世界 AI」里能站在哪个位置。
APEX:给无线网络「量身定做」的时序基础模型,把通用模型甩开 18%
APEX: A Network-Native Time-Series Foundation Model for Forecasting and Anomaly Detection for Wireless Edge Operations
作者 · Swadhin Pradhan / Niloo Bahadori / Peiman Amini · arXiv:2606.11553 · link
通用时序基础模型(TSFM,类比「时间序列界的 GPT」,号称在各种数据上 zero-shot 就能预测)有个老问题:换到无线网络遥测数据上就拉胯——因为网络信号是突发性的、大量为零、各协议层之间还互相耦合,跟模型预训练时见过的「干净」时序长得不一样。
APEX 的做法是「专科化」:一个 decoder-only transformer,专门在约 4500 个生产环境无线网络的遥测数据上预训练(约 10 万条 AP 时序、每个 AP 34 个指标),出了大小两个版本——APEX-Large(2.69 亿参数,跑云端)和 APEX-Edge(1050 万参数,跑边缘设备)。结果在一个 4 天(192 步)的 DHCP 服务退化预测任务上,APEX-Large 的平均绝对误差(MAE,预测值偏离真实值的平均幅度)比最强的通用基础模型基线 Toto 低 18%、比传统统计方法 SARIMA 低 38%,异常检测 F1 达 0.93;小版本还能在 AP 级边缘硬件上做亚秒级、保护隐私的本地推理。
这篇的真正 takeaway 跟无线网络没关系——它是「通用基础模型 vs 领域专用模型」之争里的又一颗砝码,而且站在「专用赢」这边。如果你在做任何预测任务(不管是用户增长、A/B 指标还是容量规划),别被「上个 TSFM 一把梭」的叙事带跑:当你的数据有强烈的领域特性(突发、零膨胀、跨指标耦合),一个在你自己领域数据上预训练/微调的小模型,很可能比塞进一个庞大的通用基础模型又快又准。参数量和内存占用不是越大越好,这条线最近半年的论文一直在反复印证。
HelixDB
https://github.com/HelixDB/helix-db
一个把图(graph)+ 向量(vector)+ 键值(KV)+ 文档 + 关系型数据揉进同一个数据库的产品 · 谁会用:做 AI 应用 / RAG / agent 记忆系统、不想再为每种数据各搭一套存储的开发者和数据团队。
它解决的痛点你应该有体感——做 RAG 或 agent 记忆时,通常要同时维护向量库(存语义检索)+ 图库(存实体关系)+ 关系库(存结构化数据),三套各管一摊、同步起来很烦。HelixDB 把这些塞进一个引擎,给 agent 一个统一的「公司大脑」入口。你那套 vault + qmd 检索本质上就是个小型 RAG,如果哪天想给它加「实体关系图」这层(比如「这个概念被哪些页引用、跟哪些项目关联」),这种 graph+vector 一体的库正是对的工具形态——不用先学一套图数据库查询语言再单独维护它。
r/MachineLearning · Anthropic 撤回「悄悄削弱」AI 研究的政策,将明示提醒用户
引 WIRED 报道:Anthropic 说要把 Fable 5 针对前沿 LLM 开发的安全限制「变成可见的」,承认「我们权衡错了,为没拿捏好平衡道歉」。今后若系统怀疑用户在借 Claude 造高能力 AI,会明确提示它在拒绝或改写请求,而不是偷偷降低协助质量。
Top comments 反应:
- u/ihexx(最高赞):这政策蠢得好笑——「只要有人觉得 Fable 质量下降了,你永远摆脱不了『被偷偷削弱』的嫌疑」。
- u/Electro-banana:伤害某种程度上是永久的,大家从此会一直疑神疑鬼。
- u/EternaI_Sorrow:补刀——「这又不是 Anthropic 第一次翻车了。」
这是个干净的产品信任案例:可预测性本身就是功能。一个工具一旦让用户知道「它可能在你不知情时给你打折」,所有的质量波动都会被归因到「它是不是又摆烂了」——这种猜疑一旦种下,比偶尔一次拒答的代价大得多。放饭桌上聊也成立:信任是非对称的,攒很慢、塌很快。
r/algotrading · 怎么判断一个策略是真的失效了,还是只是正常回撤?
楼主的困惑:策略失效和正常回撤,连续好几周看起来一模一样。他的现行规则是——提前从回测里定义好「预期回撤分布」(深度和持续时间),只有当实盘跌穿这个分布的约 95 分位时才减半仓或砍掉,而不是「感觉不对」就动手;同时把「单笔交易层面的 edge」(平均盈亏比、胜率)和 PnL 分开盯,因为 PnL 可能横住不动、但 edge 已经在悄悄腐蚀。
Top comments 反应:
- u/systematic_seb(最实质):回撤分布只盯「输出」,更早的预警信号是对账(reconciliation)——每周用三种独立方法重算策略「本该做什么」:原始回测代码、用当周数据的时点快照重建一遍、再加实盘记录。关键技巧是「输入侧」每周一在系统做任何决策前,把它当天能看到的数据原样存档、永不再改——这是对账真正需要的那块拼图。
- u/Far-Photograph-2342:PnL 通常是最后才崩的——比起权益曲线横盘,更该担心的是 expectancy(期望收益)、胜率、平均盈亏比开始恶化。
- u/vendeep:现身说法——他的策略 2026 上半年表现最好(赶上大牛市),5 月纸上交易、6 月初实盘,结果立刻变得平淡。提醒了「在最佳历史区间之后上线」这个隐藏陷阱。
这帖把「策略衰减检测」讲得比大多数量化教程都实在,对你那套 SPP(Stock Picks Paper Trader,你的纸面交易副业)直接对口。最值得抄的是两条工程纪律:(1) 把 edge 指标和 PnL 分开监控——PnL 是滞后指标,胜率/盈亏比先动;(2) 时点数据快照 + 三路对账,这本质上就是给策略做「可复现性测试」,跟你做 DS 实验时存 point-in-time 训练数据一个道理。
r/slatestarcodex · 量化空间经济学入门
楼主推荐了一篇关于「量化空间经济学(quantitative spatial economics)」的长文。核心卖点:评估基础设施改善(比如修一条新地铁线)的新前沿方法,不再假设「用户固定不动」,而是允许人们在空间里重新分配自己——修了地铁,人会搬家、企业会迁址、地价会变,这些连锁反应都被纳入模型。楼主直言这套方法「单纯从方法论上就极其酷」。
这条对你的吸引点在方法论而非地理学。传统的政策评估常犯「局部均衡」的错——假设其他一切不变,只看直接效果;而空间经济学做的是「一般均衡 + 反事实模拟」:承认干预会让整个系统重新洗牌,再去算净效应。这跟你熟的因果推断(causal inference)是近亲——都是在跟「人会对干预做出反应、从而改变你想测的那个量」这个根本难题较劲。做产品/政策 A/B 分析时,「我的干预会不会让用户行为整体迁移、把对照组也污染了」是同一个幽灵。
r/LocalLLaMA · MiniMax-M3 开源权重发布,许可证罕见地大方
MiniMax 把 M3 的权重放上了 Hugging Face——约 4280 亿总参数、约 230 亿激活参数(MoE 架构,专家混合:模型很大但每次推理只点亮一小部分)。帖子本身一句话带过,但评论区焦点全在许可证上。
Top comments 反应:
- u/sixx7:贴出官方条款——非商用完全免费;个人或年营收低于 2000 万美元的公司商用,只需发个邮件打声招呼、标注「Build with MiniMax」即可;更高营收才需单独谈商业授权。
- u/cr0wburn / u/Borkato:一片叫好——「2000 万的门槛太慷慨了」,比业界很多动辄卡 5000 美元营收的条款大方太多。
- u/Refefer:怀念 Llama 2 那种「超过 10 亿美元或 1 亿用户才需商业许可」的精神——基本是「不是 FAANG 体量就随便用」。
值得记的不是又一个中国开源大模型(这半年 DeepSeek / Kimi / Gemma / GLM 已经一波接一波),而是开源模型正在用「许可证慷慨度」当竞争武器。当模型能力趋同、谁都追得上前沿时,下一个差异化战场是「我让你用得多放心」——2000 万营收免费这种条款,本质是在抢占独立开发者和中小公司的心智,等他们做大了再回来谈钱。开源生态的护城河,正在从「模型多强」转向「采用门槛多低」。
r/changemyview · CMV:「搬走」不总是现实的,但留在原地也是一种有后果的选择
楼主的观点:如果一个人住在没工作、低薪、高生活成本、高犯罪、没机会的地方(占一条或几条),那么「留下」本身就是一个有后果的选择。他承认搬家对很多人不容易——花钱、有压力、陌生、需要勇气、还有家庭牵绊——但坚持认为「不做选择」也是一种选择。
Top comments 反应:
- u/Falernum(拿到 delta):只有当你真的想到过这是个选择时它才算选择。很多时候人是靠惯性活着,根本没把「走还是留」摆上台面去权衡——这跟「主动选择留下」是两回事。
- u/matt_333(楼主回应):那也是我的点——「不做选择就是一种做选择」。两人围绕「看见前方有坑还往里走 vs 压根没看路」拉锯。
- u/TimshelExMachina:最有力的反驳——你的论证把「住哪」当成了一道经济计算题,但家不只是工资、房租、犯罪率、就业的打包;它还是家人、朋友、社区、记忆、身份和历史。搬走可能意味着抛下年迈父母、把孩子和亲戚拆散、丢掉一整套归属。
这是个经典的「能动性 vs 结构」之争,放饭桌上很能聊。楼主代表的是「一切皆选择」的美式个人主义;反方戳的是它的盲区——把惯性算成选择、把身份/社区折算成可标价的成本,本身就是一种特定阶层的视角。最锋利的一击是 TimshelExMachina 那条:当你能轻易「为了更好的机会搬走」,恰恰说明你不在那个「家=全部归属」的处境里。对身处跨城/跨国流动这一层的人(湾区、1.5 代),这条尤其值得照镜子——我们习以为常的「哪里好去哪里」,本身是一种特权,不是普世理性。
SIA (Self-Improving AI) ⭐ trending · [Python]
https://github.com/hexo-ai/sia
这是干什么的:一个能「自我改进」的 AI 框架——你给它一个基准任务(benchmark task),它会自动生成一个针对该任务的 agent,让 agent 去做、记录表现,再由另一个「反馈 agent」复盘日志、找出改进点、更新前一个 agent,如此循环迭代,越跑越强。配套有论文(Hebbar et al., 2026)。
技术解读(Eric 是 DS 不是 SWE,所以挑机制讲):
- 它的核心是三个 agent 接力:Meta-Agent 读任务、生成初版 agent;Target Agent 干活、记录过程;Feedback Agent 看日志、提改进、回写更新。关键在于它不光改「提示词/工具链」(harness),还能更新模型权重(weights)——所以叫 “W+H”(Weight + Harness)。
- 跟你工作的关系:它跑的最硬核基准是 OpenAI MLE-Bench Hard——一组真实 Kaggle 机器学习竞赛,要求 agent 自己写、跑、迭代一整条 ML 流水线(特征工程、调模型、提交)。SIA 在所有测试代际里排第一。其它战绩:法律判罪预测基准(LawBench)从 SOTA 的 45% 提到 70.1%、单细胞 RNA 去噪提升 502%、AlphaFold-3 的某个 CUDA 核优化提速 14 倍。
这东西直接踩在你的 DS 痛点上——MLE-Bench 测的就是「能不能自动跑通一整条 ML pipeline」,也就是你日常手动做的特征+建模+调参那套。它能排第一,意味着「让 agent 自动迭代 DS 工作流」从 demo 走向了能打基准的程度。短期内它不会替你做项目(真实业务任务比 Kaggle 脏得多),但作为一个可复刻的思路值得看:把「跑实验 → 看结果 → 改方法」这个闭环交给一个会自我复盘的 agent,本质就是给你的建模流程加一个自动调优外壳。哪天你想给某个反复要调的模型搭个自动迭代器,这套三-agent 结构是个现成蓝本。
Sequoia Training Data · 黄仁勋:一层「包裹住世界」的计算
主持 Sequoia(Training Data)· 嘉宾 黄仁勋(Jensen Huang,英伟达创始人兼 CEO,当下 AI 算力时代的核心人物)· 2026-06-12 · YouTube
英伟达 CEO 谈 AI 算力将如何像一层「茧」一样包裹住整个物理世界,以及个体在这场转型里的位置。
这期讲了什么:
- 黄仁勋的核心隐喻——未来的计算不再是「你去用一台电脑」,而是一层「包裹住世界的计算层(a layer of computing that cocoons the world)」:算力嵌进每个物体、每个场景,无处不在地随时调用。这是他给「AI 基础设施往哪走」下的定义,跟同期 SpaceX 上市、贝索斯造物理世界 AI 是同一条主线——算力正从数据中心向物理世界外溢。
- 关于就业他给了一句被广泛引用的判断:「你不会丢工作给一个 AI,但你会丢工作给一个会用 AI 的人(you may not lose a job to an AI, but you’ll lose one to someone who uses it)。」——把焦虑从「AI 取代人」重新框成「人与人之间的工具代差」。
- 配合同台另一位嘉宾、Google DeepMind 的 Logan Kilpatrick 的判断——「模型吃掉外壳(the model eats the harness)」:随着模型越来越强,外面那套精心搭的工具链/脚手架会被模型本身吸收掉。这跟 GitHub 那条 SIA「自动改进 harness」遥相呼应——业界正在押注「模型能力增长会不断蚕食人工搭的中间层」。
金句:
“你不会丢工作给一个 AI,但你会丢工作给一个会用 AI 的人。” —— 黄仁勋
黄仁勋的「会用 AI 的人淘汰不会用的人」这句,对 DS 这行不是鸡汤而是字面写照——同样的分析任务,会把 LLM 接进工作流的人产出会拉开数量级。而「模型吃掉外壳」那条更值得长期记:今天大家忙着搭的各种 agent 脚手架、prompt 工程、工具链,可能正是下一代模型要内化掉的东西——别在会被吃掉的那层上重仓押技能。
超级幻想王国(Super Fantasy Kingdom)
Source · Rogueliker · 2026-06-12 · link · Hooded Horse 发行 · 抢先体验中
一句话定位:像素风的「自走棋战斗 + roguelite 城建」双层融合(PC / 抢先体验)。
Review 主旨:
这游戏被切成上下两层,而且两层互相喂养、配合得相当优雅。上层是战场——你的部队驻扎在领地边缘,敌人来袭时自动开打(auto-resolve),但你可以在战斗中把单位在几个站位间移动调度;战士、法师、被你捕获的怪物会一直打到最后一个倒下,活下来的当晚就「下班去酒馆」吃顿饭睡一觉,换来经验和回血。下层是你的聚落——藏在战场底下,慢慢扩建,你给工人派活、用法术加速进度(但拉这根杠杆有额外代价),还有个新单位「捕兽人」专门在战场上抓怪、扩充你下一轮的兵池。
机制上它戳中了城建那种「永远资源不够、永远有事可做」的痒处,昼夜循环制造了天然的张力。死亡不是终点——单位次日满血复活(只是丢掉升级的经验),但一旦全员阵亡这一局就结束,带着新解锁和对开局更深的理解重开。作者特别点了一笔:最近一次大更新简化了升级流程,让这一侧变得更易上手、更顺滑——这恰好是它从「系统堆叠」往「精简」方向调的信号。
这个直接打在你两个最甜的点的交叉口上——自走棋(你的主业 TFT 同根:单位自动结算 + 你只管调度和构筑)+ roguelite 城建(你明说「特别喜欢」的 Against the Storm 那一挂:每局重洗、constant thrum 的经营节奏)。两个你已验证会上头的内核被缝进了一个游戏。更关键的是它过你的「精简度」过滤器——作者专门夸了「升级流程被简化、更 approachable」,说明它没往 As We Descend 那种关键词过载的方向滑。唯一要替你留个心眼的是画风(你对像素风不是无脑接受,Cobalt Core 就因画风被你否过),但 review 形容它「表达力强又克制的像素风」,大概率不是劝退那种。它现在还在抢先体验、还在持续加系统,正好适合你「先摸早期、看节奏对不对」。