2026年5月22日星期五
阴 · 2026-05-22(周五)
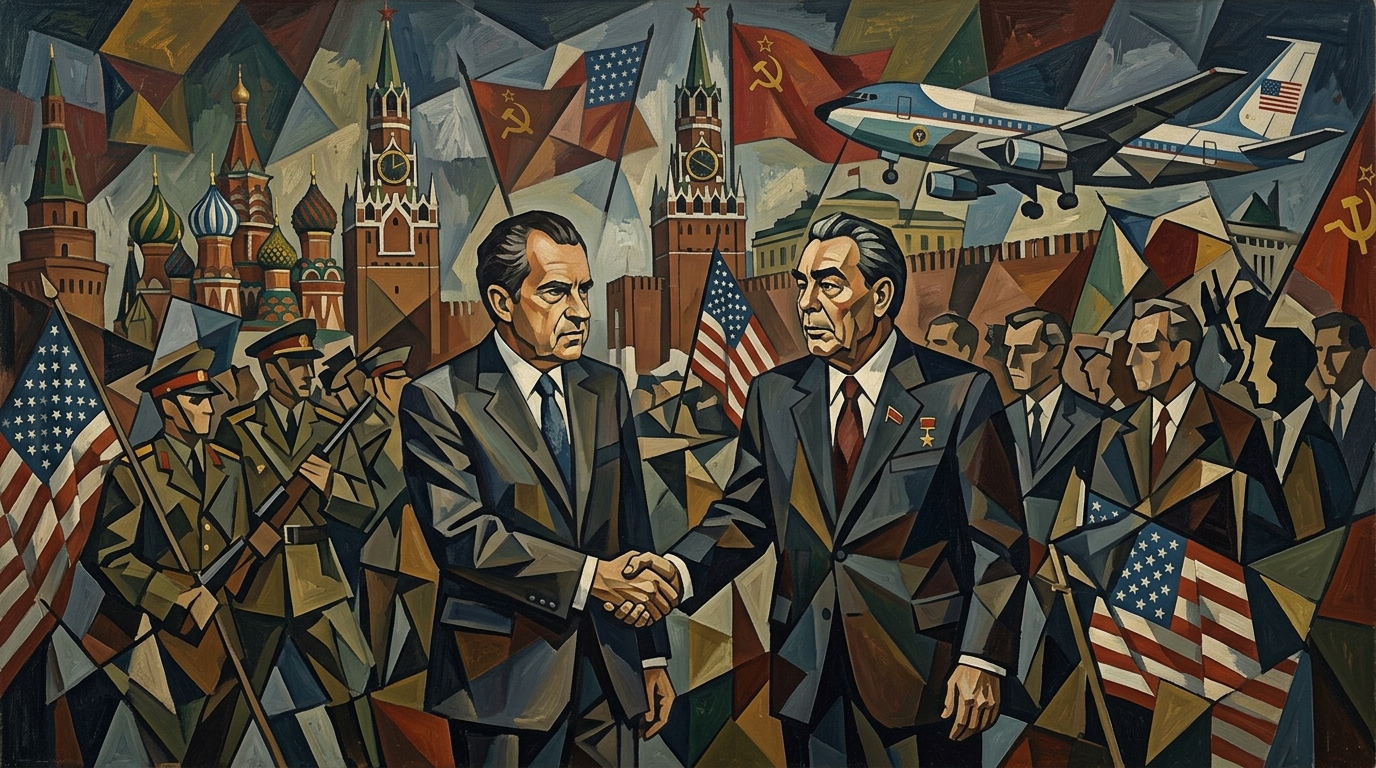
尼克松首次访问苏联(1972)— 立体主义
历史上的今天
1972:理查德·尼克松(Richard Nixon)抵达莫斯科,成为首位访问苏联的在任美国总统 — 这趟为期一周的访问期间,他与苏共总书记勃列日涅夫(Leonid Brezhnev)签下《第一阶段限制战略武器条约》(SALT I),首次给两个超级大国的核武库划了上限。这是冷战「缓和时代」(détente,指 1970 年代美苏从直接对抗转向有限合作的阶段)的标志性一刻,也是「敌对大国元首互访也能产出协议」这条外交逻辑的样板 —— 五十多年后,中美元首北京峰会、王毅即将访美,走的还是同一套剧本。
王毅下周访美加,为习近平访美铺路
Source · 南华早报 · 2026-05-22 · link
Why this — 北京峰会后中美外交进入「落地」阶段,王毅这趟行程是观察习近平访美能不能成的最直接信号。
中国外交部周五宣布,外长王毅下周将访问美国和加拿大。5 月 26 日他将在纽约主持联合国安理会的一场高级别会议,随后 5 月 28 日至 30 日访问加拿大。
这趟行程紧接在不到两周前的习近平-特朗普北京峰会之后。那次峰会上两国谈成了一个三年的「战略稳定」框架,但在伊朗、关税、芯片等具体问题上都没有突破。王毅访美被普遍解读为给习近平回访美国(特朗普已发出邀请,习计划 9 月成行)做前期铺垫 —— 外交上,元首互访前通常要由外长先把议程、措辞、可签的协议谈定,避免元首到场时尴尬。
访问加拿大这一段也值得注意。中加关系前几年因孟晚舟案、「两个迈克尔」案陷入冰点,而本周加拿大刚出了一条大新闻:石油大省阿尔伯塔(Alberta)启动脱离加拿大的公投程序(见下条)。中国此时主动修复对加关系,时机微妙。
阿尔伯塔将就「是否留在加拿大」举行公投
Source · BBC · 2026-05-22 · link
Why this — 一个 G7 国家的能源核心省份要公投独立,这是西方国家内部分裂的一个新样本。
加拿大西部石油大省阿尔伯塔的省长周四宣布,将于明年 10 月举行公投,让选民决定是留在加拿大,还是启动一项具有法律约束力的独立公投程序。
阿尔伯塔是加拿大的能源心脏 —— 全国大部分原油产自这里。当地的分离主义情绪由来已久,核心矛盾是该省认为联邦政府(尤其是自由党执政时期)的环保和能源政策在拿阿尔伯塔的石油经济「献祭」全国的减碳目标。加拿大总理卡尼(Mark Carney)周五回应称阿尔伯塔对加拿大「至关重要」,但省长的公投动作已经把球踢到了选民手里。
这件事的看点不在于阿尔伯塔最终会不会真独立(概率很低),而在于它跟魁北克 1995 年公投、英国脱欧、加泰罗尼亚一样,属于「富裕地区觉得被穷地区和中央政府拖累」这条普遍裂痕的最新一例。能源价格高企的当下,资源省份的这种心态只会更强。
中国取消户口门槛,农民工可在工作地参保
Source · 南华早报 · 2026-05-22 · link
Why this — 户口制度是中国城乡二元结构的地基,松动它影响数亿人,是理解中国「统一大市场」战略的一块关键拼图。
中国国务院周五宣布一项新政:放松居住限制,让农民工可以在实际工作的城市参加社会保险(养老、医疗、失业等),而不再受户口(hukou,中国的户籍登记制度,长期把人的社保、教育、医疗等福利绑定在出生地)所在地的限制。
过去农民工进城打工,社保关系往往留在户籍地,导致很多人干脆不参保 —— 跨省转移手续繁琐、待遇又跟工作地脱节。新政允许工人在工作地直接入保,理论上能大幅提高覆盖率。
官方把这项改革定位为「建设全国统一大市场」的一部分 —— 这个战略的核心逻辑是拆掉阻碍资本和人才自由流动的各种地方壁垒。换句话说,松动户口不只是一项劳工福利政策,更是一步经济结构改革:让劳动力能真正跟着工作走,而不是被一纸户籍按在原地。
美国国家情报总监加巴德辞职
Source · 南华早报 · 2026-05-22 · link
Why this — 美国情报系统的最高负责人在内阁动荡期离任,时点正撞上对伊朗政策的关键窗口。
美国国家情报总监(DNI,统管全美 18 个情报机构的最高职位)图尔西·加巴德(Tulsi Gabbard)周五宣布辞职。她给出的理由是丈夫被诊断出一种罕见的骨癌,她要离职照顾家人,辞职 6 月 30 日生效。
加巴德是又一位在近期离开特朗普内阁的高官。她的离任时点敏感:美国正处在对伊朗动武与谈判之间反复摇摆的阶段(本周特朗普应海湾国家请求推迟了原定的对伊朗打击),而 DNI 正是给总统提供战与和情报判断的核心角色。情报系统在此刻换帅,意味着新人要在最棘手的决策窗口里迅速接手。
给工人分一杯 AI 的羹:纽森的「全民基本资本」提案
Source · 纽约时报 · 2026-05-22 · link
Why this — AI 替代工作的焦虑下,这是一个少见的「不靠发钱、靠发股权」的政策思路,在硅谷引起讨论。
加州州长加文·纽森(Gavin Newsom)抛出了一个正在硅谷被讨论的政策构想:让工人持有一部分技术颠覆的「所有权」。
这个思路被称作「全民基本资本」(universal basic capital)—— 跟更广为人知的「全民基本收入」(UBI,指无条件给每个公民发放一笔生活补贴)形成对照。两者针对的是同一个问题(AI 抢工作、收益高度集中在资本方),但解法不同:UBI 是事后用现金补偿被甩下的人;「基本资本」则是让普通人提前持有一份资产(比如股权),这样当 AI 推动企业利润上涨时,工人是以「股东」身份分到红利,而不是以「领救济者」身份接受施舍。
这个区别不只是措辞。它背后是一个判断:如果未来的财富越来越多来自资本(AI、算法、机器)而非劳动,那么让普通人也持有资本,可能比单纯发钱更能维持一个有尊严的中产社会。提案还很早期、远未成形,但它代表了「AI 时代再分配」讨论里一个值得记住的分支 —— 焦点从「收入」转向「所有权」。
Google 押注 Gemini 3.5 Flash:下一波 AI 是智能体,不是聊天机器人
Source · TechCrunch · 2026-05-19 · link
Why this — Google 明确把战略重心从「会聊天的 AI」转向「会干活的 AI」,这是理解今年大厂竞争主线的一句话。
Google 在 I/O 开发者大会上发布了 Gemini 3.5 Flash,称这是其迄今为止在编程和自主 AI 智能体(agent,指能自己规划、执行多步任务、少量人工干预的 AI 程序)上最强的模型。DeepMind 首席技术官库赖·卡武克曲奥卢(Koray Kavukcuoglu)说,3.5 Flash 在几乎所有基准测试上都超过了 Google 上一代旗舰模型 3.1 Pro,速度比其它前沿模型快 4 倍,而 Google 还做了一个优化版本能快到 12 倍。
速度快是为智能体设计服务的 —— 智能体干活的方式是多个 AI 同时跑长任务。Google 在 I/O 现场演示了多个智能体各自负责一个组件、最后拼起来「从零造出一个操作系统」。Google 说,这种能力已经在合作伙伴里产生实效:银行和金融科技公司在用它自动化原本要花几周的工作流,数据科学团队用它在复杂数据环境里挖洞见。
这次发布的核心信号是 Google 的定位转变:从把 AI 卖成「对话工具」,转向卖成「能自主规划、构建、迭代真实工作」的智能体。3.5 Flash 现在已是 Gemini app 和搜索 AI 模式的默认模型。值得注意的是另一面 —— Google 同时承认这类「能自主跑几小时」的强大智能体放给大众用会带来风险,称已加强了网络安全和生化核(CBRN)方面的防护。
AI 搜索创业公司集体爆发:Exa 融资 2.5 亿美元
Source · TechCrunch · 2026-05-20 · link
Why this — Google 宣布炸掉传统搜索的第二天,一批专攻 AI 搜索的创业公司密集拿到大钱,说明「搜索」这块地盘正在被重新瓜分。
就在 Google 宣布要用 AI 体验取代传统搜索的第二天,彭博社爆出 a16z(Andreessen Horowitz,硅谷顶级风投)投资的 Exa Labs 完成 2.5 亿美元融资,估值 22 亿美元,瞄准的是同一块市场。
Exa 只是这波 AI 搜索创业潮里的一个。同类公司还有 Tavily、TinyFish,以及由前 Twitter CEO 帕拉格·阿格拉瓦尔(Parag Agrawal)创办的 Parallel Web Systems —— 后者刚在红杉资本(Sequoia)领投下融到 1 亿美元、估值 20 亿。与此同时,亚马逊、LinkedIn、Reddit 这些传统平台也都在用 AI 改造自己的搜索功能,这意味着如果这些创业公司想卖身,不缺买家。
为什么这块地盘突然这么热?文章给出的逻辑值得记住:最大的竞争者是 ChatGPT,它目前掌握着「界面层」(用户每天大量的 AI 搜索都发生在 ChatGPT 里)。但 OpenAI 没法把搜索当成头等优先级,Google 则要保护自己的广告业务不被自己颠覆 —— 这两个巨头各自的「软肋」,恰恰给 Exa、Parallel 这样的小实验室留出了切一块利基市场的空间。
Stability AI 推出能生成 6 分钟完整歌曲的音频模型
Source · TechCrunch · 2026-05-20 · link
Why this — AI 音乐生成正从「片段」走向「完整作品」,而这家公司选择了一条跟竞品不同的合规路线。
做出 Stable Diffusion(开源图像生成模型的代表作)的 Stability AI 发布了新一代音频模型家族 Stable Audio 3.0,旗舰版能生成 6 分 20 秒的「专业级」音乐,并保持音乐结构和旋律连贯 —— 这是 2024 年上一代 Stable Audio 2.0 时长的两倍多。
这次共发四个模型:两个小模型(4.59 亿参数)适合在设备本地生成最长 2 分钟的音效和音乐,中型(14 亿参数)和大型(27 亿参数)能生成 6 分钟级的完整作品。其中小型和中型模型开放权重(任何人可下载、修改),大型只通过 API 和付费托管提供,年收入超百万美元的公司还需买企业授权。
真正的看点在合规路线。AI 音乐这个赛道,Suno 和 Udio 两家都深陷版权官司 —— 用没授权的音乐训练模型是核心争议。Stability AI 选了另一条路:去年已跟华纳音乐、环球音乐签约,称这套新音频模型完全建立在「已获授权的数据」上。在生成式 AI 普遍因训练数据合法性挨告的当下,「数据来源干净」正在从道德加分项变成长期生存的必要条件。
D³-Subsidy:大规模网约车市场的在线司机补贴决策
作者 · Taijie Chen / Siyuan Feng / Jintao Ke / Li Ma 等(香港大学 + 滴滴出行团队)· arXiv:2605.20036 · link
网约车平台(论文以滴滴为例)每天都在解一个动态平衡问题:司机供给和乘客需求不匹配时,「给司机发补贴」是最主要的调节杠杆 —— 补贴能把司机吸引到需求旺的时段和区域,从而拉高完成订单数和成交额(GMV)。难点在于,要在真实生产环境里优化补贴,得同时满足三个约束:(1) 对突发波动(比如下雨、演唱会散场)能快速响应;(2) 严格不超过补贴率上限(预算红线);(3) 在整个城市规模上还得低延迟执行。这三条加起来,就排除了「给每一单单独算最优补贴」这种昂贵做法,必须有一个「前瞻性、带约束、城市级」的控制器。
论文提出的 D³-Subsidy 是一个分层的扩散模型框架(扩散模型,一种通过「逐步去噪」来生成数据的 AI 模型,最初用于图像生成)。它的核心做法是:用一个「前缀条件扩散模型」从不可改变的历史观测里采样出多条可能的未来轨迹 —— 这一步专门解决「训练-推理不一致」的老问题,因为在线部署时历史是固定的,训练协议也得对齐这个特性。生成的方案再被解码成城市级的低维控制信号;最后通过一个由拉格朗日对偶推导出的映射,把「城市级规划」翻译成「具体到每个订单-司机的激励」,并把补贴率上限直接嵌进激励里,不需要反复迭代优化。论文还用多城市预训练 + 参数高效微调,让模型能在不同城市间迁移。
线下评估显示 D³-Subsidy 在提升订单数和 GMV 的同时改善了预算合规;一次真实世界的 A/B 测试也确认了显著的提升,且预算违规指标保持在运营阈值内。
这篇对做实验和因果的 DS 来说有两个直接可借的点。一是它把「训练-推理 gap」当成一等公民来设计 —— 在线决策系统里,训练时你能看到的「未来」和上线后能看到的不一样,这个错配会让线下指标好看、线上翻车,论文用「前缀条件」强制对齐是个干净的思路。二是它把硬约束(补贴率上限)直接嵌进优化目标,而不是事后裁剪 —— 任何要在「预算红线 + 实时响应 + 规模」三角里做决策的场景(不只是补贴,也包括广告出价、push 频控)都会撞上同样的问题。
Superlog
一个会「自己装、自己修 bug」的可观测性(observability,指监控软件运行状态、日志、错误的工具)平台,来自 Y Combinator 2026 冬季批次。它的卖点是把「接入监控」和「定位修复」这两步自动化 —— 传统的日志监控工具只告诉你「出错了」,Superlog 想做的是直接帮你查到根因甚至给出修复。适合中小团队、独立开发者、不想为搭一套监控基建专门配人的 startup。
对你这种一个人 + Claude Code 跑副业(SPP、alpha 日报、侧目这套)的模式,「监控自己装、bug 自己修」这个定位是对症的 —— 你的瓶颈从来不是写代码,是没精力给每个小项目配运维。可以观望它实际接入门槛有多低,太重就还是不值得。
r/MachineLearning · 基准测试分数高,几乎说明不了一个工作流能不能扛住生产环境
原 post · 19 赞 · 8 评论
发帖人提出一个让他困扰的观察:内部基准测试(benchmark,指用固定数据集给模型打分、方便横向比较的标准化测试)分数漂亮的系统,一上生产环境就立刻崩 —— 崩在四类情况上:用户意图模糊、真实世界上下文混乱、指令自相矛盾、长会话。他的判断是,现在的评估方式仍然在奖励「干净任务上的优化」,而不是「行为上的鲁棒性」。
评论区反应:
- 最高赞认为这是 ML 研究 vs 生产的老问题,没法绕开 —— 你需要固定基准来公平对比不同方法,不然根本没法比。但解法是在生产里监控数据漂移、用真实数据建自己的数据集。
- 一条很扎实的回复指出,「指令自相矛盾」才是生产里真正要命的失效模式:他们有个模型内部评估 94 分,上线第一个月在真实文档上掉到 79 分,因为真实分布里有一整类他们没采样到的边缘情况。「修复方案不是换更好的模型,是用真实的生产失败案例建一个留出测试集,再拿它给评估重新加权。」
- 另一条提到,他们在生产里关注的是「失败恢复」和「工具调用循环」是否正常,而不是干净任务跑分 —— 具体做法是往上下文窗口里注入噪声,测智能体是恢复了还是开始幻觉。
这条戳中的是「benchmark 只在回顾时有效」—— 任何一个 benchmark 一旦变成被优化的目标,立刻就失去意义,因为它永远不可能 100% 匹配真实意图分布。对做实验的 DS 是个熟悉的命题:线下指标好 ≠ 线上有效,那条「用生产失败案例建留出集、重新加权评估」的回复其实就是把这个教训工程化了。
r/slatestarcodex · 「新范式救不了你」
原 post · 21 赞 · 18 评论
这是一个指向 Astral Codex Ten(Scott Alexander 的博客,理性主义圈的核心阵地)文章的讨论帖。原文的核心论点是:很多人预测 AI 进展时,会用「现在的范式(指 Transformer + 大模型这套路线)很快会撞墙,然后某个新范式出现把一切改写」来给自己的判断兜底 —— 文章认为这种「等新范式」的思路在预测上其实站不住脚。
评论区反应:
- 有评论质疑原文用「林迪效应」(Lindy’s Law,指一个东西已经存在的时间越久,预期它还能继续存在的时间也越长)来论证当前范式会延续 —— 认为在只有单个随机数据点的情况下,林迪效应不是一个强模型。
- 另一条挑原文的一个事实:文章说「从 Transformer 发明到 ChatGPT 隔了五年」,但其实 Transformer 一出来就是机器翻译等大量 NLP 任务的最强方法了,ChatGPT 只是第一个商业成功的「聊天界面」,不是第一个 Transformer 应用。
- 还有人说看到标题以为讲的是 AI 对齐的伦理范式,并借机表达了对「负责对齐 AI 的那群人本身的伦理观」的担忧。
「等一个新范式来救场」是预测里一种很隐蔽的逃避 —— 它让你既不用承认现有趋势会延续,也不用为「撞墙之后会怎样」给出具体说法。这个 framing 不只适用于 AI:任何一个你不想正面下注的领域,「会有颠覆性变化」都是最舒服的话术。值得收进判断工具箱当一个反面信号。
r/dataisbeautiful · 燃油车的全球销量在 2017 年已经见顶
原 post · 382 赞 · 51 评论
一张基于国际能源署(IEA)数据的图表显示:全球燃油车(汽油 + 柴油)销量在 2017 年已经见顶,此后一直在下滑。发帖人指出这个拐点彭博新能源财经也估算在同一时间。与此同时电动车销量增长很快 —— 2022 到 2025 三年间翻了一倍多。
评论区反应:
- 最高赞(65 赞)的观察跟数据本身关系不大但很扎眼:美国只占世界人口的 4.1%,却买走了全球约 20% 的汽车。
- 有评论补充,2016-2022 这段电动车增长里中国是绝对主力 —— 比如 2021 年全球一半的电动车卖在中国。
- 一条回复对「燃油车见顶」表示意外:「可我每天都在听说电动车销量正在崩盘啊。」—— 点出了媒体叙事和长期数据之间的落差。
「燃油车 2017 见顶」是那种一旦知道就很难忘的拐点事实 —— 但评论区那条「我每天都在听说电动车在崩」更值得记:短期销量波动的新闻噪声,和「燃油车长期已见顶」这个结构性事实,是两个层面的东西,混在一起读就会误判趋势。看数据时把「这个月的波动」和「十年的方向」分开,是个通用纪律。
Understand-Anything · [Python / TypeScript]
github.com/Lum1104/Understand-Anything
这是干什么的:一个 Claude Code 插件,能把任意一个代码库(或知识库、文档)转成「可交互的知识图谱」—— 你可以平移、缩放、搜索这张图,还能直接对它提问。它要解决的痛点是:你刚加入一个新团队,面对一个 20 万行的代码库,根本不知道从哪看起。
技术解读:
- 它的做法是用一套「多智能体流水线」(multi-agent pipeline,指多个 AI 协作分工分析的工作流)扫描整个项目,给每一个文件、函数、类、依赖关系建一张图,再生成一个可视化仪表盘让你直观地探索。
- 跟你现有工具的关系:你平时用 Obsidian 把笔记连成网络(wikilink、graph view),这个项目本质是把同样的「图谱化」思路套到代码上 —— 不是给代码本身做什么,而是给「理解代码」这件事做一张地图。它强调的设计目标是「不要一张炫耀代码有多复杂的图,要一张安静地教你每块怎么拼起来的图」。
你不读 code,但你手上有 SPP、alpha 日报、侧目这几个 Claude Code 跑出来的项目,每个都在长大。当某个项目你想知道「它现在到底是怎么运转的」时,这种「整个项目自动生成一张可探索的结构图」比让 AI 一段段念代码更适合你 —— 你要的是 behavior 的全景,不是实现细节。可以拿侧目这个 repo 试一次,看图谱能不能让你一眼看懂阳面阴面两条流水线怎么咬合。
No Priors · 卡住 IPO 的硬币另一面:Cerebras CEO 讲 630 亿美元上市背后的故事
主持 Sarah Guo + Elad Gil · 嘉宾 Andrew Feldman(Cerebras 联合创始人兼 CEO;Cerebras 是做「晶圆级」AI 芯片的公司,刚完成 AI 行业 2026 年第一个大型 IPO)· 2026-05-21 · YouTube
本期是 Cerebras IPO 后创始人 Andrew Feldman 的复盘访谈,主题是一家「非主流路线」的 AI 芯片公司怎么熬到上市。
这期讲了什么:
- Cerebras 的核心赌注是「晶圆级引擎」(wafer-scale engine)—— 别的芯片公司把一块大晶圆切成几百颗小芯片,Cerebras 反其道而行,把整块晶圆做成一颗巨型芯片。Feldman 解释这么做的逻辑:AI 计算的瓶颈很多时候不在算力本身,而在芯片之间搬数据的延迟和带宽;做成一整块,数据就不用在几百颗芯片之间来回跑。这是一个跟英伟达(Nvidia)GPU 集群完全不同的物理路线。
- 关于「为什么现在能 IPO」:Feldman 的判断是 AI 推理(inference,指模型训练完成后实际对外提供服务、回答用户问题的阶段)市场正在从「训练为主」转向「推理为主」,而推理对延迟极其敏感 —— 这恰好是 Cerebras 整块晶圆架构的强项。他把公司多年「不被主流看好」的处境,归因于市场长期只盯着训练、只盯着英伟达。
- Feldman 反复强调的一点是「单一供应商风险」:整个 AI 行业的算力高度依赖英伟达一家,无论是云厂商还是 AI 实验室都在主动寻找第二、第三选择 —— 这是 Cerebras 这类「异类芯片」公司能拿到订单、能上市的根本原因。客户不是因为 Cerebras 一定更好,而是因为他们需要不把鸡蛋放在一个篮子里。
- 关于上市本身:Feldman 把 IPO 描述成一个「漫长且数次几乎走不下去」的过程 —— 芯片创业的资本消耗极大,公司多次在「钱快烧完」的边缘。能走到 630 亿美元估值上市,他认为时机(AI 推理需求爆发)和坚持各占一半。
金句:
「客户不是因为我们一定更好才来找我们 —— 是因为他们再也受不了只有一个选择。」 — Andrew Feldman(大意)
这期最值得记的不是 Cerebras 这家公司,而是 Feldman 反复讲的那条产业判断:AI 算力的下一阶段重心从「训练」转向「推理」,而推理对延迟的敏感性会重新洗牌芯片格局。对关注 AI infra 的人来说,这是一个比「英伟达又涨了」更有解释力的框架 —— 它告诉你为什么一批「非英伟达路线」的芯片公司突然集体有了机会。
零次阅兵:献给死间谍(Zero Parades: For Dead Spies)
Source · Eurogamer · 2026-05-18 · link · 评分 5/5
文字驱动、骰子驱动的角色扮演游戏 · PC · 《极乐迪斯科》原班团队 ZA/UM 的第二部作品。
Review 主旨:
Eurogamer 给了满分,开篇就定调:这是「我们不配拥有」的 RPG。它出自做《极乐迪斯科》(Disco Elysium,一款以海量文本和内心独白著称、被广泛认为重新定义了 RPG 的游戏)的工作室 ZA/UM 的新班底。
游戏的特色机制是评测花最多笔墨去讲的部分。你扮演一个失势的老间谍 Cascade,被「冰封」五年后重新派回前殖民地城市 Portofiro 执行任务。整套系统建立在三个咬合的机制上:
第一是骰子检定。对话里遇到技能检定时,你掷骰子决定成败 —— 你可以「使劲」往骰池里多加一颗骰子,赌掷出两个好数字。白色检定失败后过段时间或升级技能可以重试;红色检定是「危险区」,只有一次机会,掷不好机会就永远没了。
第二是内部状态三角:疲劳(Fatigue)、焦虑(Anxiety)、谵妄(Delirium)。掷骰失败会推高这些值,你靠罐装咖啡、啤酒、香烟来调节;每个值都有软上限和硬上限,一旦顶到硬上限,你必须降低一项相关技能作为惩罚。
第三、也是评测认为最妙的,是**「conditioning / 思想」系统**。探索世界会解锁「思想」,你最多可以同时「执念」于九个思想,每个都带独特的增益 —— 但也带「违反它的原则」时的对应惩罚。评测举的例子:你看到一个性感的咖啡广告会染上「最新的合成欲望」这个思想,它会提高你某项属性的上限、喝罐装咖啡时减疲劳;但如果你买了盗版货,这个思想就被压制锁定 12 小时。
评测反复强调的是机制和主题的咬合:游戏的核心主题是「塑料、盗版、后殖民消费主义」—— 帝国 La Luz 的审美像 K-pop 一样席卷世界,欲望被「从发达世界的心脏泵出来」。而 conditioning 系统让玩家不断被迫审视自己的文化认同和欲望从何而来。评测说,掷骰拿 Cascade 的精神状态去赌,「上瘾得就像新版抽卡」—— 即便她已经是个摇摇欲坠的废人,骰子仍然给你一丝「翻盘」的承诺。
《极乐迪斯科》在你的口味模型里是「难分类的 creative oddity」那一类的正例 —— 这部是同一批人做的续作,机制还更精巧。它跟你沉迷的 StS 内核其实相通:每一次掷骰检定都是一道独立的战术谜题,conditioning 系统则像把卡组构筑搬进了「你这个人是谁」的层面 —— 你选的九个思想就是你的「卡组」,每个都是增益和限制的权衡。区别在于它是叙事驱动而非战斗驱动,深度全在文本和选择里。Eurogamer 满分 + ZA/UM 血统,是那种「读完就想知道自己会被掷出什么命运」的游戏。