2026年5月17日星期日
阴 · 2026-05-17(周六)
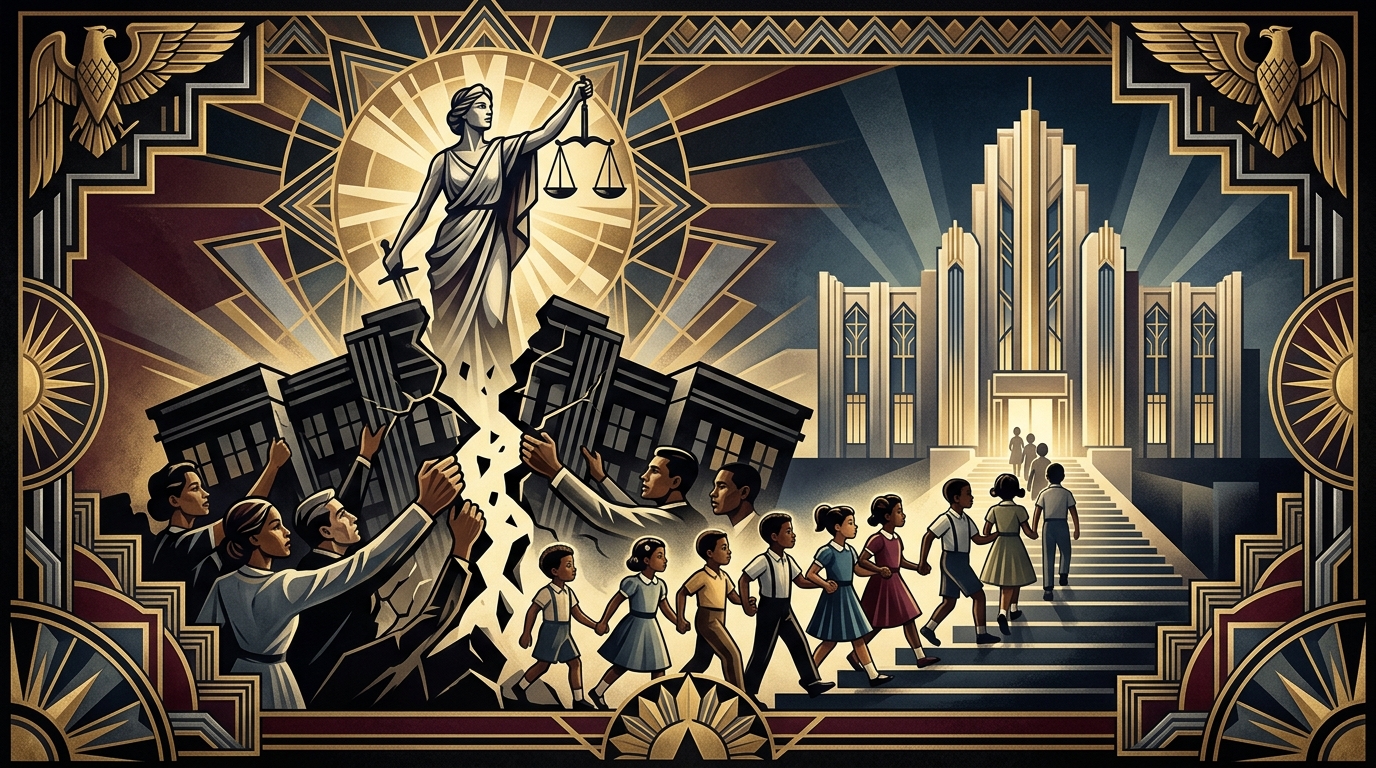
1954 年布朗诉教育委员会案 — Art Deco
历史上的今天
1954:美国最高法院在”布朗诉托皮卡教育委员会案”中以 9-0 全票裁定公立学校种族隔离违宪 — 推翻了 1896 年”普莱西诉弗格森案”确立的”隔离但平等”原则,成为美国民权运动法律层面的引爆点,也是后来七十年美国宪法政治围绕”种族 + 14 修正案 + 联邦司法权”展开的起点。
WHO 宣布刚果(金)-乌干达埃博拉疫情为”国际公共卫生紧急事件”
Source · WHO / NPR / Al Jazeera · 2026-05-17 · link
Why this — PHEIC(国际关注的突发公共卫生事件,WHO 最高级别预警)今年第一例,且总干事谭德塞绕过专家委员会直接宣布,是机制层面的破例。
刚果(金)伊图里省(Ituri)三个卫生区(Bunia、Rwampara、Mongbwalu)已累计 8 例实验室确诊 + 246 例疑似 + 80 例疑似死亡。更让 WHO 紧急按按钮的是邻国乌干达:首都坎帕拉在 5 月 15-16 日 24 小时内出现 2 例确诊(含 1 死),两位患者互相之间无接触,但都最近从刚果(金)入境 — 等于”病毒已经会自己买机票了”的实锤。
毒株是 Bundibugyo 型,相对罕见,2007 年在乌干达西部首次被识别 — 目前无获批疫苗、无特效抗病毒药。这是 PHEIC 级别响应的关键:常见的扎伊尔型有 Ervebo 疫苗可用,Bundibugyo 型没有,意味着公共卫生武器库被掀掉一半。
谭德塞这次破例没召集 emergency committee 直接宣布 PHEIC — 是 WHO 自 2005 年《国际卫生条例》修订以来首次。WHO 的解释是”跨境传播证据已经够清楚,等委员会会议会浪费 48 小时”,但程序内部肯定有争议。
乌克兰对莫斯科发动开战以来最大规模无人机袭击
Source · Washington Post / NPR / NBC News · 2026-05-17 · link
Why this — 自 2022 年 2 月战争爆发以来莫斯科被袭击规模最大的一夜,俄罗斯防空一夜击落 81 架奔向莫斯科的无人机,仍有相当数量穿透。
乌克兰一夜出动数百架远程无人机攻击俄罗斯腹地,至少 4 死 12 伤:
- 莫斯科西北郊希姆基(Khimki)一名女子在自家被无人机击中身亡
- 莫斯科以北 10 公里的波戈雷尔基村(Pogorelki)两名男子死亡
- 与乌克兰接壤的别尔哥罗德州(Belgorod)一名男子死于无人机击中卡车
- 印度驻莫斯科使馆证实 1 名印度劳工死亡 + 3 人住院 — 这是战争首次出现亚洲第三国公民在莫斯科死于乌克兰无人机
主要袭击点在莫斯科主炼油厂入口区域,多座高层住宅楼受损,谢列梅捷沃机场(Sheremetyevo)跑道发现无人机残骸暂时关闭。俄方称防空击落 81 架奔向莫斯科的无人机 — 即便按这个数字推算,发动总规模至少在数百架级别,远超过去任何一晚。
泽连斯基定性为对俄罗斯袭击乌克兰城市的”正当报复”。结构性看点:这一波规模 + 一名印度公民死亡(首次第三国人在莫斯科被乌克兰武器命中)会迫使俄方重新评估首都防空,俄罗斯对印度的外交解释也会很难处理 — 印度刚跟俄罗斯签了大宗能源合约。
卡西迪在路易斯安那共和党参议员初选出局 — 投票定特朗普有罪的代价兑现
Source · NPR / CNN / Axios · 2026-05-17 · link
Why this — 2021 年第二次弹劾时,7 个共和党参议员投票认定特朗普有罪,卡西迪是其中之一。五年后,账算清了。
现任两届路易斯安那参议员 比尔·卡西迪(Bill Cassidy)以约 25% 得票率排第三出局,无缘 6 月 27 日的二轮决选。晋级的两位:
- 朱莉娅·莱特洛(Julia Letlow) — 现任众议员,特朗普 endorsed,得票约 45%(差 5 个百分点没能直接锁定 50%+1 一轮拿下)
- 约翰·弗莱明(John Fleming) — 路易斯安那州财政部长,得票约 28%
卡西迪不是政策上有问题 — 他在共和党内一直算中右技术派,肯塔基医改谈判桌上一直是关键角色 — 他出局的唯一理由就是 2021 年那一票。特朗普花了五年时间在路易斯安那地面铺人脉,把莱特洛抬上来当 vehicle。
这是 2021 年那 7 个投票定罪的共和党参议员里 第 5 个被赶下台或主动退出:穆考斯基(Murkowski)、罗姆尼(Romney)、托米(Toomey)、伯尔(Burr)已离开,柯林斯(Collins)2026 中期也悬。共和党党内”反特朗普 = 政治死刑”基本已是钢板规则,制度上的意义是 — 共和党参议院 caucus 已经没有任何敢公开违抗特朗普的人。
中国加速建”全国一体化算力网”,要把 AI 算力当公共事业卖
Source · SCMP · 2026-05-17 · link
Why this — 这是”算力 = 电力”框架第一次被中国官媒正式提出,对应国务院今年 **7 万亿人民币(约 1 万亿美元)**投向六大基础设施网的一部分。
国务院把”全国算力网”列入今年六大新基建项目,跟电网、水网、物流网平级。官媒明确把它比喻为 “算力版的国家电网” — 把 AI 算力从”各家私有的稀缺资产”重新定位为”国家公共事业”。
支撑这个定位的数据很扎实:中国 3 月份单日 token 调用量超过 140 万亿次,是 2024 年初的 1000 倍以上。token(token 是大语言模型处理的最小语义单位,可以粗略理解成一个汉字或半个英文词)现在被官媒包装成”AI 时代的数据流量包”,意思是 — 跟当年 4G 让流量从奢侈品变成日用品一样,算力也要走这条路。
这背后的政治经济算盘:中国 AI 应用层在过去 12 个月猛增,但底层算力成本居高(GPU 进口受限 + 国产芯片产能爬坡),开发者和企业普遍叫贵。国家直接出钱把算力供给端打成”基础设施”,等于绕开市场定价,强制把单位算力价格压下去 — 路径跟 2010 年代国家主导 4G/5G 网络建设、把移动数据资费打下来是一个模板。
跟美国对照:美国走的是 OpenAI / Anthropic / xAI 跟超大规模云厂商私下绑定的”compute alliance”路线(这周 Salesforce 的 Benioff 说一年要花 3 亿美元买 Anthropic token,就是这路线的样板);中国走的是国家集中调度+定价。两套模式在未来 3-5 年的成本曲线会很值得对比。
CIA 局长突访古巴,警告勿用 300 架攻击无人机袭击关塔那摩
Source · Axios · 2026-05-17 · link
Why this — 美古关系自 1962 年导弹危机以来第一次出现”对方在岛上部署攻击性武器、华盛顿直接警告”的剧本。
机密情报显示:古巴自 2023 年起从 俄罗斯和伊朗 进口超过 300 架攻击无人机,性能从中等到高端不等,分散藏在岛上多处战略位置。古巴军方最近内部讨论的目标包括 关塔那摩湾美军基地、加勒比海美军舰艇,甚至佛罗里达基韦斯特(Key West,距哈瓦那 90 英里)。
CIA 局长拉特克里夫(John Ratcliffe)周四(5 月 14 日)秘密访古,当面警告古巴当局不要采取敌对行动 — 这是该报告提交两天后。同时司法部正在准备解封一份针对 劳尔·卡斯特罗(Raúl Castro,菲德尔·卡斯特罗弟弟、古巴前最高领导人) 的诉讼。
更让美方紧张的两个信号:
- 哈瓦那有 伊朗军事顾问 驻扎 — 等于一个对美国敌意明确的地区性大国,把军事教官派到 90 海里外
- 美方估计 多达 5000 名古巴士兵 已为俄军在乌克兰作战 — 把无人机战的实战经验带回岛上传授给本国军方
这件事比表面更值得看的点:特朗普政府对古巴的威胁感不是来自意识形态(这届班子对古共政权没兴趣 framing 成意识形态战),而是来自 无人机彻底改变了 90 英里距离的军事意义 — 乌克兰战场过去三年证明,廉价无人机集群可以让传统海空防御失效。古巴突然变成”伊朗 + 俄罗斯 + 实战经验”的复合代理人,地理位置上又紧贴美国本土。
arXiv 出手了:用 LLM 写但不检查的论文作者,封一年
Source · TechCrunch · 2026-05-16 · link
Why this — 全球最重要的预印本平台(preprint,指未经同行评审的研究论文,机器学习领域 99% 的新工作首发在这里)开始用”实名封禁”对抗 AI 水文。
新规:“一击禁言”模式:发现 不可辩驳的证据证明作者未核对 LLM 生成内容 → 封 1 年。封禁期满后,作者必须先有同行评审期刊 / 会议接收的论文记录,才能恢复 arXiv 发文权。
触发封禁的红旗:幻觉引用(hallucinated references — 即 LLM 编造的不存在的参考文献)、论文里残留的 LLM comment(比如”As an AI language model, I cannot…”)、抄袭、捏造的引用、原样照搬未经核对的 LLM 输出。
arXiv 计算机科学版主席 Thomas Dietterich 划清边界:不是禁用 LLM,是”作者必须为内容负全责,无论生成方式”。仔细使用 + 自己核对完全可以。
机制是三道闸:moderator(审稿人)标记 → 版块主席确认证据 → 作者可申诉。
背景:arXiv 转为独立非营利组织后开始系统性收紧门槛 — 之前已经要求新作者必须有资深研究者背书。这次规则升级是因为 arXiv 月投稿量从 2023 年的 1.7 万跳到 2025 年的 2.4 万,质量管控成本指数级上升。配合前阵子提议的 1 年禁言机制(更早一波),arXiv 在系统性给”用 LLM 灌水”的人画红线。
Ben Thompson:算力新框架 — Answer Inference vs Agentic Inference,英伟达护城河出现裂缝
Source · Stratechery · 2026-05-15 · link
Why this — Ben Thompson 提了个新框架解释”为什么 AI 算力的下一阶段,英伟达不一定继续垄断” — 框架本身比结论更值得记。
核心框架:两种 inference(推理,指模型部署后处理实际请求的阶段,区别于训练阶段)
| 类型 | Answer Inference | Agentic Inference |
|---|---|---|
| 谁在用 | 人,等回答 | Agent 互相调用,没人等 |
| 关键约束 | 延迟(人能感知的等待时间) | 吞吐 + 成本(延迟无所谓,要的是单位算力多便宜) |
| 硬件需求 | 高带宽、低延迟 → 英伟达 H 系列、B 系列绝对优势 | 不需要低延迟,可以接受慢但便宜的方案 |
英伟达护城河的脆弱点:英伟达的统治建立在”训练 + answer inference”这两个场景对低延迟和高带宽的极致需求上。如果 agentic inference 在未来 2-3 年成为算力消耗的主体(agent 帮人后台跑任务,没人在屏幕前等),那对”延迟”的要求骤降,竞争者(中国国产芯片受出口管制可以另辟蹊径、太空数据中心可以牺牲延迟换能效)就有空间钻进来。
美中互动的三层判断:
- “谁占上风”分析被过度解读 — 双方真正受到的结构性激励是趋同的
- 双方都有动力 拖时间换稳定,而不是升级冲突
- 中国的姿态比 1990s-2000s 已经根本性变了 — 更强硬,但也更小心
特朗普访京峰会 deliverables(具体成果)寒酸,正好印证 Thompson 的判断:当下是 “管控的竞争”(managed competition),不是冲突也不是和解。
对 Eric 工作的关联:如果你在做 LLM eval 或 agent 编排,这个框架值得记 — “你的应用属于 answer 还是 agentic”决定了你选哪个 inference 后端、对 token 价格的敏感度、未来 18 个月 vendor 谈判位置。
Nathan Lambert 5 月开源模型盘点:DeepSeek V4、Kimi K2.6、Gemma 4、MiMo V2.5、Laguna 全部 Apache 2.0
Source · Interconnects · 2026-05-16 · link
Why this — 5 月是开源大模型 release 密度峰值的一个月,Apache 2.0(最宽松的商用许可证之一)成为主流许可证 — 这是过去 12 个月 ecosystem 最大的结构变化。
5 月关键 release:
- MiMo-V2.5-Pro(小米)— 跟 Kimi K2.6 / GLM-5.1 实力接近,Apache 2.0 许可
- Gemma-4(谷歌)— 4B / 9B / 31B dense 三档 + 26B-A4B MoE(mixture of experts,专家混合架构)一档,首次全线 Apache 2.0
- Kimi-K2.6(月之暗面)— 长上下文(long context,模型一次能处理的输入文本长度)推理能力大幅升级
- Laguna-XS.2(Poolside)— 33B-A3B 编程专用模型
- DeepSeek-V4(深度求索)— 双版本:Pro(1.6 万亿参数 MoE)+ Flash(284B 总参数 13B 激活),Flash 相对表现更强
关键判断(双方观点都列):
- CAISI(美国 AI 标准化倡议)的评测说:开源跟美国前沿闭源模型差距在拉大
- Epoch AI 的 ECI 指标(Epoch Capability Index,他们家的能力对比方法)说:差距稳定在 3-7 个月
Nathan 自己的判断偏 Epoch — 标准化 benchmark 严重低估了实际能力,特别是编程任务,因为 benchmark 不能复现真实开发环境的 harness(脚手架代码 + 工具链)。
对 Eric 工作的关联:如果你在评估”要不要用开源模型替换 API 调用”,今天的真实差距大概 3-7 个月而不是”代差”。Apache 2.0 让企业法务路径变干净了 — 这是过去 12 个月对 DS / ML 工程师选型最大的减负。
因果基础模型遇上连续 treatment:第一次有人用 transformer 学”剂量响应曲线”
Causal Foundation Models with Continuous Treatments
作者 · Christopher Stith / Medha Barath / Vahid Balazadeh / Jesse C. Cresswell / Rahul G. Krishnan(多伦多大学 + Layer 6 AI)· arXiv:2605.15133 · link
Motivation:因果推理(causal inference,从观测数据中估计干预效应的统计方法)里”连续 treatment”场景一直是硬骨头。Binary treatment(吃 vs 不吃药,看 vs 不看广告)有大量成熟工具;continuous treatment(吃 50mg vs 100mg vs 200mg,广告预算 1 万 vs 10 万 vs 100 万)的工作要少一个数量级 — 但现实业务里恰恰是连续的居多(剂量、价格、预算)。
Method:作者训了一个 transformer 类基础模型,目标是 meta-learn(元学习,学会”如何学习”)— 在大量合成数据上预训练,让它具备对任何新任务”看几个观测数据点就能拟出 individual treatment-response curve”的能力。三步:
- 先设计 prior(先验,即数据生成假设)— 一个能产生丰富因果场景的连续 treatment 数据生成过程
- 用这个 prior 合成大量训练任务
- 训 transformer 用 in-context learning(上下文学习 — GPT-3 那一套,不更新权重,给 example 就直接推理新任务)把贝叶斯后验推理(Bayesian posterior inference,传统因果方法的金标准但计算昂贵)“摊销”掉
主要结果:在 individual treatment-response curve 重建任务上 SOTA(state-of-the-art,业内最佳),且无需对新任务做任何 fine-tune 或额外训练 — 这是基础模型范式的核心卖点。
如果你在做药物剂量响应、广告 budget 优化、定价弹性这类连续 treatment 估计,这篇是第一个能”零样本”出答案的基础模型 — 之前每个新业务问题都要单独跑 BART / causal forest 之类。可以用 OOD(out-of-distribution,分布外)评测先看你自己的数据集 transferable 程度,再决定是 inference-only 用还是 fine-tune。Meta 的 experimentation infra 也许会借鉴这个范式做”通用 CATE 估计器”。
WhichLLM — 输入你的硬件,告诉你跑什么本地 LLM 最划算
https://github.com/Andyyyy64/whichllm
一个开源工具:你输入显卡 / 内存 / CPU 配置,它根据多套 benchmark(MMLU / HumanEval / LMSys arena 等)排出适配你硬件的 best local LLM 列表。Show HN 283 分,是本周 Show HN 最高分项目之一。
针对人群:本地跑 LLM 的开发者 / 隐私敏感企业 / 想在自己 MacBook 上跑 coding agent 的工程师。
你不跑本地 LLM 暂时用不上 — 但如果你在 Meta 内部讨论”为什么不用开源模型替代 API call 省成本”,这种工具可以一句话证明可行性:给个硬件 spec,工具直接出”在这个 spec 上 Qwen 3.6-27B Q4 跑得动且效果接近 GPT-4o-mini”的结论。
r/MachineLearning · 一个项目把高中生骗去交钱发”NeurIPS 论文” — 学术诚信塌方实况
原 post link · 170 赞 · 18 条评论
发帖人在 OpenReview(机器学习论文评审平台)上偶遇一个叫 Kevin Zhu 的账户 — 158 篇论文 + 468 个共同作者。一查 affiliation,是个叫 Algoverse 的付费项目,主打”带高中生发 NeurIPS 论文”(自称 2025 年帮 289 名学生论文被 NeurIPS workshop 接收)。
发帖人随机翻了四篇 paper — 每一篇都有打开 PDF 读一遍就能发现的低级错误(比如 711 个 broken prompt、未公开的自引用、benchmark 设计漏洞)。问题在于:这些怎么过的同行评审?
Top comments 反应:
- u/akardashian(54 赞):“南湾我读高中时大家就这样了 — 父母花钱送孩子进暑期研究项目,挂个共一然后投 Siemens / Intel STS / Davidson 这种科学奖。这一代只是把场地搬到了 NeurIPS workshop”
- u/LaVieEstBizarre(28 赞):贴了 Guardian 2025 年的报道 — 这家 113 篇里有 89 篇被 NeurIPS workshop 接收。讽刺的是 “这恰恰说明现在 ML 研究的 rigor 多差”
- u/MLPhDStudent(7 赞):“最荒唐的是这哥们 Kevin Zhu 没有 PhD 也没有 master,开这种项目之前的科研经历都不够格。会议应该开始拉黑这种人”
- u/milkteaoppa(16 赞):揭穿”这不是新事” — 医学领域有教授把丈夫女儿亲戚朋友都挂 author,让他们做点数据录入就算 contribution,专门给那些想申医学院的孩子刷 publication
这条跟今天另一条 arXiv 1 年封禁规则是同一个故事的两个面 — ML 圈正在被两类人灌爆:一类是 LLM 生成的水文,一类是产业化”代发 publication”的中介。结构性问题是 NeurIPS workshop 接收率太高 + reviewer 没动力认真看 — 跟你 DS 圈做实验时”为什么 underpowered 实验也能被发”是同根的 publication bias 问题。
r/LocalLLaMA · 一张 RTX 5090 把 Qwen 3.6-27B 跑赢 GPT-5、Gemini 3.1 Pro,仅在画车的 HTML canvas 这个具体任务上
原 post link · 583 赞 · 170 条评论
发帖人 Fragrant-Remove-9031 跑了一个有趣的对比:用一个非常具体的 coding 任务 — “写一个单 HTML 文件,full-page canvas,无 library,模拟汽车侧视图开车的视差效果,车在前景静止背景滚动,车轮真实旋转,地面 / 路边元素 / 树 / 电线杆 / 远山分层不同速度运动” — 同一段 prompt,喂给本地量化的 Qwen 3.6 各个变体 + 通过 Perplexity 订阅访问的所有前沿闭源模型。
结果:本地的 Qwen 3.6-27B Q4_K_M(Q4_K_M 是一种 4-bit 量化方案,把原模型压到约 1/4 大小但保留大部分能力)跟 Kimi K2.6 thinking 并列最优 — 一起跑赢了 GPT-5 / Claude Opus 4.7 / Gemini 3.1 Pro 在这个任务上的输出。
Top comments 反应:
- u/snapo84(167 赞):“明显赢家是 Kimi K2.6 thinking 和 Qwen 3.6 27B Q4_K_M”
- u/LikeSaw(78 赞):贴了 Qwen 3.6 27B 满精度 BF16 的输出 GIF — 视觉效果更精致
- u/NigaTroubles(59 赞):“27B 一直是猛兽”
- u/NickCanCode(24 赞):吐槽 Gemini 3.1 Pro 输出 ”🤣🤣🤣“(暗示视觉效果烂)
这条配合上面 Nathan Lambert 那条一起看:3-7 个月差距 不是抽象 benchmark 而是这种具体任务上的真实手感。对 DS 工程师的实用意义 — 当你有一个 well-specified 的任务(不是开放对话),本地模型完全可以跟前沿闭源打平。Meta 内部任何 “为什么不用开源” 的会议,可以用 r/LocalLLaMA 这种 cherry-picked 但 reproducible 的对比当 anchor。
tech-leads-club/agent-skills ⭐3,322 (+923 今日) · [TypeScript]
https://github.com/tech-leads-club/agent-skills
这是干什么的:一个”AI coding agent 的技能注册中心” — 给 Claude Code、Cursor、GitHub Copilot 这类 AI 编程助手提供一个统一的、经过安全审查的”技能仓库”。今日新增 923 星,是今天 trending 增速最快的项目之一。
技术解读:
- Tech stack:核心是 TypeScript(微软出品的 JavaScript 强类型变种,给大型代码库加上类型安全) + MCP 协议(Model Context Protocol,Anthropic 去年开源的”AI 模型跟外部工具通信”的标准协议 — 类比 USB 之于硬件,是让 LLM 调用各种工具时不用每家自己写连接器的统一规范)。
- 核心概念是 “skill”:每个 skill 是一段定义好的 prompt + 工具调用模板,比如”读 GitHub PR diff → 写 review comment”或”读 SQL schema → 生成 dbt model”。开发者订阅 / 编辑 / 共享 skill。
- 跟 Eric 现有工具的关系:你在用的 Claude Code 已经支持 skill(vault 里
.claude/commands/*.md就是 skill),这个项目想做的是跨工具的 skill 标准 + 中央仓库,类比 npm 之于 JavaScript 包、PyPI 之于 Python 包。
短期不直接用 — 你的 cemu / fitness-log / spp 这些 skill 已经写在 vault 里跑得很好,没必要迁移。中长期值得看:如果 agent skill 真的标准化了,你的 .claude/commands/ 模式可以 export 成符合 spec 的 package,被其他工具(Cursor / Codex)调用 — 你的 Second Brain workflow 就不绑定在 Claude Code 一家上了。
All-In · Trump-Xi 峰会、Benioff 谈”这不是我第一次 SaaS 末日”、OpenAI 起诉苹果、多模态 AI、厄尔尼诺
主持 Chamath / Jason / Sacks / Friedberg · 嘉宾 Marc Benioff(Salesforce CEO)· 2026-05-15 · YouTube
本期是 Episode 273,主嘉宾 Marc Benioff 全程,话题覆盖 Trump-Xi 峰会评估、SaaS 板块估值崩塌、Salesforce 的 AI 战略、OpenAI vs 苹果的合约纠纷、厄尔尼诺潜在能源 / 食物危机。
这期讲了什么:
-
Benioff 给 SaaSpocalypse(SaaS 板块过去 6 周估值集体腰斩)泼冷水:他自己 25 年 CEO 任内”这是第三次 SaaSpocalypse” — 2016 互联网泡沫余震、2020 疫情、现在这次 AI 替代恐慌。他的观点是市场把 SaaS 重估到”销售额 2 倍 PS(市销率 Price-to-Sales)“是 过去 20 年从未有过的低点 — 他自己关心的不是股价是 Salesforce 今年预计 460 亿美元营收 + 160 亿美元自由现金流。
-
Salesforce 一年烧 3 亿美元买 Anthropic token(用在 coding agent 上)。Benioff 直接断言:“Anthropic was right: coding agents. That is the rocket ship that will not stop.”(Anthropic 押对了 — coding agent 是停不下来的火箭)。但他同时预测 “token routing intermediary” 这种中间层会出现 — “大部分 token 没必要直接打到 Anthropic”,会有公司专门做 token 路由优化省钱。
-
Trump-Xi 峰会 Friedberg 框架:“经济捆绑是 Thucydides Trap(修昔底德陷阱 — 新兴大国必然挑战守成大国)的解药”。Chamath 接力:本届美中政府都在 “分蛋糕” — 把全球分成西半球(美主导)、太平洋(中主导)、中东(双方代理人共治),通过 贸易而非战争 划势力范围。Benioff 印证:他被 Trump 带去北京见了 Xi,亲历”两边都不想打”的氛围。
-
四人一致支持把高端芯片卖给中国。Chamath 的话最直白:“sell the chips … let Jensen win, I’d rather he win than Huawei win”(卖芯片,让黄仁勋赢,我宁可他赢也不要华为赢)。逻辑:中国 model 已经追上来了,禁运只是逼中国把自己芯片产业链养出来,反过来吃掉 Nvidia 长期市场。
-
Chamath 预测 18 个月内台湾在芯片地缘政治里”不再重要”。理由:美国本土晶圆厂(Intel + TSMC Arizona + Samsung Texas)+ 中国大陆 SMIC 28nm 以上节点产能 — 18 个月内会把”台湾不可替代”这个前提击穿。一旦台湾不再是芯片地缘焦点,台海军事风险结构变化。
-
OpenAI 准备起诉苹果。Bloomberg 报道 OpenAI 原本预期苹果跟 ChatGPT 集成会带来”数十亿订阅收入” — 实际上 Apple 内部因隐私 + 自家硬件竞争担忧拖着没推。Friedberg 补充:Google 在这场对决里其实位置更好 — Gmail / Drive / Docs 集成是 OpenAI 没法复刻的护城河。
-
Thinking Machines 发了多模态实时模型:能把桌面 + 音频 + 视频源 每 200 毫秒 上传一次,分两个并行流处理(一个深度思考、一个实时响应)。Chamath 警告这意味着 如果部署到 8 小时工作日,token 需求会涨 1000 倍 — 这是把”算力是新石油”从口号变成账本数字的具体路径。
-
Friedberg 量化厄尔尼诺潜在风险:海洋储存 1100 万 TWh(太瓦时) 能量 ≈ 人类 500 年总能耗。今年 El Niño 强度看似回归 — 预测路径:北美 / 巴西 / 印度热浪破纪录 → 农作物减产 → 配合伊朗局势导致的化肥短缺 → 印度季风若再出问题,15 亿人粮食受影响。
-
Anthropic 出手切除 “Dark SPV”(指未经公司授权、把员工股权层层包装转售给二级市场的影子结构)。Chamath 力挺:层层 SPV “是灾难配方”。他预测:SpaceX、OpenAI 一旦 IPO,会爆发后续诉讼潮 — 二级市场买家发现自己付了 N 层 carry fee + 价格被人为抬高。
-
AgentForce 一周打 5 万个销售电话(Benioff 数据)。这不是”AI 协助销售”是”AI 当销售” — 把以前 100 人销售队一年的覆盖量压到一周。
金句:
“It’s not my first SaaSpocalypse — 2016 我经历过、2020 我经历过、现在第三次。每次都说 Salesforce 完了,每次都没完。” — Marc Benioff
“Sell the chips. Let Jensen win. I’d rather he win than Huawei win.” — Chamath Palihapitiya(对芯片禁运的态度)
“Coding agents — that is the rocket ship that will not stop.” — Marc Benioff
Benioff 是过去 25 年企业软件最重要的 CEO 之一,这是难得一次他亲口讲”AI 时代的 SaaS”路线 — 不是分析师推测。对 DS career 视角的关键 takeaway 是 Salesforce 3 亿美元 / 年 token 预算给出了”企业级 LLM 用量”的真实参照系,Meta 内部规划同类项目可以引用。Chamath 关于台湾 18 个月去地缘化的判断激进但论据具体,值得记下来 6 个月后回头核对。
棋赌(Gambonanza)(Gambonanza)
Source · DualShockers · 2026-05 · link · 评分 9/10
PC / Steam Deck / Android / iOS · 开发商 Blukulélé · 类型:象棋 roguelike deckbuilder · 价格 ~$10
Review 主旨:
DualShockers 的 Ethan Krieger 直接把 Gambonanza 描述成 “如果 Balatro 是用国际象棋做底”(Balatro 是 2024 年那个用扑克 + 小丑卡片改写规则的 roguelike 神作,至今没人复刻成功,全球销量超千万)。两者视觉风格几乎双胞胎 — 同款 CRT 显像管美学、同款波纹背景。但 Krieger 写:“Gambonanza deserves a seat at the table”(它配得上独立坐席,不只是模仿)。
核心 mechanic(机制):把国际象棋拆解重组成 roguelike:
- 目标变了:不是将死对方国王 — 是 吃光对方所有棋子
- 棋盘小了:5 x 5、6 x 6 之类的小棋盘,分 5 大关 5 小关推进
- 场上限 3 子起步:你随机抽到的兵种 + 升级路线决定 build
- 核心创新是 Gambit(开局战术)系统 — 类比 Balatro 里的 Joker(小丑卡,永久改变规则的修饰符)。例:
- “如果你场上同时有 King 和 Rook,每回合 1/3 概率跳过对手回合”
- “你的 Bishop 可以像 Queen 一样走”
- “升变区域扩大到 2 行”
- 板凳系统:buy / swap 棋子像 deck 编辑
- Permadeath:被吃的棋子永久死
每局约 3 小时 — 适合 Steam Deck 或手机短时间打。打通后解锁随机布局 + 难度修饰符,把早期”重复对局”的 weak point 转成 mastery loop。
Krieger 9/10 的核心理由:“重学国际象棋”的过程本身就是 mechanic 的一部分 — 你对兵种的固有理解被 Gambit 反复颠覆,每次 run 都在重新评估”什么是好的发展、什么是好的兑子”。
非官方多人玩法是惊喜:单机游戏,但 Krieger 跟朋友讨论选 Gambit / 选棋子,体验明显加深 — 类似看朋友打 StS 给意见。
acid test 强过 — 特色机制 = “把国际象棋拆成 roguelike 元素”,review 用整段把 Gambit 系统讲透。你 TFT 的”自走棋 + 经济管理 + 兵种 synergy”脑子直接可以平移过来 — Gambonanza 把 TFT 的”装备 + buff” 替换成”Gambit + 自由棋子组合”,时间维度从实时压成回合制。比 StS 节奏更慢更脑力(你要计算 3-4 步),但每局 3 小时跟 StS act 1 差不多。Steam Deck 上躺着打很适合。