2026年5月9日星期六
阴 · 2026-05-09(周六)
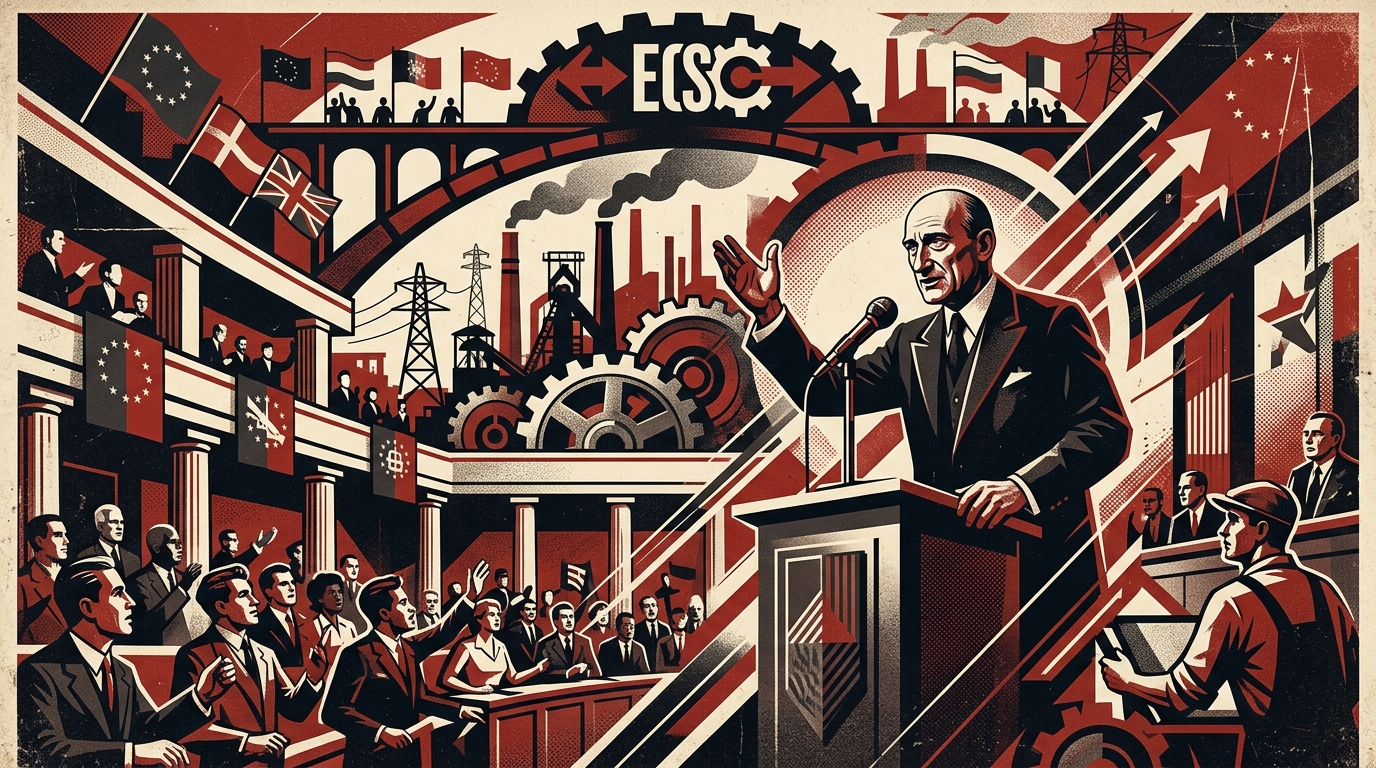
罗伯特·舒曼宣读《舒曼宣言》(1950)— 苏联宣传画
历史上的今天
1950:法国外长罗伯特·舒曼(Robert Schuman)在巴黎奥赛宫记者会上宣读《舒曼宣言》,提议把法德两国的煤炭和钢铁生产置于一个共同的”高级公署”管理之下——意在让”战争不再可想象,而且物理上不可能”。这一天后来被定为”欧洲日”,被视为欧盟的诞生时刻。讽刺的是 76 年后的今天,普京在莫斯科红场举行规模缩水的胜利日阅兵——同一个 5 月 9 日,欧洲讲共同市场让战争消失,俄罗斯讲军事胜利。
中国 4 月出口同比暴增 14.1% — 在伊朗战争 + 美国关税双重压力下创历史新高
Source · NYT Business / 凯思·布拉德舍(Keith Bradsher) · 2026-05-09 · link
Why this — 中美峰会前夜放出的信号:关税围堵 + 中东战争双重逆风都没拖住中国出口曲线,反而对美顺差扩大到 877 亿美元。这是特朗普下周访京谈判桌上最难的一组数字。
中国海关周六公布数据:4 月出口同比增长 14.1%,远超经济学家预期的 7.9%,相比 3 月份 2.5% 的疲软增速大幅反弹。贸易顺差一个月内从 511 亿美元跳到 848 亿美元。进口同比也涨了 25.3%——主要是工厂抢囤元器件,担心中东战火继续推高输入成本。
这组数据有几层意味。第一,前四个月对美出口虽然下降了 10.2%,但中国对美贸易顺差仍累计扩大到 877 亿美元——说明所谓”脱钩”在数字上根本没发生。第二,去年中国录得 1.19 万亿美元全球贸易顺差(破自己保持的 9920 亿美元世界纪录),今年看势头还在加速。第三,特朗普的关税武器刚被两次法院判决削弱(5 月 8 日),他下周访京时手里能打的牌比立项时少了一半。
ING 大中华区首席经济学家 Lynn Song 给的解读:今年外需仍是中国增长的稳定引擎,半导体和汽车出口是主力。中国第一季度 GDP 增速 5%——卡在政府全年目标区间的上限,也意味着北京暂时不需要急着加大刺激。
普京”缩水版”胜利日阅兵:红场没有军备方阵,只剩一段独白
Source · BBC / Steve Rosenberg · 2026-05-09 · link
Why this — 红场阅兵的硬件不见了——这本身就是一条新闻。BBC 驻俄编辑 Rosenberg 现场观察:克里姆林宫”通常用来炫耀的军事硬件,今年一件都没有”。
胜利日(5 月 9 日)是俄罗斯纪念二战苏联战胜纳粹德国的最高规格国家仪式。今年的不同之处:往年红场上推出来的洲际导弹运载车、坦克方阵、装甲车队全部缺席,只剩士兵列队走过。普京在演讲中继续用胜利日的合法性外壳为乌克兰战争正名,把所谓”特别军事行动”嫁接到反法西斯叙事里。但视觉信号是反着的——你不可能既说”俄罗斯军力强大正在赢”,又拿不出一辆坦克给全国电视直播。
平行叙事:同一天特朗普宣布俄乌”三天停火”(5 月 9 日—11 日),覆盖胜利日时段,附带每边 1000 名战俘交换。这听上去像普京在给特朗普递台阶——胜利日不爆冲突,换一个谈判窗口。
国际网络攻击瘫痪 Canvas,全球数千所学校和大学受影响
Source · BBC · 2026-05-09 · link
Why this — Canvas 是全球教育领域用得最广的学习管理系统(LMS)之一,被加州大学系统、斯坦福、哈佛等几乎所有大型美国高校采用。一次攻击同时打挂”数千所”机构是一个新量级的事件。
一个黑客组织突破了 Canvas(教育软件平台 Instructure 旗下)的系统,影响范围横跨多个国家的中小学和大学。具体被泄露的数据范围、勒索金额、攻击者身份目前都还没披露。
值得关注的是教育部门正在变成网络攻击的一类新优先目标——医疗、能源、金融之外,教育数据池积累了大量未成年学生信息 + 学术研究数据 + 高价值身份信息(学生 + 教师 + 校友),但相对防御预算远低于上述三个行业。这不是第一次校园 LMS 被攻击,但同时打瘫多国规模是新的。
美国债务首破 GDP — 31 万亿美元里程碑,公众无感
Source · NYT The Morning / Evan Gorelick · 2026-05-08 · link
Why this — 美国联邦债务正式超过年度 GDP 总量。这个临界点经济学家警告了二十年,今天到了,但市场没崩、选民不在乎、两党都在加大支出。
NYT 商业记者 Tony Romm 报道:美国国债存量首次超过年度国内生产总值(GDP),到 31 万亿美元规模,债务/GDP 比首次破 100%。历史上这个比例只在二战末期短暂超过过。但这一次的特殊之处:(1) 不是战争或大萧条触发的临时性高位,是结构性赤字常态;(2) 利率比战后高得多,光是利息支出就已经超过国防预算;(3) 两党都不打算缩减——民主党要扩社保和气候支出,共和党要减税。
The Morning 简报问了一个关键问题:为什么市场和公众对这个数字”不烦不躁”(unbothered)?大致几个原因:(1) 美元仍是储备货币,海外仍在买国债;(2) 通胀已从 2022 年高点回落,稀释了债务实际负担;(3) 灾难叙事讲了二十年都没应验,“狼来了”麻木。但 NYT 的隐忧立场是:当市场终于开始要求更高的债券收益率溢价时,调整速度会比所有人预期的都快。
澳大利亚右翼民粹党”一国党”首次拿下众议院席位
Source · BBC · 2026-05-09 · link
Why this — 一国党(One Nation)从 1997 年由 Pauline Hanson 创立,反移民 + 反多元文化基本盘,过去近 30 年只能在参议院零星拿席。这是它第一次进入众议院。
通过一场补选拿下下议院第一个席位——这场补选被各方视为对民粹主义在澳大利亚选举吸引力的关键测试。澳大利亚一直被认为相对绝缘于欧美的民粹浪潮(强制投票 + 偏好选择制 + 经济稳定),但过去三年通胀压力 + 移民议题 + 房屋负担危机让 Hanson 长期主打的反建制叙事终于穿透。
放进更大的图景看:本周英国地方选举 Reform UK(英国版反移民党)大胜(5/8 sent log),匈牙利 Tisza 党横扫执政 16 年的 Orbán(5/9 BBC),现在澳洲 One Nation 突破——五眼之中三个国家本周都出现传统政党被替代的信号。
英伟达 2026 前几个月已经投出 400 亿美元 AI 股权交易 — 等于一家大型 VC 基金一年的部署量
Source · TechCrunch · 2026-05-09 · link
Why this — 英伟达不只是卖 GPU 了,它在用股权撬动客户买它自己的卡。这种”循环投资”的争议本身值得关注——这要么是史上最大的护城河打法,要么是 AI 资本周期顶点最响的警铃。
具体投了什么:(1) OpenAI — 300 亿美元,迄今为止单笔最大;(2) Corning(康宁,玻璃制造商) — 高达 32 亿美元;(3) IREN(数据中心运营商) — 高达 21 亿美元;(4) 此外还有七笔多十亿美元级别的上市公司交易,加上 2026 年至今约二十多轮私人创业公司投资。
参考点:英伟达 2025 年全年参与了 67 笔风险投资交易。公司预计在 2027 年之前 Blackwell 和 Rubin 系列芯片会带来至少 1 万亿美元收入。
Wedbush 分析师 Matthew Bryson 给的定性:“明显落在循环投资(circular investment)这个主题里”——意思是钱从英伟达流出去给客户,客户用这笔钱回过来买英伟达的卡。但他也承认:如果这些被投公司真的成功,英伟达就建成了同行无法复制的”竞争护城河”。
注解:循环投资为什么是争议——批评者类比 1999 年互联网泡沫期间,思科(Cisco)借给客户钱让客户买思科设备,账面收入猛涨,2000 年崩盘后才发现很多客户根本不能还。但英伟达的不同点是:它的客户(OpenAI、Anthropic、xAI)不是夕阳产业的运营商,是有真实终端需求曲线的;护城河论调成立的概率高于 1999。
英特尔股价过去一年涨 490% — 实际经营状况远没跟上
Source · TechCrunch · 2026-05-08 · link
Why this — 半导体板块这一轮反弹里,英特尔涨幅一骑绝尘。但拆开来看,市场押的是 CEO Lip-Bu Tan 的人脉网络,不是英特尔的工厂良率——这两件事差距很大。
股价过去一年涨 490%,CEO Lip-Bu Tan 在 2025 年 3 月接任后做的几件大事:(1) 跟美国政府达成合作协议,让美国政府成为英特尔的第三大股东;(2) 跟马斯克的 SpaceX 谈成晶圆代工合作;(3) 跟苹果、特斯拉签订初步制造协议。看起来都是大新闻,但都还没产生量产收入。
底下的硬数据没动:根据彭博报道,英特尔的芯片良率仍然显著落后于台积电(TSMC)。内部员工反馈 Tan 在公司内部”具体细节给得很少,部分团队的工作方式是不断调低 deadline 而不是真的把项目拉回来”。
也就是说,市场押的是叙事——白宫支持 + 名人背书 + 战略合作协议。英特尔实际生产竞争力(晶圆良率、先进制程节点跟进速度、在 AI 加速器上的份额)这些底层指标改善得很慢。如果一年内不能拿出可验证的良率突破或大客户量产订单,490% 的涨幅就是要还的。
Oracle 3 月底裁掉 2-3 万人 — 拒绝跟员工谈遣散金,“远程”分类绕开 WARN 法案
Source · TechCrunch · 2026-05-08 · link
Why this — 跟 5/8 已记的 Cloudflare 1100 人形成对比:Oracle 一刀砍 20,000-30,000 人,量级差 20 倍。两家都把员工归类为”远程”绕开 WARN 法案保护。这不再是孤例,是一种正在被 HR 部门系统化的合规漏洞。
3 月 31 日,Oracle 通过邮件解雇了估计 2-3 万员工。被裁员工最先发现的方式是公司系统突然登录不上去。Oracle 给的遣散包:第一年 4 周工资,之后每多一年加 1 周(上限 26 周)+ 1 个月的 COBRA 医疗保险延续 + 未行权的 RSU(限制性股票单位)一律作废。一位资深员工损失了价值 100 万美元的未行权股票——本来再过 4 个月就 vest 了,RSU 占他总薪酬的 70%。
WARN Act(《劳工调整与再培训通知法》)本来要求 50 人以上的大规模裁员要提前两个月书面通知。Oracle 把员工归类为”远程”——意思是这些人不在某个具体办公室所在地,绕开了法律按”地点”触发的条件。即使在适用 WARN 的情况下,Oracle 也把”两个月预先通知期工资”算在了已经给的 4 周遣散金里,等于零额外补偿。
至少 90 名被裁员工联合签了一份公开请愿信,要求 Oracle 给 Meta / 微软 / Cloudflare 同等水平的遣散包(Meta 给的是加速 vesting + 更高的基本工资倍数 + 延长医疗保险)。Oracle 拒绝任何谈判,take-it-or-leave-it。
这条新闻的产业含义:AI 时代企业级裁员正在重写规则。“远程员工 + WARN 法案豁免”的组合是一个被发现的合法套利路径,之后预计会被更多公司学习。对在大公司的员工来说,签 offer 时的”完全远程”如果意味着将来失去 WARN 保护,需要重新评估。
MELO:分布漂移下的”多记忆尺度对冲”在线预测
Hedging Memory Horizons for Non-Stationary Prediction via Online Aggregation
作者 · Yutong Wang, Yannig Goude, Qiwei Yao(LSE / EDF / 法国国家电力公司)· arXiv:2605.06541 · link
时间序列预测里有一个老问题:模型用多长的历史数据才合适?历史短则跟得上 regime 变化(比如疫情、政策切换)但噪声大;历史长则更稳但跟不上分布漂移。在不知道接下来几期会不会有 regime shift 的设定下(在线预测),事先选定一个”遗忘因子”必然要么过敏感要么过迟钝。
MELO(Memory-hedged Exponentially Weighted Least-Squares Online aggregation)的思路:不选一个遗忘因子,对一组遗忘因子全部跑预测然后做”在线聚合”。具体三层:(1) 拿任何一组现有的非超前预测器(baseline pool);(2) 对每个 baseline 用多个不同遗忘因子做 EWLS(指数加权最小二乘)适应——形成多个适应专家;(3) 用 MLpol(一种无参数在线聚合规则)把”原始预测 + 各种遗忘因子下的 EWLS 适应预测”统一聚合给最终预测。
理论结果:在有界条件下能跟”事后看最好的原始预测器”和”事后看最好的有界、随时变化的仿射组合”竞争(差距是路径长度依赖的追踪成本 + sublinear 聚合代价)。
实证:在法国全国电力负荷预测的 COVID 封锁期数据上——没有任何 regime indicator、没有封锁日期、没有政策协变量——MELO 整体 RMSE 比仅用基础预测器 + MLpol 低 34.7%,而且整体 RMSE 还低于专门给了”COVID 政策响应协变量”的 TabICL 基线。每步只需要轻量级递归更新,不需要重新训练。
这篇对你 Meta DS 工作里的电商 / 用户参与度类时序预测有直接借鉴:你不需要在 Q4 假期 / 模型更新 / 算法调整 / 政策事件这些 regime shift 来临前先建一个 indicator——MELO 用纯算法层面对冲多个记忆尺度,比”训一个能感知 regime 的元模型”省事得多。SPP paper trader 也用得上——市场 regime(牛市/熊市/横盘)切换不需要你预先 label,跑多个不同 lookback 窗口的回归,让聚合层自己决定权重。代码实现就是 numpy 写多个 EWLS + MLpol(论文应该有 R 实现),周末能 prototype 出来。
ml-sharp-web — 苹果 SHARP 模型直接在浏览器跑的 3D Gaussian Splatting
https://github.com/bring-shrubbery/ml-sharp-web
苹果今年发的 SHARP(一个把图片转 3D 高斯点云的开源 ML 模型)通过 ONNX runtime + WebGPU 在浏览器里跑——图片不离开本机,全程不上传服务器。HN Show 183 分 / 46 评论。3D Gaussian Splatting 是过去两年最重要的 3D 重建技术,原本要 Python + CUDA 才能跑的模型现在浏览器端就能搞定 · 谁会用:想把 3D 重建嵌入 web 产品的 frontend 开发者、做空间计算 / AR / 3D 资产生成的 ML engineer、需要”零部署 + 隐私优先”演示 AI 能力的 demo 作者。
直接 fit 不上你 DS 工作(你不做 3D / 视觉),但这个项目展示的范式有借鉴:WebGPU + ONNX runtime 让客户端跑 ML 模型变得现实。如果你 Resume AI 那个副业未来要加”在浏览器里跑一个本地 LLM 给学生免费用避免 API 成本”,这套技术栈就是现成的——bring-shrubbery 的代码可以照抄。值得收一下 awareness。
r/MachineLearning · 我们撞墙了 — 想让 transformer 做真正的”逻辑推理”这条路走不通
原 post link · 176 upvotes · 0.84 ratio
发帖人是个在生产环境用 LLM 做结构化推理的工程师,写了一篇略带情绪的长帖:在 OpenAI o 系列、Claude Opus、Gemini 2.5 Pro 都试过之后,他们团队的结论是 transformer + chain-of-thought 在做需要严格逻辑链的任务(比如多跳约束满足、形式化证明片段、SQL plan 验证)上还是会反复在边角 case 上崩——“准确率从来不到 99.5%,而生产系统需要 100%“。他主张产业需要”完全转向更扎实的范式”(implicit :神经符号、形式化方法、grounded reasoning),否则就是一直 patch edge case patch 到天荒地老。
Top comments 反应:
- 反对派最高赞回应:你说的”撞墙”实际是你期望错了——LLM 从来不是用来在 100% 正确性 setting 跑的,它是 90-95% accuracy 配人审核的工作流。如果你需要 100%,写 SAT solver。
- 中间派:同意 transformer 不擅长 strict logic,但”完全转向”是过度反应。当前 frontier 是 RL 后训练 + 工具调用(让 LLM 学会调用 SAT solver、Python interpreter),而不是放弃 transformer 架构本身。
- 学术派:神经符号(neuro-symbolic)研究 30 年了,一直没真正 scale up 过。说”我们需要新范式”和”我有新范式”是两件事,后者难。
这种”我们撞墙了所以要换范式”的 OP 帖在 r/ML 每隔几个月就出一次,信号意义在于它什么时候出 + 谁在转发——这次出在 GPT 5.5 / Claude Opus 4.7 / Gemini 3 三家都到位之后,说明前沿用户对边际能力提升的耐心阈值正在下降。但 top comment 说得对:DS / ML engineering 的实战智慧从来不是单押一个范式,是 LLM + 工具调用 + 形式化验证三层叠加。
r/LocalLLaMA · Qwen3 35B-A3B 在 12GB 显存上能跑得不错 — 实测最佳配置
原 post link · 523 upvotes · 0.92 ratio
Qwen3 35B-A3B 是阿里发布的新一代 MoE(Mixture of Experts)模型——总参数 35B 但每次只激活 3B 专家,所以理论上推理成本接近 3B 模型但能力接近大模型。OP 实测在一张 12GB 显存(消费级,比如 RTX 3060 / 4070)的卡上跑这个模型的最佳 llama.cpp 参数:
-c 32768 -ncmoe 20 -ctk q8_0 -ctv q8_0 -t 9具体含义不重要,重要的结论:context window 拉到 32K、KV cache 用 q8 量化、把 20 个专家 offload 给 GPU——常规解码速度能跑到”很流畅”。
Top comments 反应:
- 验证派:跑过 Strix Halo(AMD 集成显卡 + 大内存方案),同款配置跑 Qwen3 30B 速度比预期更好,证明这个 MoE 设计对中端硬件友好。
- 性价比派:12GB 显存的二手 3060 现在二手 1500 块人民币左右,加 32GB 内存一台能跑 35B 模型的本地推理机,总成本 5000 以内,比开 API 一年省。
- 怀疑派:本地跑这种规模模型,输出质量跟 GPT 4.1 / Claude Sonnet 4 差距还是肉眼可见,不是 enterprise-grade。
LocalLLaMA 圈子最有用的信号不是新模型发布,是这种”硬件 × 模型 × 量化”的实测数据。MoE 架构正在让”消费级硬件本地跑前沿模型”这条路变现实——这一点对自建 RAG / 私人知识库 / 不想给 OpenAI 送数据的用户是分水岭。但你 vault 用 qmd + Claude API 的 stack 已经够好用了,本地跑模型 ROI 不高,这条记下来 awareness 就行。
rohitg00/agentmemory ⭐3,332(今日 +518)· [TypeScript]
https://github.com/rohitg00/agentmemory
这是干什么的:给 AI 编程助手(Claude Code、Cursor、Codex、Cline 等)加一层”持久跨 session 记忆”——agent 不再每次开新对话都要重新解释项目架构、你的偏好、历史决策。所有 agent 通过统一 REST API(端口 3111)共享同一个记忆库。在 LongMemEval-S 基准上达到 95.2% 的 R@5 召回率(vs BM25-only 的 86.2%、mem0 的 68.5%、Letta 的 83.2%),同时号称比”用 LLM 总结”路线省 92% token——一年用量 17 万 token vs 65 万+。
技术解读(Eric 是 DS 不是 SWE,技术术语都解释一遍):
- 核心架构 — 四层记忆,借鉴人脑睡眠期记忆巩固:(1) Working Memory(工作记忆)= agent 工具调用的原始日志;(2) Episodic Memory(情景记忆)= 单 session 压缩成事件摘要;(3) Semantic Memory(语义记忆)= 抽出来的事实和模式;(4) Procedural Memory(程序记忆)= 工作流和决策模板。原始观察会自动去重 + 隐私过滤(移除 API key 和密码)+ LLM 压缩 + 向量嵌入 + 双索引(BM25 关键词 + 向量相似度)。
- 三流融合检索:BM25(关键词匹配带同义词扩展)+ 向量(稠密嵌入相似度,支持本地嵌入)+ Graph(知识图谱实体匹配遍历)三路并行,用 Reciprocal Rank Fusion(互惠排名融合)汇总——这是当前最好的混合检索范式,比单纯做向量检索的 RAG 准。
- 集成深度:Claude Code 走 12 个自动 hook + MCP server + skill 三路打通;Cursor / Gemini CLI / Codex CLI / Cline / Goose / Claude Desktop / Windsurf / Roo Code 走 MCP;Aider 等任何 HTTP 客户端可走 REST API。
- Tech stack:TypeScript(82% 代码)+ 自家 iii engine(一个无服务器运行时,号称替代 Express + Postgres + Redis + pm2 四件套)+ SQLite 内嵌向量索引(不用外挂 Postgres / Pinecone)+ 单命令部署
npx @agentmemory/agentmemory。 - 可观测性:每个记忆操作都发 OpenTelemetry trace,自带可视化 console。
跟 Eric 现有工具的关系:你 vault 里 qmd + Claude Code 这套 stack 已经做了类似的事——qmd 给你 vault 的 BM25 + 向量混合检索 + MCP server。但 qmd 是”vault 静态语料的检索”,agentmemory 是”agent session 间的动态学习”。这两个是互补的:qmd 帮 Claude 知道你 vault 里有什么,agentmemory 帮 Claude 知道你最近在做什么、你改过哪些决定。
值得装。具体路径:(1) Eric 这种重度 Claude Code 用户,每天开 5+ 个 session 跑 cemu / fitness / quotes / SPP,每次都要重新解释上下文——这个 repo 解决的就是这个痛点。(2) 装好之后,跨 session 你说”上周 cemu 阴面 hero 图换风格的事我们决定怎么搞了?“它直接答得上,不用你重新读 changelog。(3) 95.2% R@5 这个数字我会保持怀疑(benchmark 经常 cherry-pick),但 92% token 节省是直接可验证的——一周用过就知道。建议下周开个分支测一周对比 baseline。
All-In Podcast · Elon 拿下 Anthropic 大单、AI 下一个垄断者、“FDA for AI” 恐慌、押注 AI 牛市
主持 Chamath Palihapitiya / Jason Calacanis / David Sacks · 嘉宾 Brad Gerstner(Altimeter Capital 创始人,AI infra 公开市场视角)· 2026-05-09 · YouTube
本期主线:上周宣布的 Elon-Anthropic 巨额数据中心合同(22 万张 GPU + 300 兆瓦电力)背后的战略含义——Elon 正在悄悄变成”AWS 之外的第四家超大规模云”,Sacks 抛出”Anthropic 可能成为人类历史上最大垄断”的论断。
这期讲了什么:
- Elon 把 Colossus 1 整个数据中心租给了 Anthropic——上周的事件。Anthropic 拿到 220,000 张英伟达 GPU、超过 300 兆瓦电力。生效后 Claude 已经把 Claude Code 速率上限翻倍 + 移除高峰期付费用户上限 + 给 Opus 模型加 API 配额。xAI 自己已经迁去 Colossus 2 训练,所以这是 Elon 顺便变现一个”过剩”的数据中心。
- Chamath 的核心论点:Anthropic 和 OpenAI 的收入表现跟需求无关,完全是供给约束——他们要是有无限电力,收入曲线还会更陡。年内本来要上线 9 GW 新数据中心容量,现在快 50% 在被各地居民抗议——Brad 直接讲:“这不是有机的本地居民抗议,是高度组织化的活动家在跨州做这件事,跟 30 年前阻止美国建核反应堆是同一批 playbook,结果就是中国在建 100 个,美国 0 个”。
- “Elon Web Services” 框架——Brad 的提法:SpaceX 现在变成”五层蛋糕”——发射、连接(Starlink)、计算(Colossus)、空间数据中心、应用模型。租 Colossus 给 Anthropic 这一笔预计今年额外贡献 40-50 亿美元收入,分析师此前预期中位数才 200 多亿。这一刀让 SpaceX IPO 的估值故事从”押 xAI 必须很快赚钱”变成”hyperscaler 业务自带现金流”。
- Sacks 的”垄断”论断:Anthropic 过去三年每年 10× 增长,今年 Q1 ARR 从 100 亿涨到 300 亿,4 月一个月又跳到 440 亿。“如果他们今年继续 10× 出口(年底 1000 亿 ARR)、明年再翻几倍冲到 1 万亿 ARR,这就不是 Mag 7 了,是比 Mag 7 加起来还大的单一公司”。Dario 自己叫 AGI,Sacks 直接叫”人类史上最大垄断”。
- TAM 检验:Sacks 的反方自检——光是软件开发市场全球年支出已经 1 万亿美元(程序员工资 + 周边),AI 编程不是吃掉这块市场,是把这块市场翻倍到 2-4 万亿(因为现在不写代码的人都能写)。所以 1 万亿 ARR 在 TAM 上撑得住,问题只剩供给(电力、芯片)和竞争反应(Google / OpenAI / Elon 自家 Grok 怎么追)。
- 押注 AI 牛市的姿态:Brad 是”满仓持有 Mag 7 + Anthropic + SpaceX”派;Chamath 强调”基础设施层比模型层更值钱”——SpaceX IPO 明年要上市,估值预期 40-50× 收入(vs Mag 7 当前 25× 收益),原因就是 Elon 个人能溢价 + 跨多个万亿 TAM 市场(航天、电信、计算、能源)。
- “FDA for AI” 恐慌:白宫圈最近泄出来要给 AI 设监管框架的讨论,业界激烈反应。Sacks 立场:现有 FAA、SEC、FTC 监管框架完全够用——任何”AI 专属监管局”都会被 in-house 大公司游说俘获,事实上保护现有玩家、阻击 startup。这是反 AI 监管派的标准论点。
- 一个新趋势点:Chamath 押注**“分布式 compute”**会火——把 GPU 装进家庭 Tesla Powerwall、车里、Starlink 终端,让闲置算力变成挖矿一样的微型云供给。已经有公司(PYHomes + SPAN)在每户美国新房旁边装小型数据中心了。
金句:
“Congratulations to Dario on winning the AI race. I don’t mean he’s won it, but he is winning it right now.” — David Sacks
“Unless something changes about their current trajectory, Anthropic will be the most powerful monopoly ever created in human history.” — David Sacks
这一期把上周 Elon-Anthropic 大单背后的战略含义讲透了——Sacks 那段”人类史上最大垄断”的话术虽然 hyperbole,但底下的算术(10× 年复合 + 1 万亿 TAM)站得住。值得对照 Dwarkesh 4 月那期 Dario 访谈一起看:Dario 说 2029 全行业 AI 收入合计 1 万亿,Sacks 说 Anthropic 一家 2027 就到 1 万亿——两个数差了 7 倍但都来自同一个 trajectory,方差就在”前沿模型市场是赢家通吃还是分散”。对 SPP 项目和 DS career 都是关键判断:如果 Anthropic 真垄断了,Claude API 价格曲线会怎么走、你的 paper trader stack 该不该现在多元化模型供应商。