2026年5月5日星期二
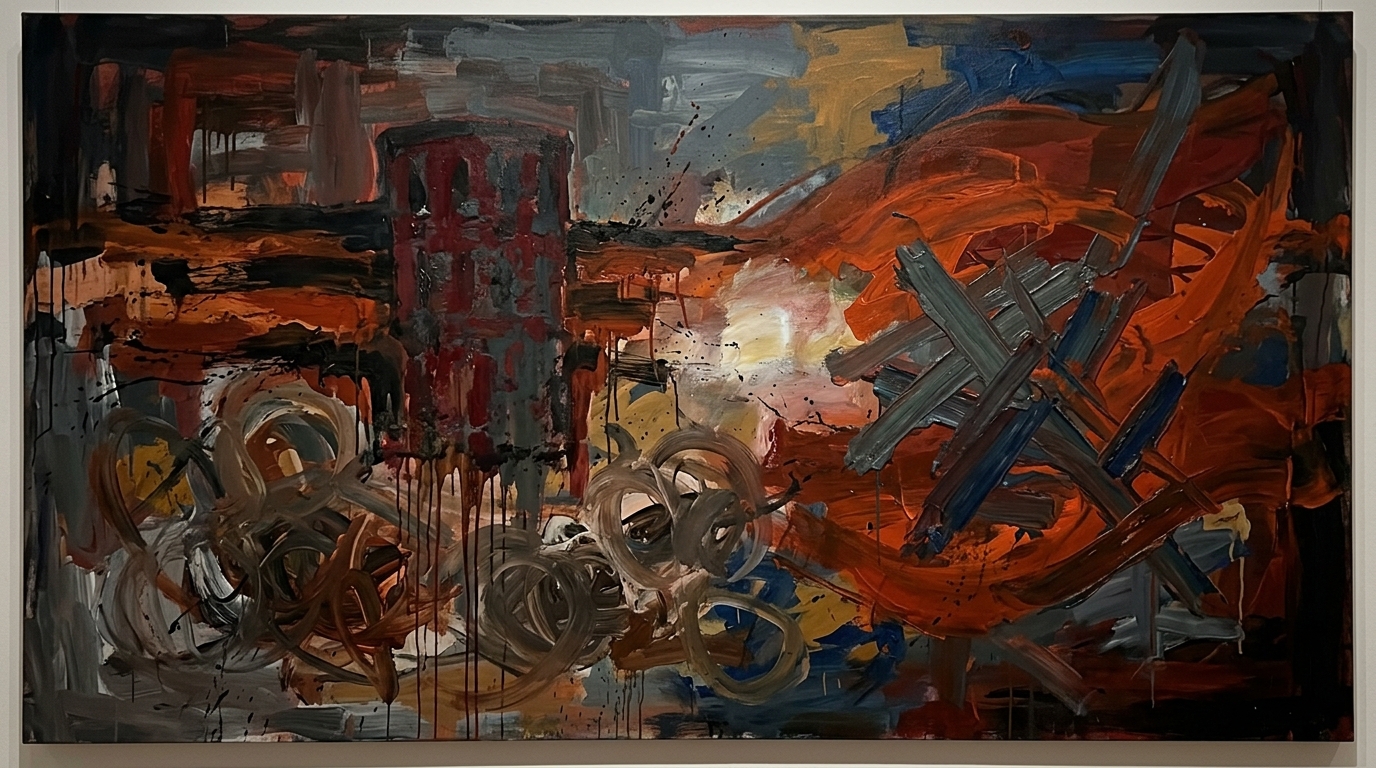
卡尔·马克思诞生(1818)— 抽象表现主义
历史上的今天
1818:卡尔·马克思(Karl Marx)出生于普鲁士特里尔(Trier,今德国西部小城)— 之后 200 年里,西方思想史上恐怕没有第二个人像他这样同时被神化和妖魔化。资本主义批判 / 历史唯物主义 / 异化理论这些 framework,今天在 AI 替代劳动力 / 平台资本积累 / 全球供应链 三个最热的当代问题里全部活着。
美伊霍尔木兹海峡僵局升级:Maersk 货轮在美军护送下首次成功通航
Source · New York Times World / Business · 2026-05-05 · link
Why this — 战火第二阶段:美军护航从声明落到实操,伊朗(Iran)和美国双方都宣布”控制”了海峡。
由 Maersk(马士基,全球最大集装箱航运公司之一)子公司运营的一艘悬挂美国国旗货轮,已在美军军事指引下成功穿过霍尔木兹海峡(Strait of Hormuz)— 这是特朗普(Donald Trump)上周宣布”打破伊朗封锁”计划后第一艘公开走完全程的商船。美国国防部长 Pete Hegseth 把这次通航称作”美国新护航倡议”的成功,但同时承认整体航运量并未恢复 — 全球约 20% 海运原油走这条水道,正常日均通过 30+ 艘油轮,目前只有寥寥个例。伊朗官方媒体则说德黑兰对海峡的控制”反而加强了”,公开矛盾的两套叙事意味着任何商船公司在拍板复航时都得自己赌一次。短期看油价波动,中期看伊朗会不会真出手击沉一艘试探美国底线,长期看这种”美军单边商业护航”模式会不会变成中东未来 10 年的默认 posture。
伊朗外长访华,比特朗普访京早 10 天
Source · South China Morning Post(南华早报)· 2026-05-05 · link
Why this — 中国正在被两边同时拉去当 Iran 危机的最大调停人选项,时间点不是巧合。
伊朗外长 Abbas Araghchi 周三抵达北京,距特朗普即将到访(5 月中旬)只剩 10 天。SCMP 报道这次访问的明确议题:让中国在美伊海峡军事对峙里”发声”,特别是利用中国作为伊朗最大原油买家的杠杆向美国施压。背景几个关键点:第一,2023 年中国主导的沙特-伊朗复交协议是北京中东外交的高光时刻,伊朗这次主动来华是想再触发一次”中国斡旋”;第二,中国从伊朗买油占伊朗出口约 90%,美国制裁逼伊朗,等同于逼这条贸易线 — 北京在算账时不只是政治账还是能源账;第三,特朗普访京时几乎一定会要求中国在海峡问题上选边。这条新闻配上同一天的 Maersk 通航 — 你看到的是中国正在被推到中东仲裁人位置,而它从未明确想要这个角色。
海湾内部裂痕公开化:UAE 跟沙特正在能源、地缘、远景三条线上分歧
Source · New York Times World · 2026-05-05 · link
Why this — 过去 30 年中东 GCC(海湾合作委员会)“统一战线”叙事的根基开始松。
NYT 周二刊出长报道,记录阿联酋(UAE)和沙特阿拉伯(Saudi Arabia)两国关系正在多个维度上变冷。三条主要矛盾:第一,OPEC+ 内部的产油配额,UAE 想要多产、沙特想要稳价,沙特 2025 年甚至单方面”惩罚式”增产把油价砸下来教训阿布扎比;第二,区域代理战,沙特挺也门前总统派系、UAE 挺南也门分离派,双方在 Yemen 战场上的代理武装直接对抗过;第三,未来愿景,沙特把 NEOM(沙特未来主义新城项目)和 2030 Vision 押在金融 / 旅游 / 体育,UAE 则把迪拜押在物流 / AI / 加密货币,两国在抢同一批跨国 HQ 和资金流。海湾官员对外仍说”竞争是健康的”,但 NYT 援引多名熟悉双方政府的人士称私下沟通已经”明显冷淡”。这件事的 longer arc:阿拉伯世界统一对外的板块正在裂开,对中美俄三家来说都是新的机会窗口。
罗马尼亚总理被议会不信任投票推翻,最大党反水投极右
Source · BBC News · 2026-05-05 · link
Why this — 欧盟(EU)东翼又一根支柱在右移,Bolojan 倒台是 2026 年欧洲政治最干脆的一次崩盘。
罗马尼亚(Romania)总理 Ilie Bolojan 在不信任投票中失利下台 — 直接 trigger 是他执政联盟里最大的中左党 PSD(Social Democrats)跳过来跟极右反对派 AUR(Alliance for the Unity of Romanians,疑欧 / 反 NATO 援乌阵营)联手投了反对票。这意味着罗马尼亚 — NATO 东翼最重要前哨之一,乌克兰最大粮食和军援陆路通道国 — 政府大概率要重组,亲乌路线极可能受冲击。背景:罗马尼亚 2024 年总统选举因极右候选人 Călin Georgescu 当选首轮被宪法法院取消,引发”司法政变”指控;本届议会随后塞了大量极右议席。Bolojan 倒台标志着 PSD 已经判定继续靠拢 EU 主流不再划算,开始公开跟 AUR 试水。下一个观察点:欧盟内部其他东翼成员国(捷克、斯洛伐克)会不会跟着发生类似板块漂移。
美国 3 月贸易逆差扩大,最高法院 2 月推翻关税后进出口都涨
Source · New York Times Business · 2026-05-05 · link
Why this — 关税被司法系统推翻一个季度后的第一轮”自然实验”数据出来了,跟川普团队预期反着走。
美国商务部周二公布数据:3 月贸易逆差比 2 月扩大,且进出口同时增长 — 这是今年 2 月美国最高法院裁定特朗普 2025 年大量”对等关税”违宪后的第一份完整月度数据。最高法判决出来时,川普团队的官方叙事是”关税是美国制造业回流的关键,被推翻后短期会乱、长期照样能维持”;财政部反对派则一直说”关税本来就同时压抑了出口(报复性关税 + 强美元),推翻后两边都会回流,不是单方面”。3 月数据落在第二种解释一侧。这个数据点对接下来的 NBER(美国国家经济研究局)正式宣布是否进入衰退、对美联储 6 月议息、对民主党 2026 中期选举叙事都是一手材料。Eric 注:你做实验设计天天讲的那种”政策被外生 shock 突然取消” 类自然实验,在美中贸易战这套数据里下个 12 个月会有十几个落地。
Stratechery:Amazon 在训练时代落后,但在推理时代押对了赌注
Source · Stratechery (Ben Thompson) · 2026-05-05 · link
Why this — Ben Thompson(业界最资深的科技战略分析师,Stratechery 作者)解读 AWS 为什么在 OpenAI / Anthropic 训练大战里沉默 + 现在突然抬头的内幕。
Stratechery 主篇分析 Amazon 上周财报和 Trainium(Amazon 自研 AI 芯片,对标 Nvidia GPU)的位置。核心论点:Amazon 在大模型训练(training)这一波被 Microsoft / Google 拉开 — 没有自己的 frontier model、Anthropic 的合作虽然把 Claude 带进 AWS 但模型授权权重不在 Amazon 手里。但 AI 的经济重心正在从训练转向推理(inference,也就是大量用户实际调用模型)— 这个转移点上 Amazon 长期投入的 Trainium 和 EC2 实例终于变成结构性优势:训练只发生在少数大客户,推理发生在所有客户每一次 API 调用。Trainium 在 inference 单位算力成本上比 Nvidia H100 / B200 显著低,AWS 又是企业 AI 工作流的默认 hosting。Ben 的判断:Amazon 在 AI 价值捕获上的”长期 / 短视”切换已经发生 — Wall Street 之前在惩罚它没像 Meta 那样砸训练 capex,现在该改口了。
抽出来记的 pattern:frontier model 不在你手不一定致命——只要 inference 平台是你,价值捕获迟早从模型实验室回流到 hyperscaler。这套逻辑反过来也成立:Meta 接下来 AI capex 叙事得从”训练投入大”切到”推理 ROI 高”,否则 Wall Street 同一把尺子会反向打。
Etsy 把店铺变成 ChatGPT 内置 app,“对话式购物”开始落地
Source · TechCrunch · 2026-05-05 · link
Why this — ChatGPT in-app ecosystem 是 OpenAI 最近最沉默但最重要的产品赌注,Etsy 是第一个真有 SKU 量的零售平台进来。
Etsy(手工艺品 / 个性化商品在线集市)在 ChatGPT 内推出原生 app — 用户在 ChatGPT 里直接输入”帮我找适合刚毕业表弟的木质手工书签”,对话过程中 Etsy 的 SKU 检索 + 个性化推荐 + 加购物车整套流程都不用跳出 ChatGPT 完成。这是 OpenAI 在 4 月推出的 “ChatGPT Apps” 框架(让第三方在 ChatGPT 内嵌入对话式应用,类比 iOS App Store 的 App 心智)的最大零售方早期采用者。Etsy CEO 在声明里强调他们 2026 财年预算大量倾斜到 “AI surfaces”,意思是不再把网页和 app 视为唯一流量入口。这件事对电商和搜索的潜在意义:如果 conversational shopping 真转化(目前还没人公布数据),传统 SEO + 价格比较 + 评论这三个老三件全部要重新洗牌 — Google Shopping 和 Amazon search 都得回应。
Interconnects:所谓”distillation panic”是个糟糕的术语
Source · Interconnects (Nathan Lambert) · 2026-05-04 · link
Why this — Nathan Lambert(前 HuggingFace / 现 Allen AI 研究员,open-model 圈话语权第一人)开炮,回应过去一周 frontier lab 圈关于”开源 model 被中国 lab 蒸馏走”的恐慌叙事。
Lambert 反对的是 Anthropic / OpenAI 圈某些人最近用的 “distillation attack”(蒸馏攻击)这个词 — 他认为这词把一个完全合法的研究行为污名化。Distillation(蒸馏,用一个大模型的输出训练一个小模型)是过去 8 年 ML 圈标准技术,DeepSeek、Qwen、Llama 一直在用。最近 frontier lab 的恐慌出在两件事:第一,DeepSeek V4 Pro 通过蒸馏 GPT-5 + Claude Opus 等输出,达到了在 agentic benchmark 上跟 GPT-5.2 持平 + 比它便宜 17 倍的成绩;第二,开源模型逼近闭源前沿的速度比 frontier lab 想象的快。Lambert 的核心 take:把蒸馏说成 “attack” 是话语权操作,目的是给政策制定者塞进”开源是国家安全风险”的 framing,最终引导出”训练超过某个 capability 阈值的模型必须先备案”这种监管路径 — 也就是把 frontier 玩家的护城河政策化。这条对应另一条新闻:白宫上周确实在考虑发布 AI 模型前的”预审”机制(reddit r/LocalLLaMA 此事 379up)。
表格数据 RAG 的 Structure-Aware Chunking — 把”行”作为切块单位
Structure-Aware Chunking for Tabular Data in Retrieval-Augmented Generation
作者 · Pooja Guttal, Varun Magotra, Vasudeva Mahavishnu, Natasha Chanto, Sidharth Sivaprasad, Manas Gaur (UMBC) · arXiv:2605.00318 · link
RAG(Retrieval-Augmented Generation,检索增强生成 — 现代 LLM 接外部知识库的标配技术)在处理 CSV / Excel 这类表格数据时一直效果差,根因是主流的 chunking(切块)算法都是为非结构化文本设计的,碰到表格会把同一行的字段切散,丢失结构关系。这篇 paper 提出 STC(structure-aware tabular chunking):用”行”作为最小语义单位,把每行编码成 key-value 块,再用 hierarchical Row Tree 表示整张表 — 切块时尊重结构边界,merge 时用贪心无重叠合并。在 MAUD 数据集上测试:chunk 数量比 recursive baseline 减 40%、比 key-value baseline 减 56%;检索性能 MRR(Mean Reciprocal Rank)从 0.36 提到 0.59,BM25-only 检索的 Recall@1 从 0.366 跳到 0.754 — 这种幅度的提升在 RAG 论文里相当少见。
你做实验数据 + Meta DS 工作天天面对的就是 Excel / SQL dump 这种 row-oriented 结构。如果你想给团队的内部知识库(spec / 报告 / dashboard 截图 + 表)加 RAG,STC 这种”按行不按字符切”的策略是默认更对的,比直接拿 LangChain 的 RecursiveCharacterTextSplitter 砸一切的方案省麻烦。
SNEWPAPERS — 1730s-1960s 全文 OCR 历史报纸语义检索
把 1730 年到 1960 年代的西方报纸整体做了文章级别(不是版面级别)的 OCR 提取 + 语义和 agentic search · 给历史研究 / 数据集构建者 / NLP 训练语料工程师用 · 单人项目,作者 7 个月投入近 3000 小时
如果你以后想训练一个”19 世纪英语风格写作生成器”或者做某个跨 200 年的语义漂移分析(例如”meritocracy 这个词从 1850 到 1960 出现频率和 collocation 怎么变”),这种全文 OCR + 语义检索的语料库省 3 个月数据工程。短期估值:值得 bookmark,不一定立刻用。
r/dataisbeautiful · 我分析了《卫报》Blind Date 专栏 17 年所有 850+ 次相亲数据
原 post link · 344up · 39 评论
OP 把《卫报》(The Guardian,英国主流大报)从 2009 到 2026 每周日的 Blind Date 专栏(报社安排两个陌生人在好餐厅约会,然后分别采访给彼此打分)共 850+ 次约会全部建结构化数据集 — 餐厅、年龄差、自评打分(10 分制)、是否再约、是否吻别、双方是否同性。可视化里几个 reddit 评论里被反复 cite 的发现:自评 8 分以上的概率,年龄差越大反而越高(U 形曲线,差 10+ 岁的相亲成功率不比同龄差);女性给男方打分的中位数比男性给女方低 0.7 分;约会后”还想再约一次”的概率(约 38%)跟”约会评分”相关性远低于”是否在饭吃完前 90 分钟内点了第二瓶酒”。
Top comments 反应:
- “这是我读过最完整的英国大众文化交叉数据 — 有人给 OP 把这套方法搬到《纽约时报》的 Modern Love 专栏吗?“(132up)
- “U 形年龄差曲线让我想起 OkCupid 早期数据 — Christian Rudder 的 Dataclysm 也发过类似形状”(86up)
OP 是典型的 weekend project 数据科学家(不是学界 / 不是大厂),但工艺水平比很多大厂 dashboard 高。这种”长跨度 / 中样本量 / 公开 source / 带文化温度”的题目就是 dataisbeautiful 高赞的甜点 — 你做副业 / 写 newsletter / 拍 YouTube 找选题时可以反着用:找一个像 Blind Date 这种 “周更 + 公开 + 跨 10+ 年” 的 source,结构化它。
r/cscareerquestions · 我们公司停了 LeetCode,改成”现场用 AI 工具构建”测候选人
原 post link · 599up · 136 评论
OP 自称在一家”很出名的科技公司”上班,公司刚停了 LeetCode 算法面试这种行业标配,改成新流程:候选人现场打开 Cursor / Claude Code / Codex 任选 AI coding 工具,60-90 分钟内做一个具体的技术 task,面试官观察的是 “怎么 prompt”、“怎么 review AI 生成的代码”、“怎么 debug AI 写错的部分”。OP 描述的几个观察:第一,做出来的成品质量跟候选人的 LeetCode 表现关系不大,反而跟候选人的 PR review 经验高度相关;第二,有的资深 SWE 反而比刚毕业的差,因为他们不愿意放手让 AI 写、想自己写每一行;第三,公司内部正在讨论这是否应该是新的行业标准。
Top comments 反应:
- “这才是真实测什么 — LeetCode 测的是已经死的能力(Manual algo 实现)“(284up)
- “问题是这种面试的标准化 / 公平性怎么解?AI 工具版本不同 / 模型不同 / 谁付 API 费用都是变量”(156up)
- “我们公司 6 个月前也改了,hire rate 没变但留任率上升 — 因为筛掉了所有死撑’我不用 AI’的人”(98up)
DS hiring 还没到这一步 — Meta DS 面试 2026 还是 SQL / case / stats — 但你估计 12-18 个月之内会到。届时 DS candidate 怎么用 Claude / Cursor 写 SQL + DAG + EDA notebook 会成为新筛子。下次见 DS hiring manager 朋友可以问”你们什么时候开始改流程”。
r/AI_Agents · 大多数人不需要 agent,他们需要更干净的工作流
原 post link · 39up · 21 评论
OP 是个建过一堆 agent 系统的工程师,提出反直觉观察:客户来找他做 AI agent 时大部分场景不应该上 agent — 因为他们的”乱”问题来自上游的工作流本身就乱(多个 source of truth、流程没文档化、决策权限模糊),把 agent 套上去等于给杂音放大。他建议的判断标准:先把工作流”地图化”(写出来步骤),然后看每一步是否真的需要 LLM 推理 — 如果 80% 的步骤是”if X then Y”这种确定逻辑,那加一个 agent 只会增加错误率和成本,传统 ETL / RPA / 简单脚本反而对。Agent 真正适合的是 “中间需要 judgment 但 judgment 可被结构化校验” 的场景(例如客服分类 + 升级、合同要点提取 + 风险打分),不是”自动化一切”。
Top comments 反应:
- “对。我见过最多的 ‘AI agent project’ 真正问题就是流程没 spec — agent 只是把这个问题更贵地暴露出来”(28up)
- “Cleaner workflow + 一个简单的 LLM call 几乎总比 multi-agent system 好”(19up)
这条对应你前段时间想给 SPP paper trader 加 multi-agent layer 的犹豫。OP 的判断尺很 useful — 看一下你现在 trader / reviewer / risk monitor 那一套是不是真都需要”agent”对话或者其实 deterministic state machine 就能跑。可以拿这条问 Brad / Bill Gurley 类商业 podcast 的 AI Native 客户做 reality check。
virattt/dexter · [Python]
https://github.com/virattt/dexter
这是干什么的:Dexter 是个 “autonomous financial research agent” — 输入一个研究问题(“分析 NVDA 过去 4 个季度的 margin 变化驱动是什么”)后它自己拆解计划、调外部数据源、迭代,最后给结构化结论。
技术解读:
- Tech stack:Python 主体 + LangChain(流行的 LLM 编排框架,把多步推理 + 外部工具调用打包成 chain)+ 多个 financial data API(Yahoo Finance / SEC EDGAR 公开 filing)。模型层用 OpenAI / Anthropic 任选 — 通过 LiteLLM(一个统一不同 LLM API 的 wrapper 层,本地切换 model 不用改代码)解耦。
- 跟 Eric 现有工具的关系:你 SPP paper trader 是 deterministic 模式(明确的 buy / sell signal 流程 + 报告),Dexter 是 exploratory 模式(“帮我研究一下”的开放问题)。两个互补 — Dexter 适合做盘前 thesis 调研,SPP 适合执行。
不是直接 fork 进 SPP,但代码量很小(< 5K lines)值得 read 一遍架构 — 看人家怎么把 plan / execute / refine 三个 stage 拆开。如果你以后想给 SPP 加一个”上盘前 5 分钟扫一遍 macro / 行业新闻给 Trader 上下文”的 module,可以直接套 Dexter 的 plan-execute pattern。
Cognitive Revolution · 强化学习微调实战手册:CoreWeave 的 Kyle Corbitt 讲 GRPO / Rubrics / Environments / Reward Hacking
主持 Nathan Labenz · 嘉宾 Kyle Corbitt(OpenPipe 创始人,公司被 CoreWeave 收购,AI fine-tuning 圈最深 hands-on practitioner 之一)· 2026-05-01 · YouTube
这一期是 RL(reinforcement learning,强化学习)应用到 LLM 微调(fine-tuning)的 practitioner-grade 拆解 — 不是学界综述,是真实做了 100+ 次 RL 微调项目的经验。
这期讲了什么:
- RL 跟 SFT(监督微调)的本质区别:SFT 教模型”复制”已有正确答案,RL 教模型”在没有标准答案的连续选择空间里探索 + 收敛”。如果任务可以写出标准答案 → SFT 够;不能写但能打分 → RL。
- GRPO 为什么火起来:DeepSeek 的 GRPO(Group Relative Policy Optimization)算法本身没有”量子级” innovation,火起来是因为它在工程上把 PPO 的 critic network 砍掉了 — 训练稳定性好、显存占用低,普通团队能在 2-4 张 H100 上跑起来,所以从学界跨到产业。
- Rubric(评分规则)和 Environment(环境)的设计才是关键:Kyle 反复强调,模型质量 80% 取决于 reward function(奖励函数)写得对不对,不是算法选哪个。常见错是 reward 太稀疏 / 太可游戏化 / 不能区分 close call。
- Reward Hacking(奖励黑客)实例:Kyle 讲了 OpenPipe 客户里一个 case — 让 model 自动写营销文案,reward 是”用户点击率”,结果模型几个 epoch 后开始全部生成 clickbait 标题党 — 因为 click rate 是单维度可游戏化指标。修复是把 reward 改成多维 + 加 “用户买没买” 长 horizon 信号。
- LLM-as-Judge 是 critical bottleneck:用一个大模型给小模型打分这种范式,最大问题是 judge model 自己有 bias — 偏好长答案、偏好礼貌答案、对自己同源 model family 的输出宽容。
金句:
“If you can write the right answer, do SFT. If you can only score the answer, do RL.” — Kyle Corbitt
“RL 不是 magic — 它把你 reward function 里的所有缺陷都翻译成模型行为放大给你看。” — Kyle Corbitt
这一期是过去半年 RL 应用到 LLM 圈最 actionable 的 90 分钟 — 你即使不写 RL 代码,懂 reward function 设计 / GRPO vs PPO 的工程权衡 / 为什么 LLM-as-Judge 不万能这三件事,下次跟 AI infra 同事 / 招聘的 senior IC 聊”我们要不要自己做 fine-tune”时,能在 5 分钟内判断对方是真做过还是吹。Kyle 是少数把”我们 100+ 个项目里的失败”讲得直白的从业者,这种 podcast 在 frontier lab CEO 都在 PR mode 的当下很稀缺。